8.1 实时性优化与DDS调优
8.1 实时性优化与 DDS 调优
本节摘要:控制环的抖动是产线部署最常见的技术难关:仿真里丝滑的运动到真机上开始颠簸,日志里查不出任何错误。本节给出系统化的解法:先把"延迟"拆成可预算的四段,再逐段兑现——实时内核、调度策略、内存锁定、锁纪律,最后落到 DDS 层的三个调优旋钮。这是全册工程含量最高的一节,也是第 6 章控制环在产线上的续集。
实时不是快,是可预期
先纠正一个普遍误解:实时性的含义不是"越快越好",而是最坏情况有界。平均延迟 2 毫秒但偶尔跳到 80 毫秒的系统,比稳定 5 毫秒的系统更不"实时"——控制环怕的是那一下 80 毫秒:轮子已经转过去了,指令才到。所以实时优化的一切手段都在做同一件事:消灭长尾,而不是压缩均值。
一、延迟预算:把"卡顿"翻译成四段账
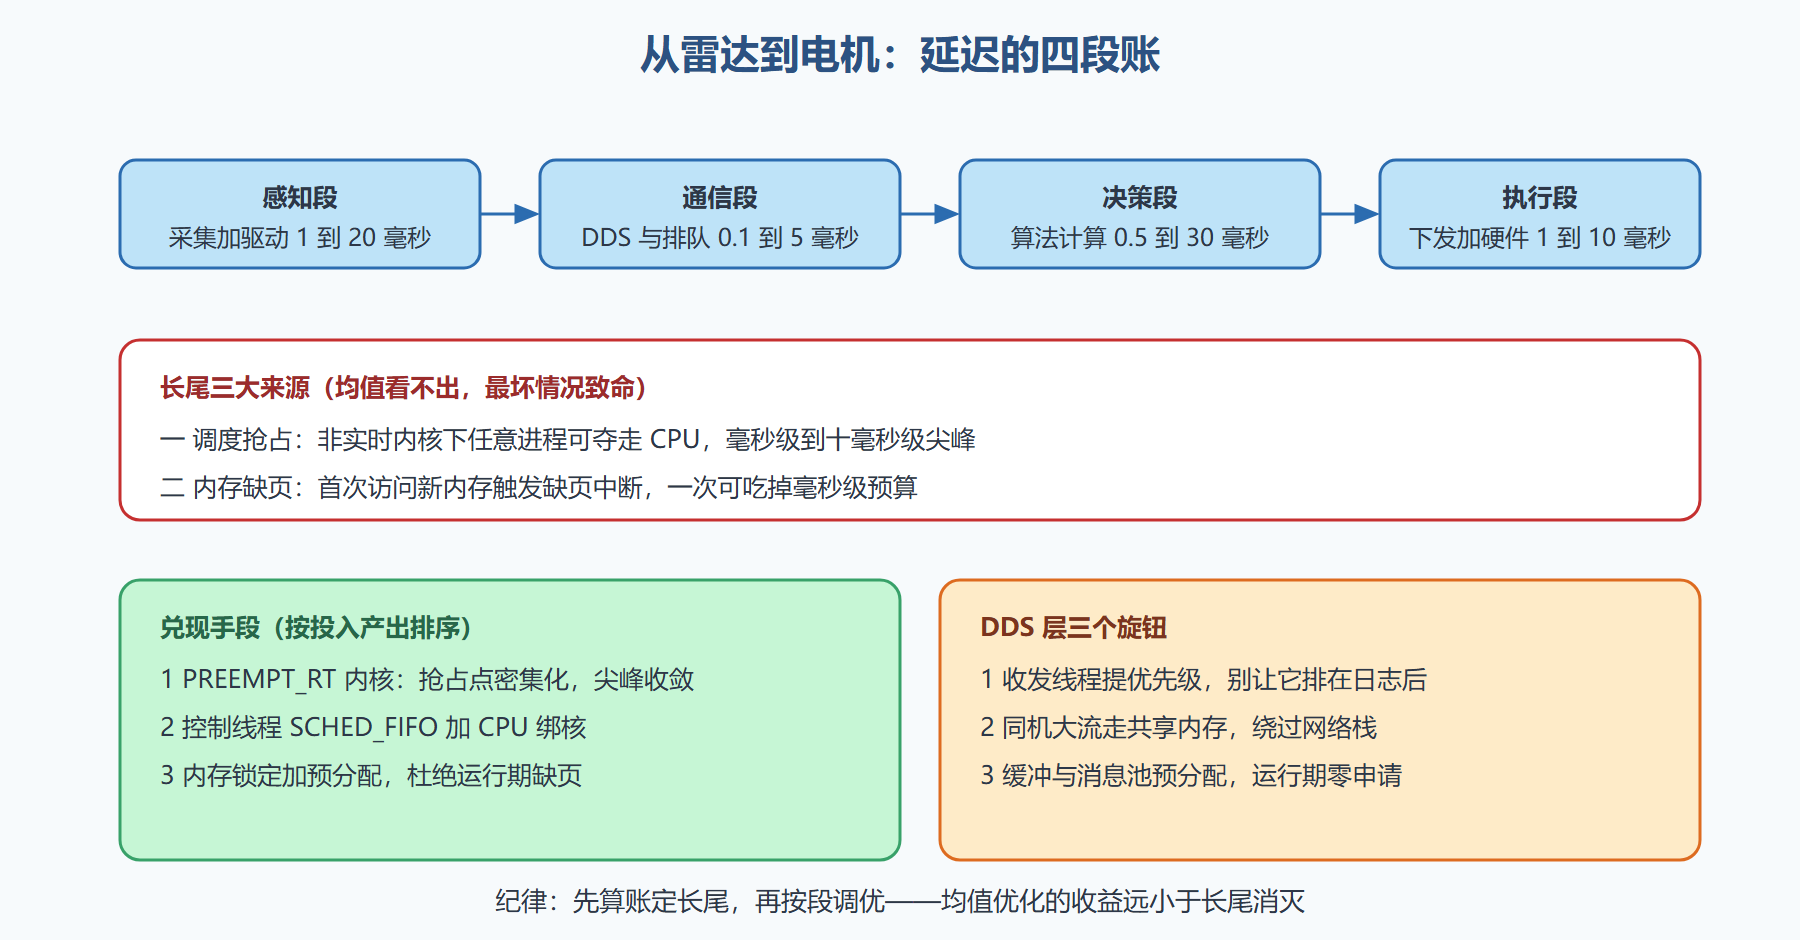
拿到"控制环抖动"的问题,第一步不是调优,是算账——把从传感器到电机的端到端延迟拆成四段:
| 段 | 内容 | 典型量级 | 主要来源 |
|---|---|---|---|
| 感知段 | 传感器采集加驱动处理 | 1 到 20 毫秒 | 扫描时间、驱动缓冲 |
| 通信段 | DDS 传输与回调排队 | 0.1 到 5 毫秒 | 序列化、调度延迟 |
| 决策段 | 算法计算 | 0.5 到 30 毫秒 | 算法复杂度 |
| 执行段 | 指令下发到电机响应 | 1 到 10 毫秒 | 通信段加硬件 |
账算出来,长尾藏在哪一段一目了然。多数"莫名抖动"的账单长这样:感知段与决策段均值正常但方差大(其他进程抢 CPU),通信段偶发尖峰(回调被排队)。预算表的意义在于把优化瞄准长尾所在的那一段,而不是全面撒网。
图 8-1:控制环延迟预算与长尾来源
二、兑现手段:内核、调度与内存
第一层:实时内核。 标准 Linux 内核的抢占粒度粗——一段内核态操作期间不可被打断,任何普通进程都可能让控制线程等上十几毫秒。PREEMPT_RT 补丁把抢占点密集化,让高优先级线程几乎随时能夺回 CPU。装了实时内核后,典型控制环的最坏延迟从十几毫秒收敛到亚毫秒级,这一步的收益超过后面所有软件微调的总和。
第二层:调度策略与绑核。 有了实时内核,还要告诉系统"控制线程是贵客":
# 让控制线程用实时调度策略 FIFO,优先级 80 sudo chrt -f 80 ros2 run my_bot controller_node # 顺带隔离核:把 2 号核从普通调度里摘出来专供控制线程 sudo isolcpus=2 ...
第三层:内存纪律。 运行期申请内存可能触发缺页中断——一次毫秒级的"意外"。对策是在控制线程启动时锁定已分配内存并预分配运行期要用的消息对象与缓冲。C++ 侧的惯用法是消息对象池:循环里复用预分配的消息,发布路径上零动态申请。
锁纪律回到第 3.1 节的回调组:实时路径上的互斥锁是延迟尖峰的常见来源(持锁者被抢占,等待者跟着遭殃)。能靠回调组隔离解决的,不上锁;必须共享的,用无锁结构或把共享面缩到最小。自旋等待在实时路径上同样危险——它占着 CPU 空转,同核的其他要紧任务被饿死。
三、DDS 层调优与验证闭环
软件栈调完后,剩下通信段的尾巴交给 DDS 配置。以 Cyclone DDS 为例的三个旋钮:
<!-- CycloneDDS 配置片段:线程优先级与共享内存 --> <CycloneDDS> <Internal> <SocketReceiveBufferSize min="10MB"/> </Internal> <ThreadPriorities> <DefaultPriority>70</DefaultPriority> <!-- 低于控制线程,高于普通进程 --> </ThreadPriorities> </CycloneDDS>
旋钮一是收发线程优先级:DDS 的网络线程默认与普通进程同级,控制指令的传输会被日志、上传这类"闲人"排队——提到中间优先级即可。旋钮二是共享内存传输:同机大数据流走共享内存后,拷贝与系统调用开销消失,通信段的均值与方差双降。旋钮三是缓冲预分配:接收缓冲按峰值流量配足,内核缓冲不足时丢包重传就是毫秒级尖峰的稳定来源。
调优不是改完就信,验证闭环用第 7 章的工具:topic hz 看频率稳定性,自定义的耗时统计话题看回调执行间隔的分布——重点看最大值与分位数,不看均值。改一轮、测一轮,直到最坏延迟落进预算。
⚠️ 常见坑:实时优先级设太高会饿死内核线程,系统出现"控制稳了但网络、SSH 全瘫"的怪象。实时优先级是稀缺资源,只给真正的心跳路径,等级安排是控制高于通信高于一切。
四、测量先行:一次控制环抖动的完整调优记录
方法论讲了三层,用一份真实的调优记录看它们如何按序兑现。现场:六轮巡检机器人,控制周期 20 毫秒,试运行反馈"原地转向时明显顿挫"。
第一步算账:在雷达回调、控制回调、指令发布三处打时间戳,采集十分钟。账单显示:感知段均值 8 毫秒、最大 71 毫秒;通信段均值 0.6 毫秒、最大 12 毫秒;决策段稳定。长尾在感知与通信两段,均值都正常——典型的调度抢占特征(长尾与均值脱节是抢占的指纹)。
第二步分层兑现:装实时内核,感知段最大值从 71 降到 9 毫秒;控制与雷达回调分组隔离(3.1 节),通信段最大值从 12 降到 2 毫秒;控制线程提到实时优先级并锁内存,最终全链路最大延迟 11 毫秒,落进 20 毫秒周期的一半预算线。转向顿挫消失。
第三步验证固化:把延迟分布的测量脚本做成常规巡检项,每次发版跑一次基线对比。三个月后某次依赖升级让长尾悄悄回升到 25 毫秒,基线对比当场抓获——那时离用户感知到顿挫还有两周。
这份记录的复用价值在三处:顺序不可颠倒(先测量后动手,跳过算账的调优都是赌博);每层收益单独验证(合在一起改,你永远不知道是哪层起效,下次该省哪层);基线要变成资产(调优结果不固化成巡检项,半年后一切归零)。实时性不是一次优化,是一条要持续看守的预算线。
本节要点回顾
- 实时即可预期:优化的目标是消灭长尾,不是压缩均值;
- 先算延迟预算再动手:四段账单定位长尾,避免全面撒网;
- 三层兑现:实时内核收益最大,调度绑核其次,内存锁定与预分配收尾;
- DDS 三旋钮:线程优先级、共享内存、缓冲预分配,专治通信段尾巴;
- 验证看最坏值与分位数:topic hz 加耗时分布,改一轮测一轮才算调优。
时间关过了。下一关是信任:产线网络里的 ROS2 通信凭什么可信。