6.1 模型数据字典
6.1 模型数据字典
本节摘要:数据字典把模型参数与信号定义从工作区的"临时居所"搬进有制度的数据层:变量有定义、有校验、有变更记录,多个模型共享同一份事实。本节讲清基础工作区、模型工作区、数据字典三层存储的职责与优先级,演示多模型团队如何分区管理,并给出从现有项目迁移到字典的完整步骤。第 4、5 章反复出现的"参数集中管理",在本节完成制度化收官。
险情复盘:一次没有痕迹的修改
开篇的主线险情值得完整复盘一遍,因为它展示了无制度状态下的全部症状。修改发生在画布对话框里——不像改脚本会留下版本差异;影响的是 5.2 节交叉验证过的两版模型——影响范围横跨多个文件;发现时间在两周后的报告评审会上——修正成本已经从一次撤销变成一次三方对质。三个症状对应字典制度的三项能力:变更留痕、跨模型一致性、尽早暴露。
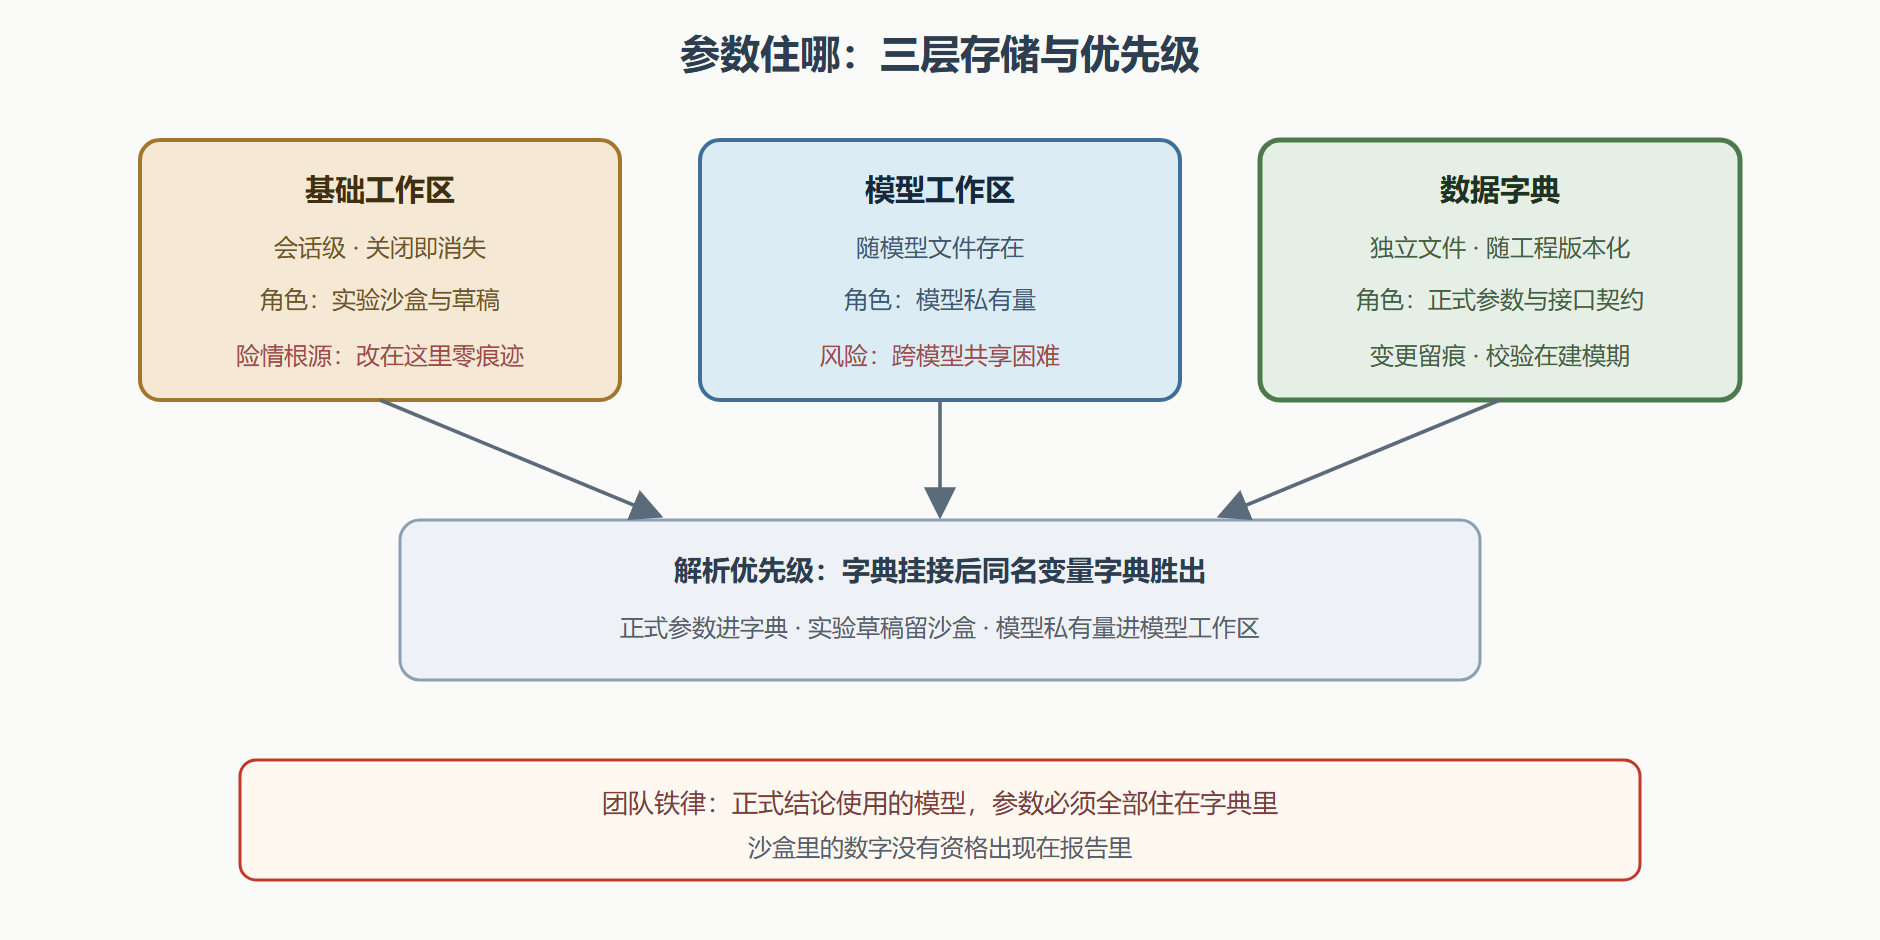
先立好三层存储的职责表,再谈怎么用。
| 存储层 | 生命周期 | 适用内容 | 风险 |
|---|---|---|---|
| 基础工作区 | 会话级,关掉就没 | 快速实验、临时试探 | 痕迹全无,正是险情温床 |
| 模型工作区 | 随模型文件 | 模型私有、无共享需求的量 | 跨模型想共享时挖不出来 |
| 数据字典 | 独立文件,随工程版本化 | 正式参数、信号接口、校验 | 需要初始设置纪律 |
优先级规则一句话:字典挂在模型上之后,同名变量字典说了算,工作区同名变量被忽略。这条规则是制度的核心——团队可以放心地让字典接管正式参数,而基础工作区退化成"沙盒",里面只有尚在试错的草稿。
图:数据三层存储与解析优先级
团队分区:一套字典管多模型
第 4、5 章攒下的模型群(轻量框图版、物理网络版、状态机版)正好演示分区策略。共享字典放跨模型事实:电机铭牌参数、额定值、物理常数——任何一版模型引用的都是同一份定义,5.2 节"两版并存"的一致性承诺由此兑现。模型私有分区放只属于单模型的量:物理网络版特有的接触电阻、状态机版特有的阈值——用字典的引用模型分区或独立子字典隔离。实验分区放敏感性分析、参数扫描的批量变量,实验结束整体归档或清除,不污染正式定义。
操作层面的最小命令集:
% 建字典并挂接到模型 dict = Simulink.data.Dictionary.create('motor_project.sldd'); set_param('motor_speed_loop', 'DataDictionary', 'motor_project.sldd'); % 写入带元数据的参数定义(类型、上下限、描述一并提供) J = Simulink.Parameter(3.6e-4); J.DataType = 'double'; J.Min = 1e-5; J.Max = 1e-2; J.Description = '折算转动惯量 kg*m^2,含减速机构折算,2026-07 实测修订'; dict.addEntry('J', J); % 变更审计:字典自带的比较工具可对比任意两个版本的定义差异 % 并行实验前,各工作进程调用字典的独立访问接口,避免写冲突
校验与迁移
校验把两类错误拦在建模期。类型与边界校验:给 J 限定合理上下限后,手滑输入 3.6e-1 会被立刻标红,而不是在仿真曲线里若无其事地产生一个偏大十倍的惯量。单位一致性:参数描述里写明物理单位,配合检查器能发现"转速有的地方用弧度每秒、有的地方用转每分"这类经典混搭——它不报错,但所有频率域分析全部失真。
迁移老项目到字典,四步走稳:第一步盘点,用模型资源管理器列出全部参数及当前来源;第二步分层,按职责表把参数归入共享、私有、实验三区;第三步建字典写入定义并挂接,逐模型切换后跑回归仿真,结果与迁移前一致才勾掉一个模型;第四步封路,在模型回调里加入"发现基础工作区同名变量即警告"的哨兵,防止旧习惯回潮。整个迁移在小规模项目上是一天内的事,收益从第二个模型开始复利。
💡 关键直觉:字典的价值曲线是凹向后的——第一个模型用它,感觉只是多了一道手续;从第二个模型起,"改一处、处处生效、处处有痕"开始兑现;到测试与代码生成阶段(第 7、8 章),参数可追溯成了合规刚需,字典从便利变成门槛。
多人协作:字典的并行与冲突
字典从个人工具变成团队工具时,多出一个经典问题:两人同时改字典怎么办。工程化的解法分三层。分区先行:按前文的共享、私有、实验三区分割后,绝大多数编辑天然落在不同分区,冲突面已经最小化——这是零成本的预防。提交粒度:字典文件纳入版本管理后按 10.2 节的粒度纪律提交,参数定义的每次变更带说明与关联的实验编号,审计时按图索骥。临时副本实验:需要大改参数做敏感性分析时,复制一份实验字典挂到工作副本上跑,实验完把结论对应的定义变更合回主字典——原始定义全程无人动过,主线始终干净。
并行仿真还有个进程级细节:多个工作进程同时访问同一字典会写冲突,仿真集群的正确姿势是每个进程持独立副本(只读场景直接只读挂接)。这类细节单次配置十分钟,出问题排查一下午——值得写进团队的实验手册。
常见问题
问:字典和 MATLAB 脚本管参数,到底选哪个?
按团队规模与模型数量分水岭。一两个模型、一两个人,脚本管参数完全够用,别为制度而制度;三个以上模型、两个以上维护人,脚本的一致性与审计短板开始收费,迁移字典的收益转正。判断口诀:当"这个参数到底在哪定义的"成为团队高频问题时,就该迁了。
本节要点回顾
- 三层职责:基础工作区是沙盒、模型工作区放私有、字典管正式,同名时字典胜出;
- 险情的解法是制度:变更留痕、跨模型一致、建模期校验,让遗忘变得无害;
- 分区策略:共享字典放跨模型事实,私有分区隔离特有量,实验区用后归档;
- 参数带元数据:类型、边界、单位、描述,校验与审计的抓手全在这里;
- 迁移四步:盘点、分层、切换加回归、封路设哨兵;
- 价值凹向后:第二个模型起复利,第 7、8 章的可追溯需求把它变成硬门槛。
数据有了制度,操作该提速了。下一节把重复劳动交给脚本:从画布操作到批量实验的全链路自动化。