7.2 动态测试与覆盖率分析
7.2 动态测试与覆盖率分析
本节摘要:动态测试让模型跑起来接受检验,覆盖率把"测试得够不够"变成可量化的指标。本节讲清覆盖率从语句级到条件决策级的递进含义,演示测试评估与等效性测试的实操,并把第 5 章状态机的迁移表升格为用例生成源。读完本节,"差不多了"将被"决策覆盖达标、缺口清单已闭环"取代。
"测得差不多了"为什么不算数
小林把保护逻辑的测试做了三十多个用例,验收方问的第一句话是:"这些用例覆盖了所有迁移与分支吗?"她答不上来——测试用例的数量与测试的充分性之间没有必然联系。三十个用例可能全挤在正常态与告警态之间打转,切断态的进入路径一次都没触发过。覆盖率分析就是回答这个问题的工具:它记录仿真过程中模型的哪些部分被执行过,用执行统计反推测试缺口。
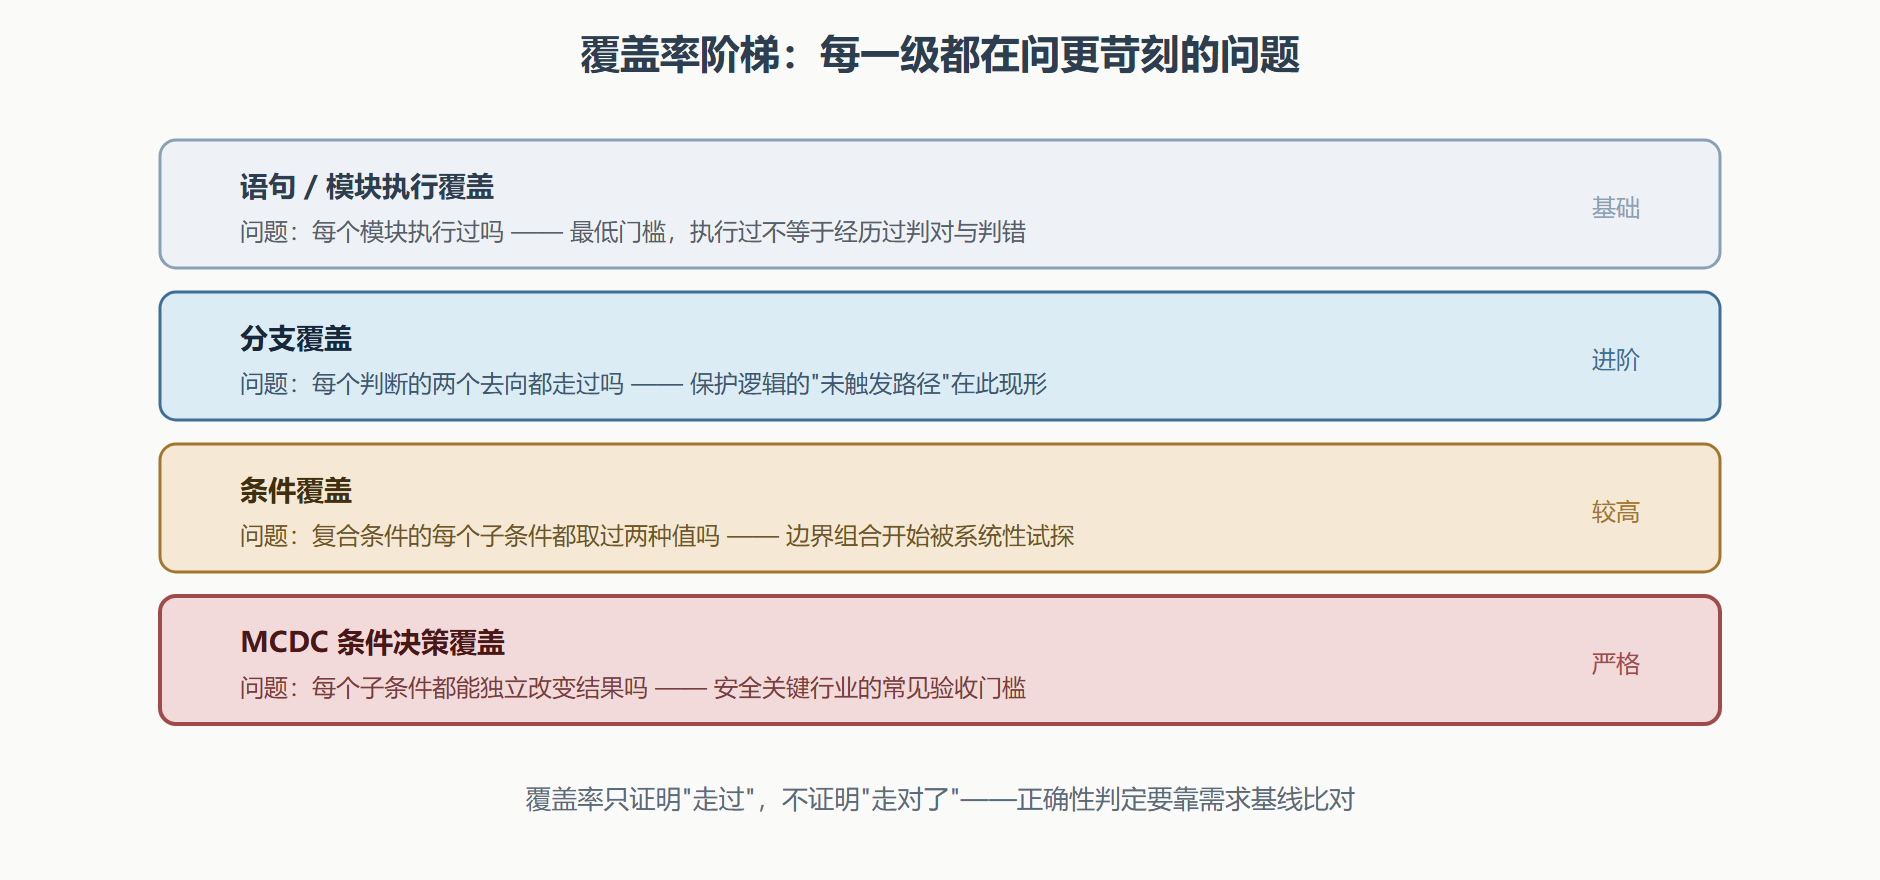
覆盖率的层级递进是本节的第一个知识点。语句覆盖(在 Simulink 语境里常对应模块执行覆盖):每个模块至少被执行一次——最弱的门槛,执行过不代表判对判错都经历过。分支覆盖:每个判断的true与false两个去向都走过。条件覆盖:复合条件(电流超限 且 计时满)里的每个子条件都取到过两种值。条件决策覆盖 MCDC:每个子条件都被证明能独立改变整体判断的结果——安全关键行业的常见门槛。层级每升一级,用例要求越苛刻,暴露的缺口越细。
图:覆盖率层级与用例需求递进
实操:覆盖率、基线比对与等效性测试
覆盖率实验走一遍完整闭环:开覆盖率采集、跑用例集、读报告、把缺口转成新用例。小林的保护逻辑第一次报告显示:分支覆盖 87%,缺口集中在切断态的三条离开迁移——三十个旧用例没有一个让告警持续满 50 毫秒。补三个用例(恰好是 5.1 节迁移表的三条切断相关迁移),覆盖率到 100%,缺口闭环。这正是 5.1 节说的"迁移表是测试骨架"的兑现:从规格表生成用例,缺口天然最小化。
基线比对回答"结果对不对":为关键信号建立参考基线(需求方认可的正确行为记录),每次测试把结果与基线逐点比对,超差即失败。基线本身要有治理——需求变更时基线同步修订并留痕,否则基线会从"事实标准"腐化为"历史包袱"。
等效性测试回答"改完之后变没变":模型重构、参数迁移(6.1 节的字典迁移)、求解器更换(3.2 节的换求解器复跑)之后,新旧版本在同一激励下逐点对比。它是重构安全网,与 3.4 节的收敛性检查共同构成"改动后结果可信"的双保险。
% 覆盖率实验与等效性测试的驱动脚本 load_system('motor_protection'); % 1) 开覆盖率采集并执行用例集 set_param('motor_protection', 'Coverage', 'on'); set_param('motor_protection', 'CovEnable', 'on'); % 依次执行用例脚本:case_normal / case_warn / case_cutoff ... run_case_suite(); % 项目自定义:批量执行用例并返回结果对象 % 2) 生成报告,读分支与 MCDC 缺口 % 报告按子系统列出未覆盖的迁移、分支与条件组合 % 3) 等效性测试:字典迁移前后逐点对比 out_old = sim('motor_speed_loop_legacy', 'StopTime', '1.0'); out_new = sim('motor_speed_loop', 'StopTime', '1.0'); y1 = out_old.w_log.Data; y2 = out_new.w_log.Data; assert(numel(y1) == numel(y2), '输出点数不一致,先对齐时间网格'); max_err = max(abs(y1 - y2)) / max(abs(y1)); fprintf('迁移后最大相对差 %.4f%%\n', max_err*100); assert(max_err < 1e-3, '等效性不达标:迁移引入了行为变化,禁止合并');
把缺口变成资产
覆盖率报告的用法决定了它的价值。低级用法:把达标当目标,补几个"为覆盖而覆盖"的用例糊满指标。高级用法:把每个缺口翻译成一个"这个路径为什么从没被走到"的追问——有的缺口暴露用例设计盲区(补用例),有的暴露规格歧义(回修需求),有的暴露死代码(删模型)。小林的切断态缺口属于第一类;团队里另一次覆盖率分析揪出过一个永远不可达的状态(第二类,规格里写了两个互相矛盾的条件),这就是"缺口是资产"的含义。
测试充分性还有一个容易忽略的维度:时间维度的极端。仿真时长、事件间隔的边界(如保护逻辑恰好在采样节拍边界翻转)往往不在常规用例的时间窗内。给用例集固定加两类时间边界用例——最短持续与最长持续——能堵住一大类"短测通过、长跑出事"的窟窿。
💡 关键直觉:覆盖率是温度计不是药方。它告诉你哪里没测到,不告诉你测到的对不对,更不告诉你该怎么治。指标达标只是这场对话的开始。
常见问题
问:覆盖率百分之百就等于测试充分了吗?
不等于,差着两层。第一层,覆盖率不看数值的正确性——每个分支都走过,走过时结果对不对它不管,对错判定要靠基线比对。第二层,覆盖率不看用例的"物理分布"——所有分支都覆盖了,但输入可能全挤在额定工况附近,极端温度、老化参数、边界供电的组合仍然空着。所以行业实践把覆盖率当作"不充分的红灯",而不是"充分了的绿灯":未达标一定不充分,达标了还要过基线比对与边界用例两道检查。
问:用例集越滚越大,回归一次要几小时,怎么办?
按风险分层。冒烟层:十个以内最快的关键用例,每次提交必跑;回归层:全量用例,每夜跑;全检层:覆盖率采集打开的完整评估,里程碑前跑。再配合两件提速器——并行执行(用例天然独立,多核直接分)与仿真加速模式(结构未变时重用编译产物)。分层的原则与 7.1 节一致:把最贵的检查留给最关键的节点,日常用便宜的兜底。
本节要点回顾
- 数量不等于充分性:覆盖率用执行统计反推缺口,让"测够了"变得可审计;
- 四级阶梯:语句、分支、条件、MCDC,层级越高对用例的试探性要求越苛刻;
- 规格即骨架:从状态机迁移表生成用例,缺口天然最小化;
- 三种测试各有分工:覆盖率找缺口、基线比对判对错、等效性测试护改动;
- 缺口三出口:补用例、修规格、删死代码,每条都要闭环而不是糊指标;
- 时间边界必测:最短与最长持续两类用例固定进入用例集。
行为的覆盖解决了,还有一类风险测试永远兜不住:那些"没试到的那一次"恰恰会出事的场合。下一站的形式化验证正面回答它。