2.2 核心执行流程
2.2 核心执行流程
本节摘要:追踪一条任务从 YAML 文本到远端系统调用的完整生命线:解析、变量渲染、策略调度、连接执行、通知处理、汇总退出。重点讲透三个最容易误解的机制——变量按 play 粒度预先渲染、handlers 延迟触发、strategy 与 serial 的调度语义。
生命线六站
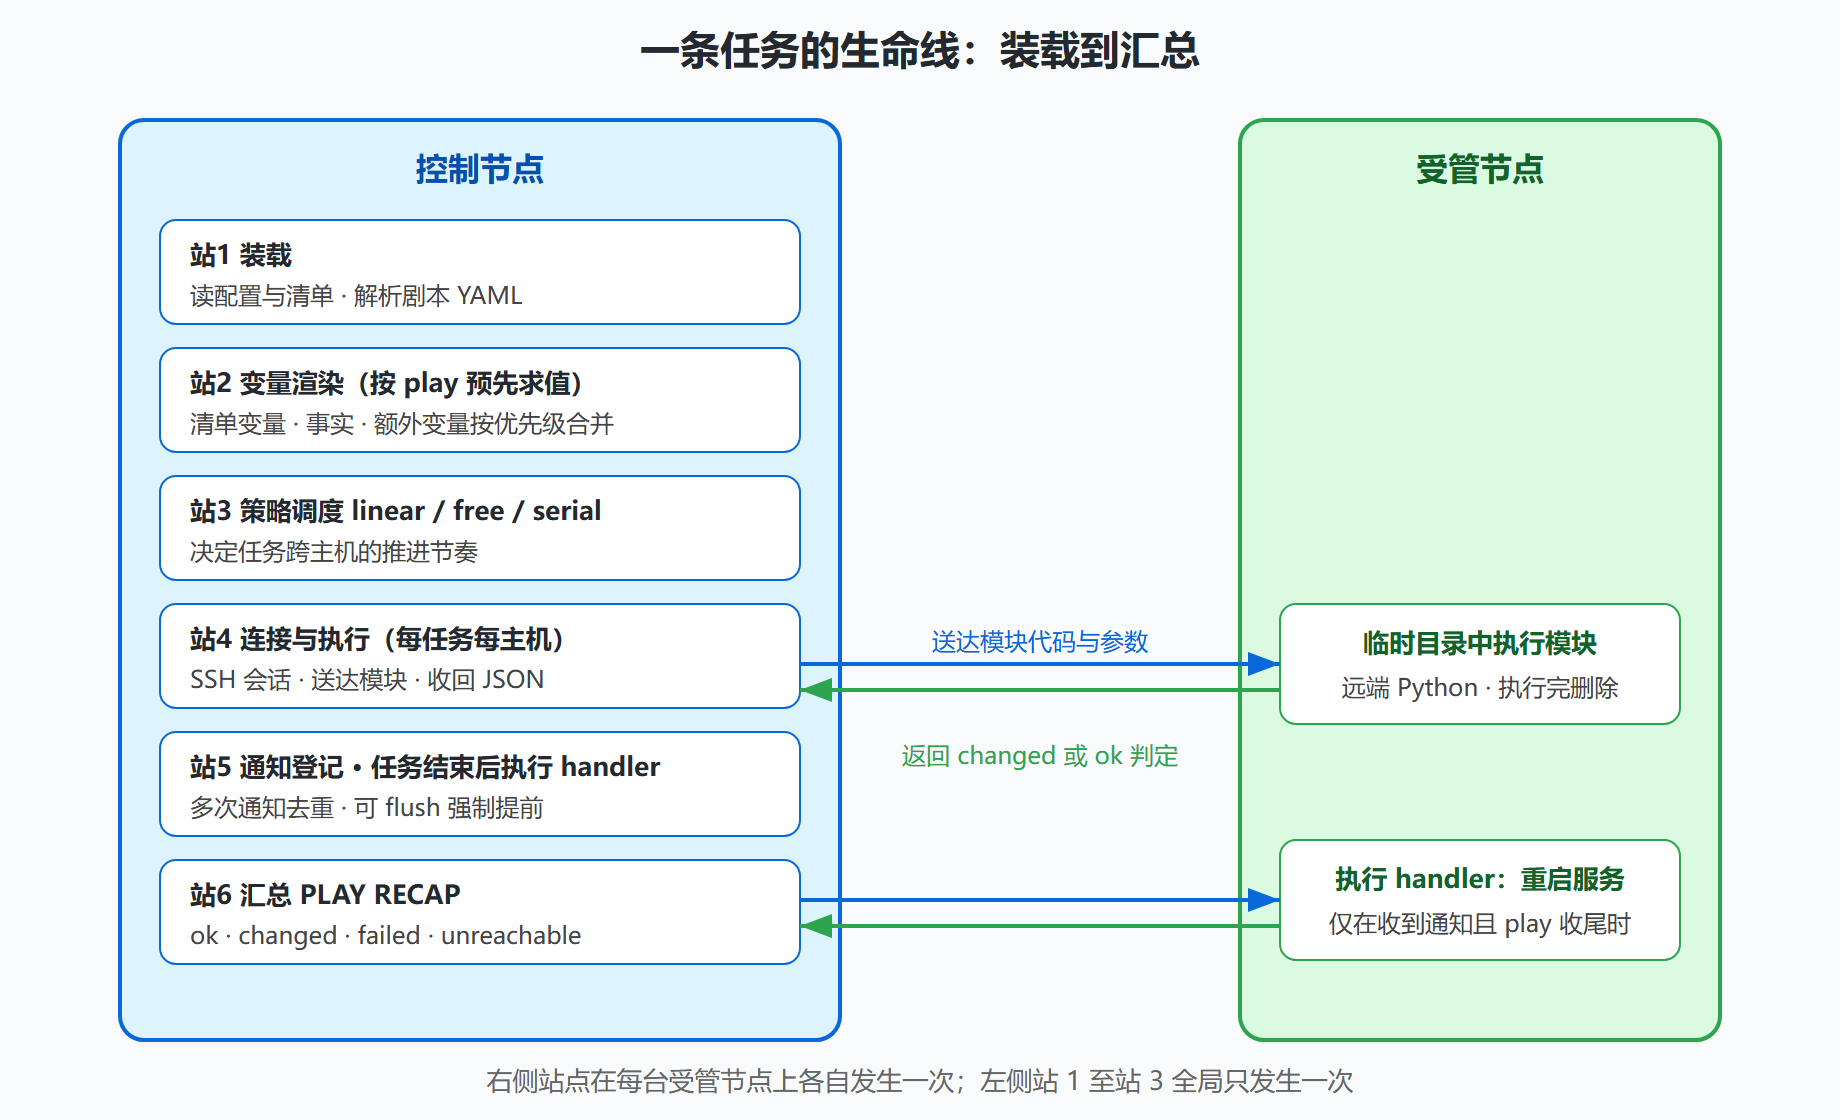
第一站,装载。引擎读取配置、清单与剧本文件,把 YAML 解析成内部对象;此时还没连接任何主机。清单解析错误、YAML 语法错误都在这一站暴露,特征是进程几乎瞬间退出且报错信息指向文件与行号。
第二站,变量渲染。引擎按 play 为单位做变量合并:剧本内变量、清单变量、事实变量(Facts)、额外变量(-e 传入)按优先级融合成每个主机各自的变量视图,随后用这个视图渲染该 play 的任务模板。关键点是渲染时机——一个 play 的全部模板表达式在进入任务执行前就基本完成求值,而不是执行到某任务时才现场求值。这解释了一个经典现象:在循环里用 set_fact 修改的变量,同 play 内后续任务的模板引用有时"看不到"新值——因为渲染已经发生。绕过手段是让引用发生在任务执行期才求值的构造里,比如 vars_files 延迟加载或 lookup 插件。变量优先级的完整排序表留到 3.4 节,本节记住"渲染有时刻"这个概念即可。
第三站,策略调度。默认线性策略(linear)的语义是:每个任务要等上一批主机全部完成才整体推进——快的主机等待慢的。另一种 free 策略让每台主机独立推进,互不等待,适合任务间顺序依赖弱的场景;host_pinned 兼顾两者。serial 关键字在 play 层面切批次,例如 serial: 2 表示每次只对两台主机执行整个 play,失败超出容忍阈值就终止后续批次——滚动发布的基石,第 6.5 节的复盘会实际用到它。
第四站,连接与执行。对每台主机,引擎通过 SSH 建立会话,把模块参数序列化后连同模块代码送达远端临时目录,远端 Python 执行后返回 JSON。这里的性能关键参数是 SSH 管道(pipelining):开启后省去远端临时文件的多轮传输,任务密集的剧本提速明显;代价是部分受控环境的 sudo 配置需要同步调整(关闭 requiretty)。
第五站,通知与收尾。任务标记 changed 且定义了 notify 时,引擎把对应 handler 记入待执行清单——注意是"记录",真正的执行要等该 play 的普通任务全部跑完。这个设计的用意是效率与一致性:一个 play 内十次配置修改只触发一次服务重启。需要立刻执行时用 meta: flush_handlers 强制冲刷。被通知的 handler 自身也遵循幂等规则,且一个 handler 只会进一次队列,多次 notify 不重复执行。
第六站,汇总。全部 play 结束后输出 PLAY RECAP:ok、changed、failed、unreachable、skipped、rescued、ignored 七个计数。把 RECAP 当作每次运行的健康摘要来读——自动化流水线里它是比"命令是否退出码为零"更细的信号,很多 CI 集成会检查 failed 与 unreachable 是否为零。
用一张时序图固化理解
下面这张图把六站压缩成两泳道视角:控制节点上的编排动作,与单台受管节点上发生的事。注意 handlers 的位置——它在普通任务全部结束后才出现。
图 2-2:一次 play 执行的完整时序
两个机制导致的经典事故
事故一,"变量改了但不生效"。有团队在同一个 play 里先用 set_fact 按环境算出发布目录,再在后面的任务里引用,结果引用到的永远是旧值——如前所述,模板在渲染期已求值。修正方式是把这种"运行期才能确定"的值延后求值,或者拆成两个 play(第二个 play 的渲染发生在第一个 play 之后,自然能读到 set_fact 的新值)。拆 play 是更常用的做法,也顺便让剧本结构更清晰。
事故二,"服务没重启"。任务改了配置也 notify 了,但 handler 排在 play 之外或名字拼错,引擎静默忽略;或者中途某任务失败导致 play 中止,攒着的 handler 永远没机会跑。前者用 lint 工具可查(第 6 章),后者的恢复手段是修好失败原因后重跑整个 play——重跑是安全的,这正是幂等性的日常价值。
把六站装进脑子后,下一节我们拿工具实地看这条生命线:四层日志各自长什么样、每个任务究竟花了多久、错误在不同站点留下的不同痕迹。
生命线上的时间账本
六站模型还有一层用法:把它当作"时间去哪了"的解释框架。一次运行的总时长里,站 1 与站 2 的开销与主机数量无关(解析与渲染各做一次),站 3 到站 5 的开销随主机数线性增长,站 6 可忽略。这个视角能提前预判剧本的扩展性:任务数为二十、主机数为十的剧本,往返次数是两百;主机涨到一百,往返两千——增长的是站 4 的体量,所以性能调优的第一杠杆永远指向连接层(6.2 节展开)。反过来,如果一次小规模运行也很慢,问题多半不在站 4 而在站 2:变量渲染遇到复杂表达式、大量查找插件调用,都会在装载期悄悄吃掉时间。把"慢"先归到站点,再谈优化,是这个模型最实用的红利。
另一个从时间账本推出的实践是"任务粒度预算"。既然每任务每主机都有固定往返成本,任务数量就直接决定运行时长的下限。写剧本时对任务数保持敏感:能用一个模板解决的就不要拆成四次行编辑,能用一个循环表达的就不要复制五个任务——这与 6.2 节"任务合并"杠杆是同一件事的编写期形态。
多 play 剧本的执行语义
前面六站的描述针对单个 play,多 play 剧本(这是生产环境的常态)需要补两条语义。其一,站 1 与站 2 对每个 play 重复执行:第二个 play 的变量渲染发生在第一个 play 完全结束后,这正是 2.2 节开头"拆 play 读 set_fact 新值"手法成立的机制基础。其二,serial 是 play 级属性,多 play 剧本里每个 play 有自己的批次节奏,滚动发布因此可以精细到"这一层滚动、那一层全量"——比如应用层 serial 滚动、数据库层的配置校验 play 全量一次跑完。理解了"play 是生命线的执行单元",多 play 组织就不再只是文件结构的习惯,而是执行语义的选择。
最后留一个自查动作:读完本节后,把 3.3 节那份发布剧本拿出来,在纸上标出它的每个任务分别发生在六站中的哪一站、handlers 会在哪个时刻执行、serial 批次如何切分主机——十分钟的白纸推演,胜过十次模糊的重读。