3.1 清单 Inventory 管理
3.1 清单 Inventory 管理
本节摘要:清单是"机器的户口簿":INI 与 YAML 两种格式、组的嵌套与别名、主机变量与组变量、分环境目录布局,以及用动态清单脚本对接云厂商。学完本节,任意规模的机器群都能被组织成有名字、有层次、带参数的结构。
为什么清单值得单独一节
新手容易把清单当成"一列 IP 地址",直到第一次遇到这些需求才回头补课:同一段剧本要在测试环境打 3 台、生产环境打 40 台;生产组是应用组与网关组的并集;某台机器的 SSH 端口非标准;临时只想对"华东区的数据库从机"执行。这些需求全靠清单的组织能力解决。清单设计得好,剧本可以写得完全不含机器细节——剧本说"对 db_servers 做",清单决定 db_servers 是谁,环境切换只是换一份清单或加一个参数。
INI 格式:从平铺到分层
INI 是最常见的入门格式,特性浓缩在一份示例里:
; 星尘在线 · 生产清单(节选) [web] web01 ansible_host=10.0.1.11 ansible_port=22 web02 ansible_host=10.0.1.12 [db] db01 ansible_host=10.0.2.11 db02 ansible_host=10.0.2.12 [cache] redis01 ansible_host=10.0.3.11 [prod:children] web db cache [web:vars] ansible_user=deploy http_port=8080
四个语法点。其一,行尾的键值对是主机变量,ansible_host、ansible_port 属于连接参数族(这一族还有 ansible_user、ansible_ssh_private_key_file 等)。其二,:children 后缀声明父组,父组是子组的并集,[prod:children] 让"对 prod 执行"一句涵盖三组。其三,:vars 后缀定义组变量,作用域为整组;主机变量优先于组变量。其四,所有未分组的机器自动属于两个隐含组:all 与 ungrouped。
YAML 格式:结构复杂时的选择
组嵌套深、变量结构复杂时,YAML 清单可读性反超 INI,尤其变量是字典或列表的时候:
all: children: prod: children: web: hosts: web01: ansible_host: 10.0.1.11 web02: ansible_host: 10.0.1.12 vars: http_port: 8080 db: hosts: db01: ansible_host: 10.0.2.11 repl_role: primary db02: ansible_host: 10.0.2.12 repl_role: replica
同一份结构里,db 组两台机器各自的 repl_role 是主机变量、http_port 是组变量,层次一目了然。两种格式并存的项目里,建议约定一个方向(要么全 INI 要么全 YAML),避免成员往两处加机器导致清单漂移。
目录布局:分环境的正规姿势
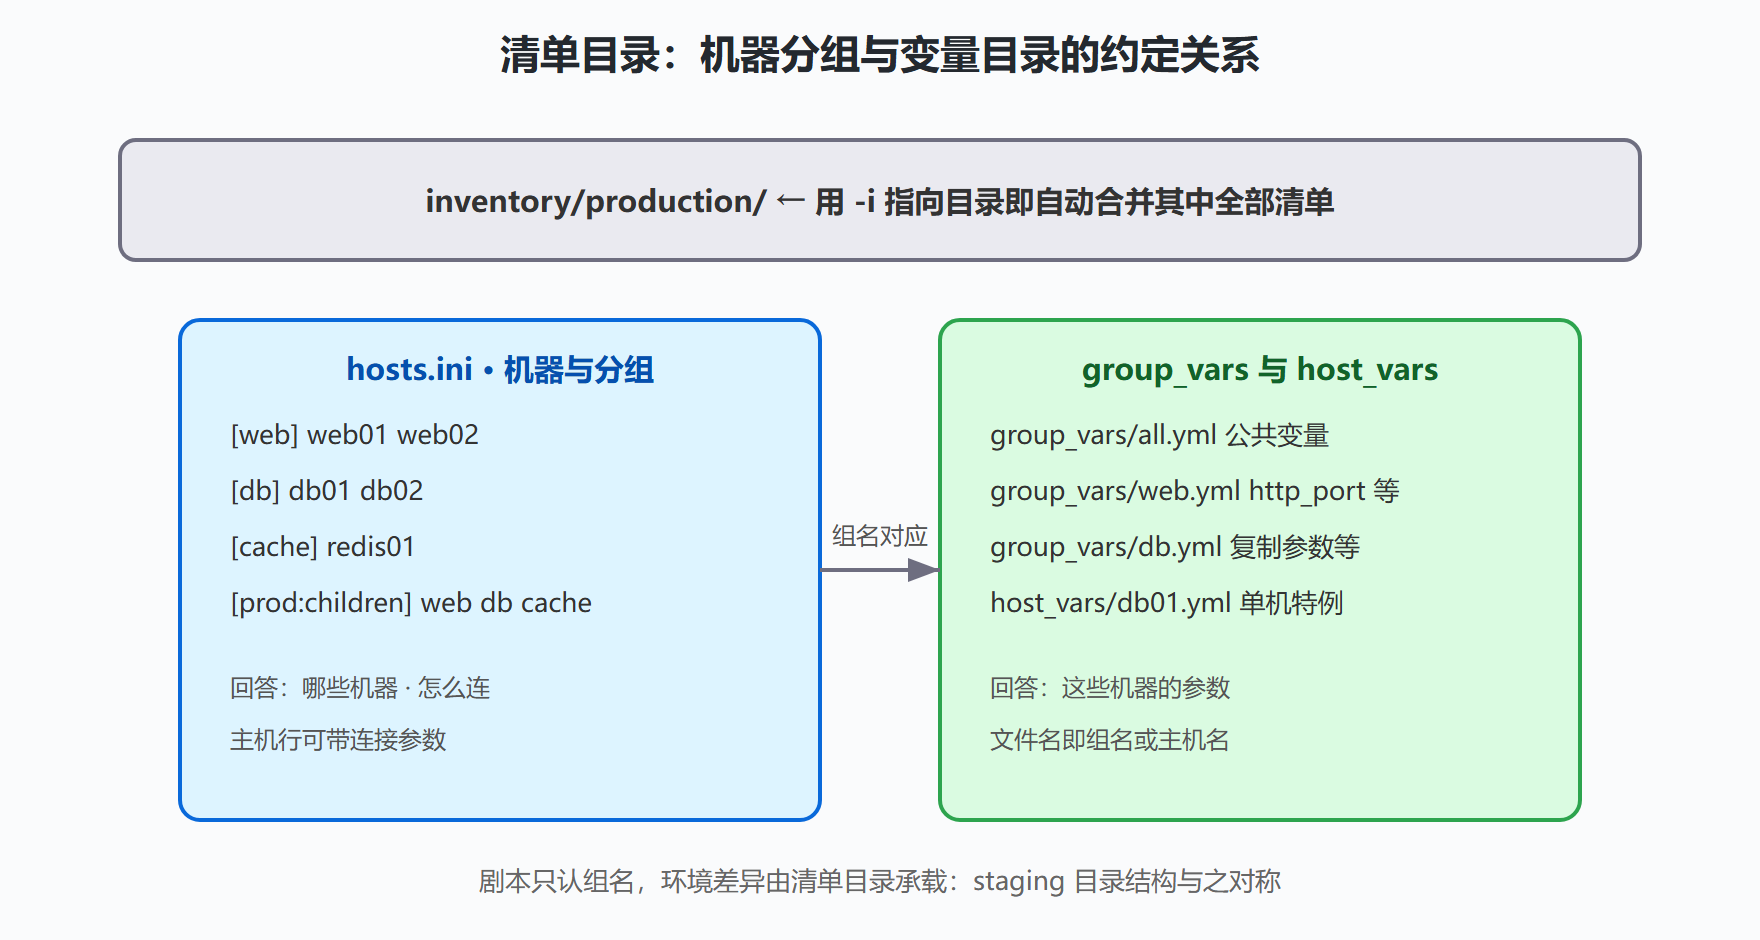
规模再大一点,单文件清单就该升级为清单目录:目录里每个文件是一组清单,引擎加载时自动合并。
inventory/ ├── production/ │ ├── hosts.ini # 生产机器 │ └── group_vars/ # 组变量目录 │ ├── all.yml # 所有主机的公共变量 │ ├── web.yml # web 组变量 │ └── db.yml │ └── host_vars/ # 主机变量目录 │ └── db01.yml └── staging/ ├── hosts.ini └── group_vars/ └── all.yml
执行时用 -i inventory/production 或 -i inventory/staging 切换环境。group_vars 与 host_vars 目录是约定优先于配置的典范:引擎看到清单目录旁的这两个目录就自动加载,文件名即组名或主机名。这套布局把"机器在哪"(hosts.ini)与"机器参数是什么"(vars 目录)分开,变量文件的合并与优先级在 3.4 节展开。
动态清单:机器列表会自己变的时候
云环境里机器随伸缩组进出,静态清单很快过期。动态清单是可执行脚本或插件:引擎调用它,拿到一份 JSON 格式的组结构。现代用法优先用清单插件——比如主流云厂商的动态清单插件,配置文件声明筛选条件,运行时实时拉取实例列表:
# 动态清单插件配置(示意):按标签筛选拉取 plugin: 云厂商名称 regions: - cn-north-1 filters: tag/Role: web keyed_groups: - key: tags.Env prefix: env
验证动态清单结果的利器是 ansible-inventory 命令:ansible-inventory -i inventory/production --list 输出解析后的完整结构,--graph 以树形打印组层级。清单排障先跑它,一眼看清引擎眼里的机器世界长什么样——大量"剧本没作用到那台机器"的问题,根因都在清单解析结果与预期不符。
图 3-1:分环境清单的组织结构
易错清单
错一,变量写错层级:把只属于一台机器的参数写进组变量,另一台机器执行时拿到错误参数。凡参数名出现"角色、序号、主从"字样,优先考虑主机变量。错二,INI 清单里的中文注释后忘了空格分隔,把注释内容并进了变量名。错三,动态清单脚本没有可执行权限,引擎回退到把它当静态文件解析,报一堆"无法解析"的错——看到诡异的解析报错先 ls -l 看权限。错四,组合并冲突:清单目录里两个文件定义了同一台主机,后加载的连接参数静默覆盖前者,用 ansible-inventory --graph 核对最终结构。
清单演进的三个阶段
以清单的组织形态为线索,一个团队的清单通常经历三个阶段,认清自己处在哪一阶段能避免超前的复杂度。阶段一,单文件清单:机器几台到几十台、环境单一,一个 hosts 文件加行内变量就够,此阶段引入目录分层属于提前建筑。阶段二,分环境目录:环境超过两个或机器过百,3.1 节的目录布局接管,变量文件成为主要维护面。阶段三,动态与外部化:机器进出频繁或资产数据有独立来源,动态清单插件或 CMDB 对接接管,静态文件退居兜底。阶段的迁移应当由疼痛触发(清单合并冲突频发、机器列表过期事故)而不是由"先进性"驱动——见过三十台机器就上 CMDB 对接的团队,维护对接的功夫比维护清单还多。与 1.2 节的场景矩阵同一道理:清单形态是手段,匹配变更节奏才是目的。无论哪个阶段, ansible-inventory 的核对习惯不变——清单可信的前提是随时可验证。