6.2 性能调优策略
6.2 性能调优策略
本节摘要:把一次运行的耗时拆成三段——连接开销、事实收集、任务串行——并给出对应的调优杠杆:SSH 管道与连接复用、事实缓存、并发与策略调整。铁律是先测后调:profile 数据在手之前不动任何参数。下一节的百机实验是本节每个杠杆的实证。
耗时都花在哪了
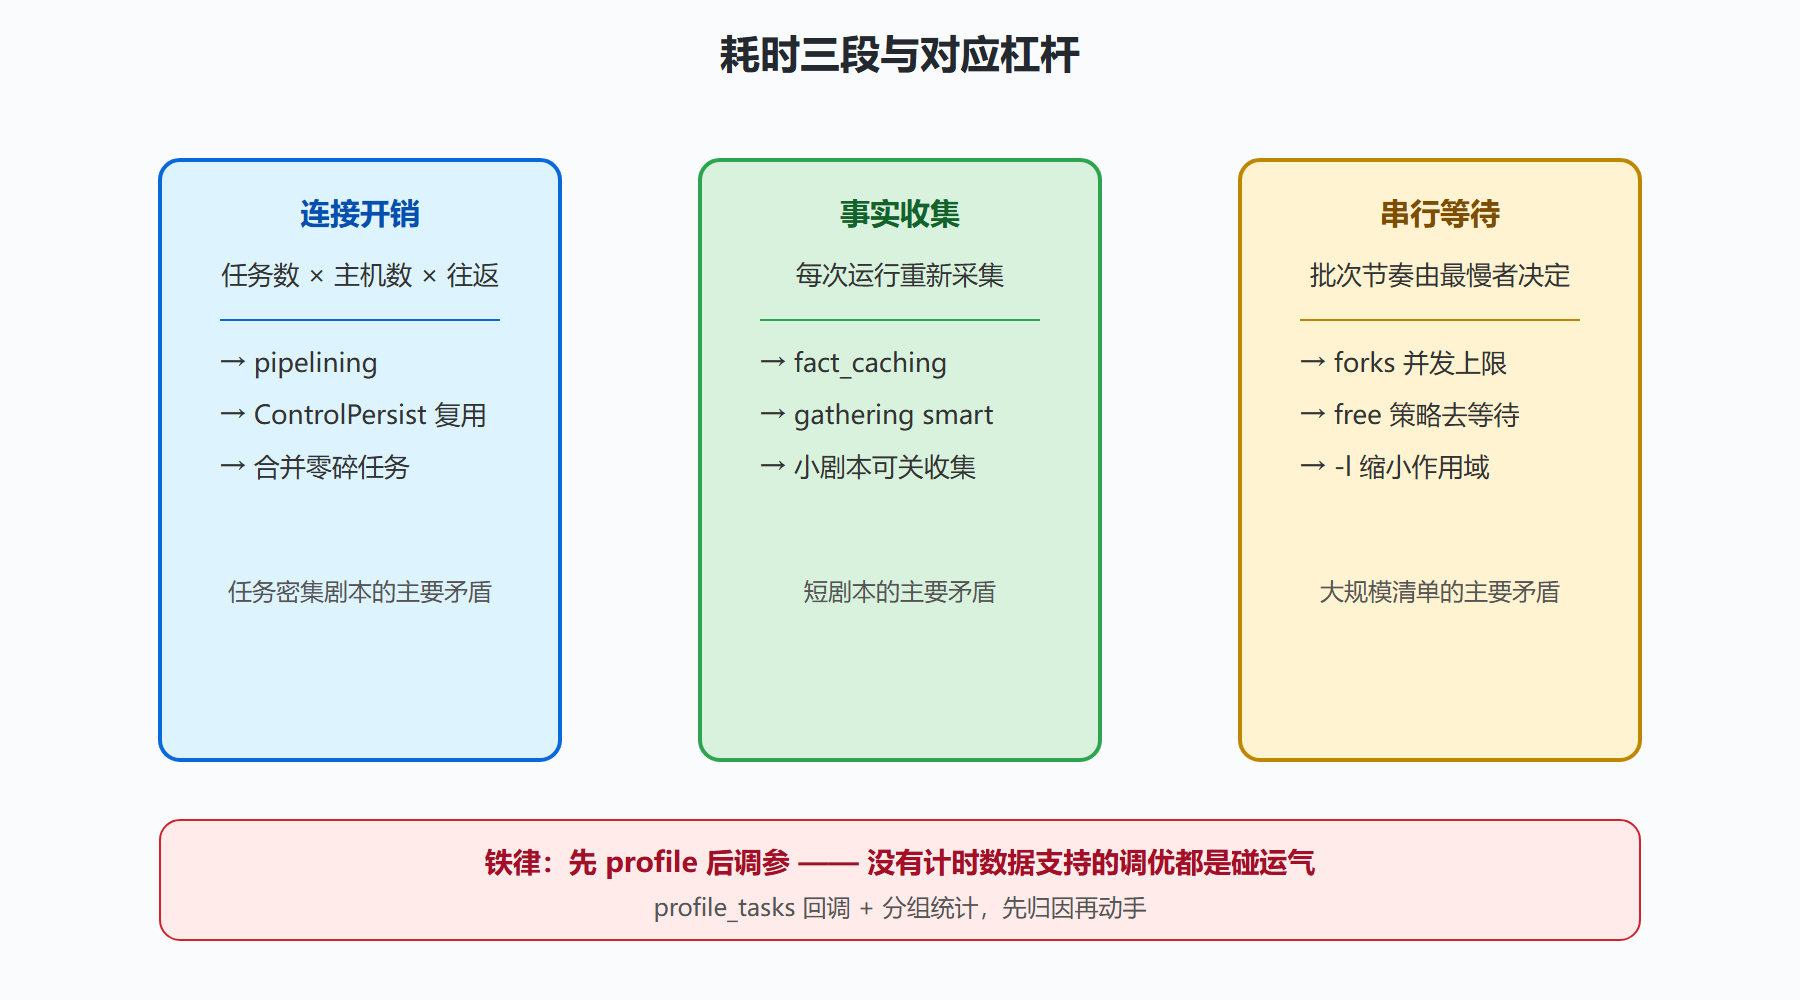
调优的第一步是建立耗时模型。一份剧本的总时长可以拆成三段。第一段,连接开销:每个任务每台主机都要经历"建立 SSH 会话、传输模块、远端执行、收回结果"的往返。任务数乘以主机数再乘以单次往返,就是第一段的体量——任务多的剧本里,纯开销能占总时长的大半。第二段,事实收集:gather_facts 触发的 setup 模块本身也是一个完整往返,还附带目标机的采集成本。第三段,串行等待:线性策略下快主机等慢主机,批次的节奏由最慢的主机决定。
2.3 节装的 profile_tasks 计时回调是拆解工具,这里补充一个更细的视角:把计时输出按任务类型分组看——debug 类任务的耗时就是纯连接开销的"体温计",模板类任务的耗时减去同类 debug 任务,就是模块本身的工作量。用几行统计就能把"慢"归因到三段中的哪一段。
杠杆一:压缩连接开销
SSH 管道(pipelining)是第一杠杆。开启后模块传输从"多轮临时文件往返"压缩为单流写入,对任务密集的剧本提速立竿见影。代价与前提:要求受管机 sudo 配置不强制分配终端(requiretty 关闭,现代发行版默认已关);部分老旧环境对会话内多命令有限制,开启前先在实验机验证。配置一行:
# ansible.cfg [ssh_connection] pipelining = True
连接复用是第二杠杆。SSH 的 ControlPersist 让同一目标机的多次连接复用一条主通道——引擎默认会启用,但系统级 SSH 配置如果禁用了 ControlMaster,复用就失效。验证方法:跑剧本时在目标机 who 看会话数量,或直接看控制机 ~/.ssh/ 下的套接字文件。两个杠杆叠加后,单任务往返常能从秒级压到亚秒级。
第三杠杆,减少往返次数:把多个零碎动作合并成一个任务。典型反模式是五个连续的 lineinfile 各自往返——如果操作的是同一份配置,合成一个 template 一次往返。这个杠杆没有参数可调,靠的是写剧本时的"往返意识",收益却常常最大。
杠杆二:事实缓存
gather_facts 的结果默认即取即弃,每次运行重新采集。事实缓存把它存下来跨运行复用,jsonfile 缓存零依赖最简单,redis 缓存适合多控制机共享:
[defaults] gathering = smart fact_caching = ansible.builtin.jsonfile fact_caching_connection = /tmp/ansible_fact_cache fact_caching_timeout = 86400
适用判断比配置更重要:缓存收益随剧本的任务密度提高而摊薄——跑几百个任务的剧本,采集那一两秒占比很小;收益最大的是"短平快"剧本(临时命令、单任务修补),采集开销占比能到一半。风险也要心里有数:缓存过期窗口内机器变了(升配、换盘),剧本用到相关事实就会拿到旧值,涉及敏感事实的任务该 set_fact 现算就现算。
杠杆三:并发与策略
forks 参数是并发上限,默认 5——一百台机器的清单,这就是明显的瓶颈。提到多少合适?物理上限是控制机的 CPU 与网络(每个 fork 是一个工作线程,连接建立期的开销不小),经验值 20 到 50 之间起测,结合下一节的实验数据定夺。比调大 forks 更有效的是缩小作用域:-l 限定主机子集、--tags 只跑相关 tag——一百台里只有十台需要这次变更,调任何参数都不如限定作用域立竿见影。
策略层的两个选项。serial 批次大小影响总时长与风险敞口的平衡:批次越大总时长越短、但单批故障的爆炸半径越大。free 策略消除快慢等待,代价是失去全局顺序——多数配置类剧本可以承受,编排类剧本不可。两个选项都该在业务约束下选择,而不是单纯求快。
图 6-2:三段耗时的调优杠杆分布
调优的工作流
一次完整的归因演示
用一个虚构但典型的数据演示三段归因的完整过程。某团队一份三十任务的剧本在四十台机器上跑了二十二分钟,第一反应是"加 forks"。按流程先测:计时回调显示单任务平均主机耗时三点二秒,其中 debug 类任务(近乎纯往返)两点六秒——归因到连接开销占比八成,三段模型的第一段。再看任务清单:六个连续的 lineinfile 操作同一份配置——往返次数本可砍掉一半。先做免费的(合并六个任务为一个模板),时长降到十六分钟;再开管道,降到十一分钟;最后 forks 提到二十,七分半收工。全过程没有一步是猜的:每一步之间都有计时数据支撑,每一步的收益都可解释。这个演示想立住的规矩是顺序:先归因、免费的先做、参数的最后动——大量团队的调优史是反着来的,参数调了一圈才发现剧本里有六个连续的行编辑。
调优的边界与反模式
三个常见的调优反模式值得点名。反模式一,盲目调大 forks:控制机 CPU 打满后,更高的 forks 只会增加上下文切换与连接失败率,收益归零甚至为负——拐点要靠实验找(6.4 节给了完整方法),不能拍脑袋。反模式二,为了快牺牲顺序:把发布剧本的策略改成 free 换提速,结果部署顺序乱掉、依赖服务未就绪导致批量失败——快出来的几分钟赔进去几小时。反模式三,缓存一切:事实缓存之外,有人尝试缓存"执行结果"来自定义方案,把状态管理搞成了两套真相——Ansible 的世界里目标机现状是唯一真相,任何第二真相源都是隐患。三条反模式的共性是把杠杆用在了错误的约束上:调优的前提是认清瓶颈归因,认清业务约束(顺序、一致性),然后才轮到参数。
不同剧本形态的调优重点
剧本的形态不同,调优重点也不同,给三类常见形态各自的着力点。初始化类剧本(新机首次配置,任务多、变更真实发生):重点在并发与批次设计,因为模块真实工作量占大头,连接开销占比相对小,forks 与 serial 的组合直接决定总时长。巡检类剧本(周期核对状态,全 ok 快路径):重点在事实缓存与作用域,收敛态下引擎开销占绝对大头,缓存与缩小目标集收益最大——这也是巡检剧本尽量做短做专的原因。发布类剧本(滚动、带验证与暂停):重点根本不在快,批次大小与验证超时的设置以风险可控为先,速度只是约束下的副产品。三类形态对号入座后,多数团队会发现自家的"性能问题"其实是形态误配——用巡检类的心态写发布剧本,或反过来。先分形态,再谈调优,与 6.4 节"先收敛态测量"是同一条方法论的不同侧面。