1.1 最小可调度DAG
1.1 最小可调度 DAG
本节摘要:最小可调度 DAG 是一份能被解析器加载、能被暂停、能被手动或按计划触发的 Python 蓝图。它至少包含唯一
dag_id、start_date、调度表达式、一组默认重试参数,以及用依赖边连起来的两个以上任务。本节用一条“拉数—校验—入库”链说明:你写的不是立刻执行的脚本,而是调度器稍后按数据窗口去实例化的契约。
学习目标
阅读完本节,你应当能够:
- 列出一条 DAG 被解析器收下时必须具备的最小字段
- 用依赖边表达“校验必须等拉数成功”
- 解释为何
start_date不是开机时间、手动触发与计划触发有何差别 - 在本地用 Sequential 或 Local 执行器验证任务状态,而不是先上集群
一、先把口头步骤写成图
多数团队第一次接触 Airflow,是因为 cron 已经管不住依赖。口头流程通常是这样:每天凌晨拉昨天的用户行为日志,校验字段是否齐全,再写入分析库。三步里真正要命的不是“几点开始”,而是“第二步没做成,第三步绝对不许写库”。
把这三步画成工位,比先背架构有用:
拉数工位 ──► 校验工位 ──► 入库工位 │ └─任一工位失败,下游不要假装成功
Airflow 要你把工位写成任务,把箭头写成依赖。调度器不会替你猜“校验大概要等拉数”。图上没有的边,运行时就不存在。这是动手优先的第一课:先有图,才有钟。
下面是一条刻意写短的概念 DAG。它用 default_args 把责任人、重试次数、重试间隔收成一份默认契约,再用 >> 声明先后。catchup=False 是生产里最常见的安全阀:不要因为 start_date 写得早,就在第一次上线时把半年历史窗口全部排队。
from datetime import datetime, timedelta from airflow import DAG from airflow.operators.python import PythonOperator def pull_logs(**ctx): # 用数据区间终点当“昨天”的标签,而不是 datetime.now() window = ctx["data_interval_end"] return f"pulled:{window}" def validate(**ctx): return "ok" def load(**ctx): return "loaded" with DAG( dag_id="daily_behavior_min", start_date=datetime(2024, 6, 1), schedule="0 2 * * *", catchup=False, max_active_runs=1, default_args={ "owner": "data_platform", "retries": 2, "retry_delay": timedelta(minutes=5), }, ) as dag: t_pull = PythonOperator(task_id="pull_logs", python_callable=pull_logs) t_val = PythonOperator(task_id="validate", python_callable=validate) t_load = PythonOperator(task_id="load", python_callable=load) t_pull >> t_val >> t_load
⚠️ 常见坑:
start_date写成“今天早上”,再配catchup=True,调度器会按窗口补齐从原点到现在的全部 DagRun。金融场景里有人把原点设到半年前,数小时内冒出上百个并发运行,把元数据库连接池抽干。生产默认关掉 catchup,补数用显式 backfill。
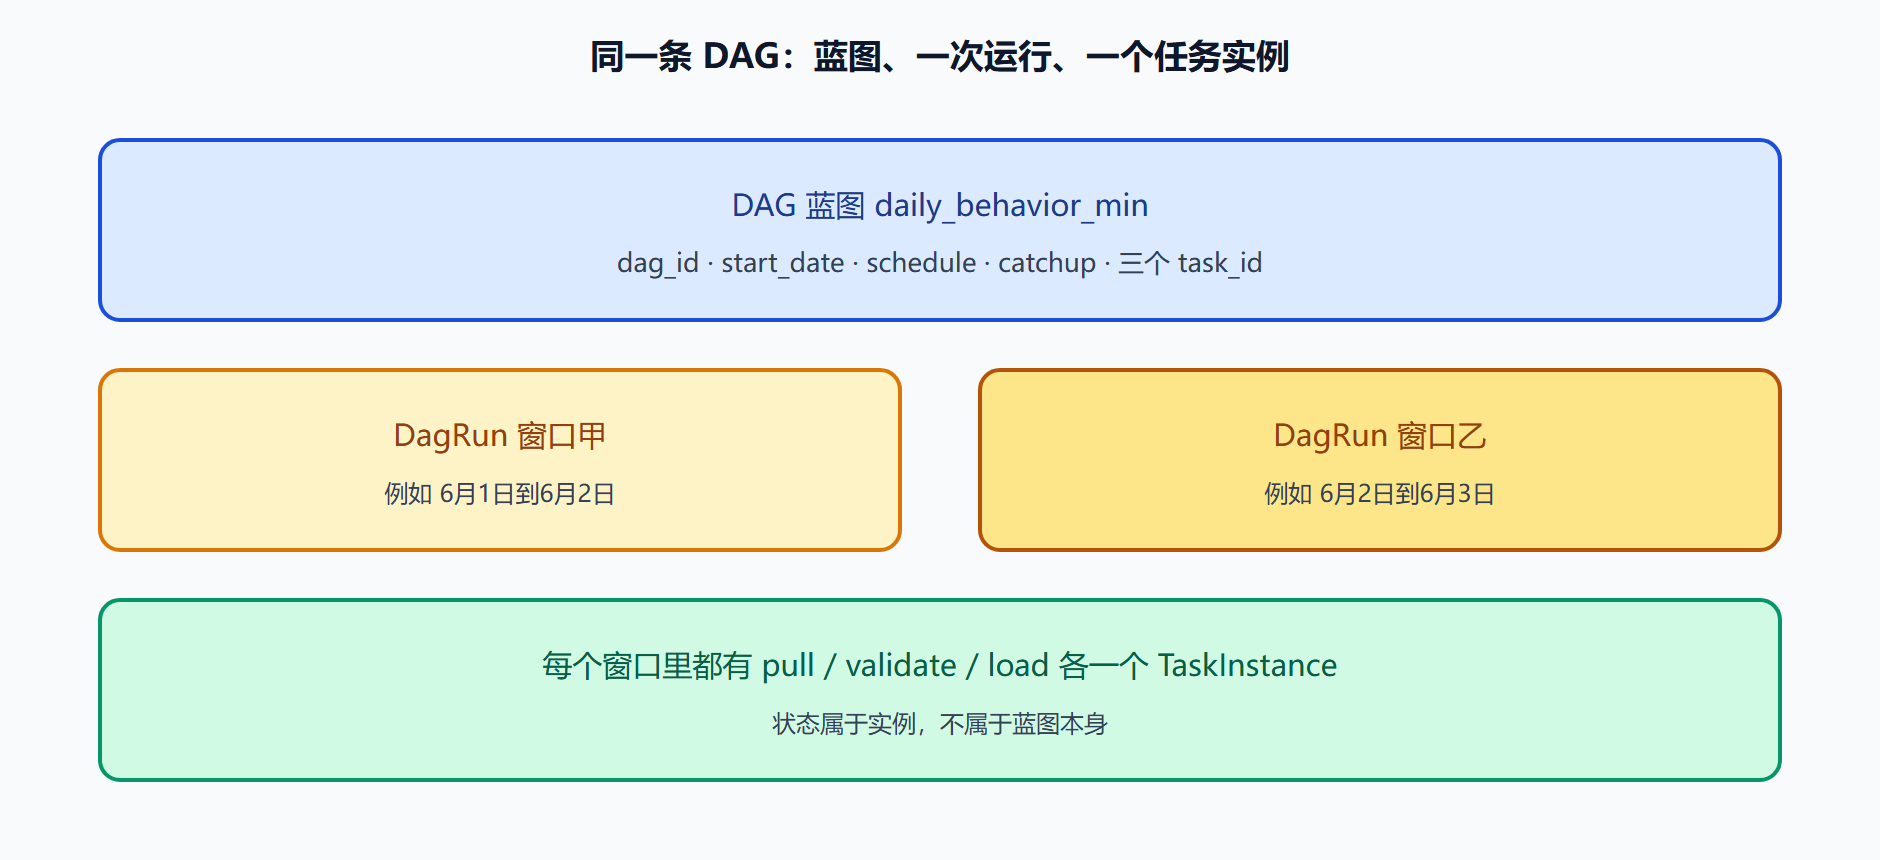
💡 关键直觉:这段代码在解析时只构造对象,不拉日志。真正拉数发生在某个 TaskInstance 被执行器领走之后。
图 最小 DAG 的三层对象
二、解析器收下它,调度器才谈得上触发
Airflow 不会在你保存文件的那一刻执行 pull_logs。Scheduler 侧有独立的 DAG 文件处理子进程,把定义加载成内存对象,再写入元数据里的 DAG 记录。原文把这个过程说成双重生命:声明式蓝图,加上运行时图谱。动手时你只需要记住三件事。
第一,dag_id 必须全局唯一。动态生成多租户 DAG 时,用前缀把命名空间隔开,例如租户号进 id,避免两个工厂函数撞名。第二,文件必须能被无副作用地反复 import。解析器会周期性重载,模块顶层如果去连生产库或起死循环,调度器会被你的 DAG 拖死。第三,语法错、import 错会出现在导入错误列表里,界面上看不见图,不等于调度器没扫到文件。
时间字段是最小 DAG 里最容易写错的一组。schedule(旧文档大量使用 schedule_interval)划分的是数据窗口长度,不是“闹钟响一声”。一个日调度的运行实例,对应的是左闭右开的一段数据区间;execution_date 在旧语义里常被当成窗口左端,新语义更准确的名字是数据区间的端点对。原文写过一个容易忽略的细节:若 start_date 是 6 月 1 日 2 点、间隔一天,第一个窗口并不是“6 月 1 日零点”,而是从你写下的原点开始对齐。把 start_date 当电源键的人,会在“为什么今天没跑”上浪费一下午。
| 字段 | 它真正约束的事 | 新手常误当成 |
|---|---|---|
| dag_id | 全局唯一名字,元数据主键 | 可以随便改、旧运行会跟着改名 |
| start_date | 时间坐标原点 | 第一次开机的挂钟时刻 |
| schedule | 窗口长度与对齐 | 任务函数里的 sleep 间隔 |
| catchup | 是否补齐历史窗口 | 失败自动重跑 |
| max_active_runs | 同时活跃的运行个数上限 | Worker 进程数 |
| retries | 单任务失败后的再试次数 | DAG 级无限重跑 |
max_active_runs=1 适合“同一条链不允许两个窗口叠着写同一张表”的入库 DAG。报表类可以放宽到 3 到 5,让近几天并行算,但要确认下游表按窗口分区,否则会互相覆盖。depends_on_past 先别开:它让今天的任务必须等昨天同一任务成功,滚动窗口有用,级联阻塞也来得快。原文建议把硬跨周期依赖尽量收成对特定外部任务的显式等待,而不是给整张图开全局开关。
三、怎样确认它“能调度起来”
动手验证分三档,不要一上来就上 Kubernetes。
第一档:解析。让调度器扫到文件后,界面出现 DAG 卡片,状态可以暂停和恢复。暂停意味着不再生成新的 DagRun,已经在跑的实例不一定立刻停。这是上线开关,不是 kill -9。
第二档:手动触发一次。手动运行会创建一个 DagRun,任务按边依次变成 queued、running、success 或 failed。LocalExecutor 下你能在本机看到进程;SequentialExecutor 更慢但更干净,适合确认依赖边有没有写反。看日志时认 task_id,不要只看 DAG 级绿条——绿条可能是“三个任务里你只点开了成功的那个”。
第三档:等一个真实窗口。计划触发要求当前时间已经越过该窗口的右端。这就是“为什么 start_date 是今天、schedule 是每天、现在却还没跑”的标准答案:窗口还没结束,调度器认为数据区间尚未闭合。开发阶段用手动触发;要验证时间语义,把原点设到明确的过去某一天,并关掉 catchup,再等到下一个窗口。
执行器这一步可以很土。SequentialExecutor 单线程,官方定位就是开发。LocalExecutor 在本机起多进程,语义跟生产仍不一样——没有消息队列、没有跨机器隔离——但足够验证“校验失败时入库会不会仍被触发”。默认触发规则是全部上游成功;你什么都没写时,失败会阻断下游,这正是最小链想要的。
任务函数里避免 datetime.now() 当业务日期。调度上下文提供数据区间,模板里常见 ds 这类日期字符串。用“现在”会让补数与重跑失去确定性:同一个窗口跑第二次,切到的却是另一天的数据。幂等是最小 DAG 就要培养的习惯:入库按窗口覆盖或按主键去重,重试才安全。
owner 不是装饰。告警、权限、值班表都靠它认人。retries=2 配五分钟间隔,意味着单次抖动最多换来十几分钟延迟,三次仍失败就停。这是对下游 SLA 的隐性承诺,原文把它写成时空约束:任务耗时加上重试等待,必须塞进调度间隔减去调度开销。撑破了,表面上还在跑,实际上已经还不上业务时钟。
最小 DAG 不需要 Provider、不需要 Dataset、不需要动态映射。那些是第 2 章和第 5 章的工具。现在只要求:唯一 id、可重复解析、边正确、窗口语义说得清、失败可见。能做到这五条,你就已经比“把脚本丢进 cron 再祈福”多了一张可审计的图。
四、第一次失败时怎么读现场
手动触发后若 pull_logs 成功、validate 失败,load 应是 upstream_failed 而不是 running。若 load 仍在跑,边写反了或触发规则被改过。打开失败那一次 try 的日志,不要看成功的第一次。重试中的任务状态是 up_for_retry,此时不要人工再点一次触发,否则两个窗口的语义会叠在一起,入库更容易双写。
暂停开关值得单独走一遍。暂停后,新的计划 Run 不再产生;已经 running 的实例通常还会跑完。把暂停理解成“停止接新车次”,不是紧急制动。生产误开一张未审完的 DAG,第一反应是暂停,而不是删文件——删文件只让解析消失,库里的历史还在,下次同名 DAG 会让人更晕。
时区建议在最小 DAG 阶段就定死。naive 的 datetime(2024, 6, 1) 会按配置默认时区解释。团队若分布在多个地区,把业务日定义写进 doc_md:是自然日零点还是活动日两点切。1.1 不要求你配夏令时,但要求你承认原点带小时分钟,不是自动对齐午夜。
问题:必须装界面才能验证最小链吗?
不一定。解析成功、任务能被 Sequential 执行器跑完,就已经证明图可调度。界面方便观察状态色,但状态写在元数据库。没有界面时,用列出 DAG、列出运行的运维命令也能确认。不要把“我还没装 Web”当成不能写第一条 DAG 的理由。
问题:retries=2 会不会让失败的校验把坏数据入库?
不会,只要边还在、默认规则还是 all_success。重试的是校验这个节点自己,不是跳过它去跑入库。真正危险的是有人给入库加了 all_done,或把校验和入库写成两个互不依赖的根任务。最小链阶段把边画对,比把重试调大重要得多。重试只对瞬时网络抖动有意义;校验逻辑失败,三次同样的失败只是浪费十五分钟,应降 retries 并修函数。
五、最小链的验收口令
口头复述这五句,算本节过关。其一,保存定义时函数不会跑。其二,catchup 关闭时上线不会自动清算半年。其三,校验失败则入库不得进入 running。其四,业务日期来自区间不是来自 now。其五,暂停停止接新窗,不保证瞬间杀死已跑进程。五句都能用自己的一次操作为例说明,就可以进入 1.2。若只能背字段名,回去再手动失败一次。最小 DAG 的教育意义在失败,不在三次全绿。全绿什么也没验证到,只验证了你还没写错边。
六、和 cron 对照写同一条链
用 cron 表达三步,你通常会写三个时刻或一个脚本里顺序调用。顺序调用把失败停下游做进了进程,但失去了窗口身份:重跑时很难只重跑校验而不重拉。三个时刻则失去了停下游。Airflow 最小链同时保留停下游与窗口身份。这就是迁入的最小理由。若你的脚本已经按日期分区且失败就退出,迁入的收益主要是可见性与重试政策统一。不要为了迁而迁。但一旦迁,就不要保留脚本里的 now(),否则窗口身份是假的。假窗口比 cron 更危险,因为它看起来可审计,实际不可重放。最小链的最后一次自检:把逻辑日期改到上周某一天手动跑,数据是否仍切到那天。切不到,就还在用墙钟。墙钟是 cron 思维的残留,必须在 1.1 清掉,否则第 2 章所有模板都是装饰。
要点速记
- 蓝图不是一次执行:DAG 文件被解析成对象,调度器按窗口或手动操作生成 DagRun,执行器才跑任务函数
- 最小字段:唯一 dag_id、start_date、schedule、可重复 import、至少一条依赖边
- catchup 默认关掉:历史补齐用显式 backfill,避免上线瞬间打满连接池
- max_active_runs 管窗口重叠:写同一张表时先设 1,报表并行再放宽
- 别用墙上时钟当业务日期:用数据区间,重跑才可复现
- 先 Sequential 或 Local 验证边:集群是下一阶段的事,边写反了换执行器也救不了
下一节把界面上的词和元数据对象对齐,避免“任务”和“算子”被当成同一个东西。