4.2 高可用与扩展
4.2 高可用与扩展
本节摘要:Airflow 的高可用不是所有组件都双副本。元数据库要有主从与备份;调度器 HA 主要防进程挂掉后不再建 Run;Worker 水平扩展提吞吐;Broker 要持久化以免 queued 蒸发。扩错层会花钱买来更剧烈的锁竞争。锁竞争会让所有窗口一起推迟。推迟是全局违约,不是单条 DAG 的事。全局违约要按平台事故升级,不要当成某个作者的 SQL 问题。
阅读收获
阅读完本节,你应当能够:
- 按组件列出“挂了会怎样、如何备”
- 解释为何加调度器副本不等于线性加速解析
- 给 Worker 扩缩一个与池、队列匹配的上限
- 识别扩展后最先出现的数据库锁与解析风暴
一、分层备,不要均匀洒副本
数据库:主库写,从库备或读。丢失元数据等于丢失全部运行历史与变量。备份策略要能恢复到指定时间点,因为误删 DAG 暂停状态也是事故。连接串给 Scheduler/Web/Worker 用连接池,上限小于数据库 max_connections,给 catchup 事故留余量。
调度器:多实例 HA 让其中一台做调度决策,另一台接替。它防的是单进程死亡导致新窗口停摆,不防数据库锁。两台同时积极调度若协调失败,才是事故。按官方 HA 模式部署,不要自己发明双写。
Web:无状态可多副本,前面加负载均衡。会话与 CSRF 按 FAB 配置。Web 多了不会让任务变快。
Worker:真正线性的一层。Celery 加机器;K8s 加可调度资源。但池配额、数据库、外部 API 限流会先到。扩 Worker 前先看 queued 原因是不是池满。
Broker:镜像与持久化。Redis 当 Broker 要接受重启丢消息的风险或开持久化;RabbitMQ 有自己的队列镜像。Broker 脑裂会导致重复执行,任务必须幂等。
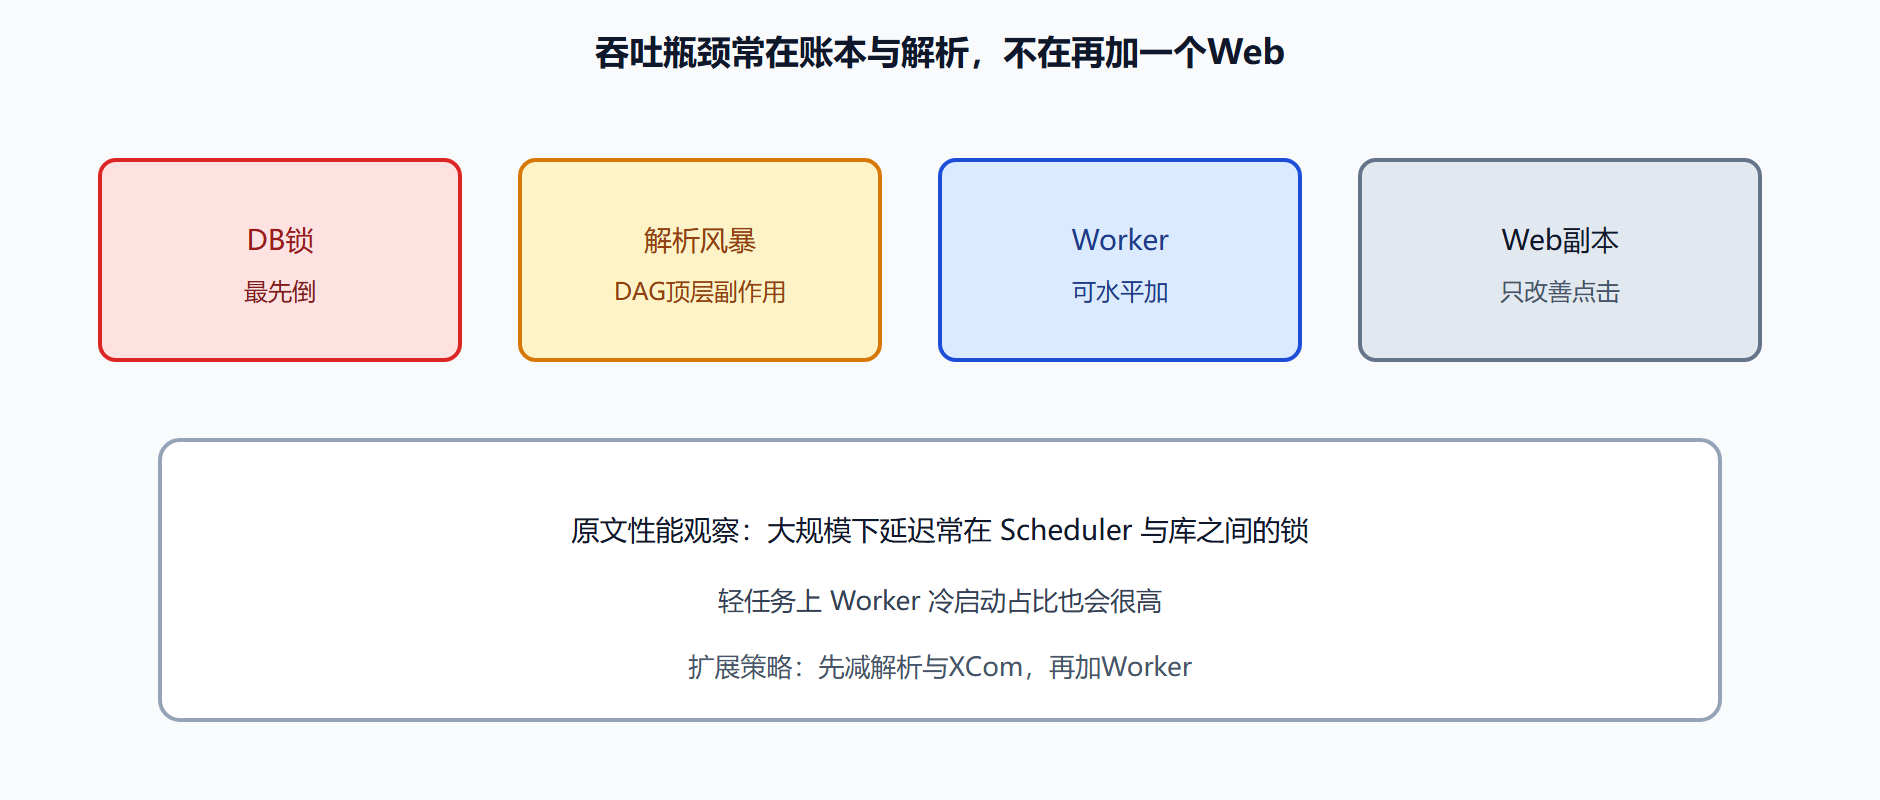
图 扩哪一层真正增加吞吐
二、扩展的正确顺序
先减少每个 DAG 的解析成本:顶层无 IO、拆文件、避免巨量动态图。再给元数据库加资源和索引维护。然后按队列扩 Worker。最后才考虑调度器 HA 与跨可用区。顺序反了,两台调度器会把已经很忙的库打得更忙。
K8s 上扩 Pod 要配资源请求,否则节点挤爆出现随机 OOM,状态机出现大规模 up_for_retry,像“平台不稳定”,其实是配额谎言。Celery 扩 Worker 要同步代码版本,滚动更新时允许短暂两版本并存的话,DAG 必须向后兼容一个周期。
| 层 | 扩展手段 | 不扩展时的症状 |
|---|---|---|
| 数据库 | 规格、连接、真空/索引 | 调度循环变慢,UI 卡 |
| 调度器 | HA 接替,不是无限加 | 进程死后不再建 Run |
| Worker | 水平加副本 | queued 堆积 |
| Broker | 持久化与容量 | 入队丢失或重复 |
| 外部系统 | 对方限流与池 | 任务失败像 Airflow 故障 |
三、故障演练值得做的几下
停一台 Worker:运行中任务应失败并重试,调度器继续。停 Web:任务不受影响。只读库切换:允许短暂 UI 失败,写入调度不能长时间停。千万不要在演练里对生产库做无备份删除。
⚠️ 常见坑:把 max_active_runs 和 Worker 数一起加到很大,外部数仓先被打挂,于是重试进一步放大,形成自激。
💡 关键直觉:高可用保的是“还能继续记账和放行”,扩展保的是“同一时间能搬更多箱子”。两件事用不同旋钮。
多调度器与 DAG 序列化:确保所有调度器看到同一份代码。否则一台认为 DAG 存在,一台解析失败,Run 行为抽风。配置里的 DAG 目录必须是同一发布。
池是逻辑高可用的一部分:关键任务与回填隔离,回填打满时日报仍有槽。没有池的集群,HA 只保证机器活着,不保证重要任务能挤进去。
四、扩容工单上必须出现的数字
提扩容时附带:当前 queued 时长分位、池占用、数据库锁等待、解析耗时、XCom 表大小、Worker CPU。缺这些数字的工单只是感觉。若锁等待和解析耗时已经高,加 Worker 会让更多进程去问同一本账,数字会更难看。若只是单一队列堆积而库很闲,才加该队列 Worker。
调度器 HA 验收:杀掉当前活跃调度器,看是否在约定时间内恢复建 Run,期间已 running 的任务是否继续,是否出现双写 Run。没做过这次演练的“HA”是配置项,不是能力。数据库切主同样要演:只读窗口 UI 可失败,写入中断必须短,切完后状态机不出现大面积幽灵 running。
回填与在线隔离:回填队列、回填池、回填窗口(避开业务高峰)。高可用保的是在线车次,不是保你能用生产集群把三年历史一次跑完。三年历史应另准备容量或降并发,并接受更长墙钟。把回填当扩展测试可以,当日常不加限制不行。
K8s 资源请求撒谎会导致节点 OOM,实例集体重试,看起来像平台抖动。扩展时把请求写成真实峰值,限制写成硬顶,让调度失败可见(pending),不要让内核杀手在半夜随机选受害者。pending 是诚实,OOM 是谎言被揭穿。
问题:多调度器能不能用来分摊解析?
按官方 HA 设计去理解:目标是接替,不是无限水平加速解析。解析可以有独立的处理器进程与副本,但最终状态仍汇入同一数据库。把“加调度器”当银弹,会忽略文件数量和顶层 IO。减文件、减副作用,比加进程便宜。
问题:Broker 丢消息算不算丢数据?
算丢这次执行机会,不一定丢业务数据——如果任务尚未开始。已经开始但 ack 策略错误,可能重复执行,所以幂等是高可用的一部分。Broker 高可用解决的是队列本身,解决不了“重复执行写了两行订单”。扩展 Worker 与高可用 Broker 都要求任务可重放。
五、雪崩时的限流开关顺序
外部系统开始 5xx 时,先降该队列并发、减池、暂停非关键 DAG、停止回填,最后才重启 Scheduler。反序重启会丢失心跳视野,让更多任务重试,雪崩加速。开关顺序写进值班手册,练习一次。高可用不是让重试更勇猛,是让人能把流量拧小而不拆集群。扩容是雪崩之后的事,雪崩之中加 Worker 等于加炮灰。数据库出现锁等待尖峰时,同样先限流再看查询。扩展章与监控章在这里交汇:没有开关的高可用,只是更多机器一起排队。把开关做成可执行的暂停与池调整,比多买两台调度器更接近“可用”。
六、备份恢复的成功标准
恢复演练不是“备份任务显示成功”。成功标准是:恢复到指定时间点后,能打开某条已知 DagRun,日志仍在或明确说明日志不在备份范围内,连接可解密或明确需要重登记,调度器能继续建新窗而不重复创建已存在的逻辑日期。四条缺一,备份只是文件。Fernet 密钥必须进入恢复剧本,否则抽屉全废。日志若声明不进数据库备份,就要有自己的保留与恢复。演练频率至少在重大版本前做一次。从未演练的高可用,是配置文件里的 HA 字样。字样不能在主库磁盘损坏时顶上。顶上的是你昨晚试过的剧本。剧本里要写清楚谁有权执行恢复,避免事故现场争论权限。权限争论比恢复命令更耗时。耗时的每一分钟,窗口都在合法地闭合,调度器一旦醒来就会问你要不要补。catchup 在恢复后必须确认仍是关。灾难恢复不是补数许可证。
七、扩容工单拒绝清单
缺 queued 分位、缺锁等待、缺解析耗时、缺池占用,四缺任一,工单打回。打回理由是无法判断该加哪一层。无法判断就加 Worker,是默认动作。默认动作在锁高时有害。有害的默认要用拒绝清单打断。打断几次,提工单的人会自己先看图。看图是 4.3 的仪表盘。仪表盘为 4.2 服务。服务关系写在这里,避免监控章变成装饰。装饰性监控加不上正确的机器。正确的机器来自判断。判断来自数字。数字来自工单附件。附件来自拒绝清单。清单是牙齿。牙齿保护数据库。数据库怕更多 Worker 一起问锁。锁是扩展顺序第一课。第一课不及格,不准买机器。买机器很容易。容易的事要关闸。闸在清单。清单在本节。本节与 6.2 共用顺序:减解析、养库、加 Worker。共用要前后一致。一致才不会一章说加、一章说减。减在前。前是清单。清单打回是正常。正常才能让顺序活。活的顺序比 HA 字样有用。HA 字样救不了锁。锁要减负担。负担来自解析与 XCom。XCom 在 2.3。解析在 3.3。扩展在 4.2 只做最后一刀。最后一刀前,工单必须证明前两刀做过。做过的证据是耗时下降或体积下降。下降才配加机器。加机器是奖励。奖励给做过减法的人。没做减法的人得到打回。打回不是刁难。刁难是让锁更高。更高的锁会让所有 DAG 推迟。推迟是全局 SLA 事故。事故比一张被打回的工单贵。贵贱要会算。算清就会写附件。写附件就会看图。看图就会少买错。少买错是高可用的隐藏技能。隐藏技能是拒绝。拒绝在清单。清单要执行。执行靠平台值班。值班拿清单当盾。盾比新机器便宜。便宜的盾要天天用。天天用,扩展才会慢而正确。正确的慢,好过错误的快。快是加错层。错层是 Web 副本。副本治不了锁。锁要清单。清单结束。
八、奖励加机器的前提声明
工单通过拒绝清单后,仍要声明前两刀证据:解析耗时或 XCom 体积曾经下降。没下降过,加 Worker 仍打回。打回理由是顺序未走完。未走完就奖励,会训练出永远不减负担的习惯。习惯有害。有害用声明打断。声明很烦。烦是扩展的美德。美德与监控的烦同类。同类才能让 4.2 与 6.2 一致。一致结束一章加一章减的分裂。分裂结束于清单加声明。声明结束默认加 Worker。默认结束。顺序活着。活着的顺序结束错误的快。快结束于加错层。错层结束。扩展成为最后一刀。最后一刀结束 4.2。4.2 结束买错。买错结束。库喘。喘结束锁。锁结束全局推迟。推迟结束。在线 SLA 活。活结束本节。
要点串联
- 数据库备份与切主是第一高可用
- 调度器 HA 防停摆,不防锁
- Worker 才是吞吐旋钮,但受池和外部限流约束
- Broker 持久化决定 queued 能否活过重启
- 扩展顺序:减解析 → 养库 → 加 Worker
- 演练要按组件分别停,验证状态机
下一节把这些层变成可值班的信号。