3.2 指令编码格式手拆32位
3.2 指令编码格式:手拆 32 位
本节摘要:AArch64 每条指令是固定的 32 比特,助记符只是这串比特的昵称。本节以
add x0, x1, x2的编码 0x8B020020 为标本,把操作码段、寄存器编号段、操作数段逐一拆开,讲清立即数为什么不能是任意值、伪指令的真实身份从编码里如何露馅。学会手拆编码,反汇编三列对照的中间列就不再是天书。
分类骨架立好之后,该上显微镜了。行话里把机器码叫"比特的合同"——处理器与软件之间唯一的契约文本,助记符只是合同的可读副本。副本可以翻译走样,合同不会。这一节的目的就是让你直接读合同:不查指令手册,把一条编码逐段拆出来,说清每个比特在承诺什么。
先破一个迷信:机器码不是加密
很多初学者把十六进制编码当成"加密过的东西",觉得必须工具才能解。这是要破的迷信。定长 32 位编码的全部设计目的,恰恰是让硬件用最少的门电路读懂它——字段位置固定、宽度固定、含义固定,比高级语言好读得多。你要做的只是记住几个模板的位段地图。手头有反汇编器的话,先跑一遍这组对照,后面拆解以它为标本:
汇编 编码 add x0, x1, x2 -> 0x8B020020 add x0, x1, #12 -> 0x9100C020 mov x0, #1 -> 0xD2800001
三条编码三个模板,我们逐个拆。
一、标本一:寄存器形态的加法 0x8B020020
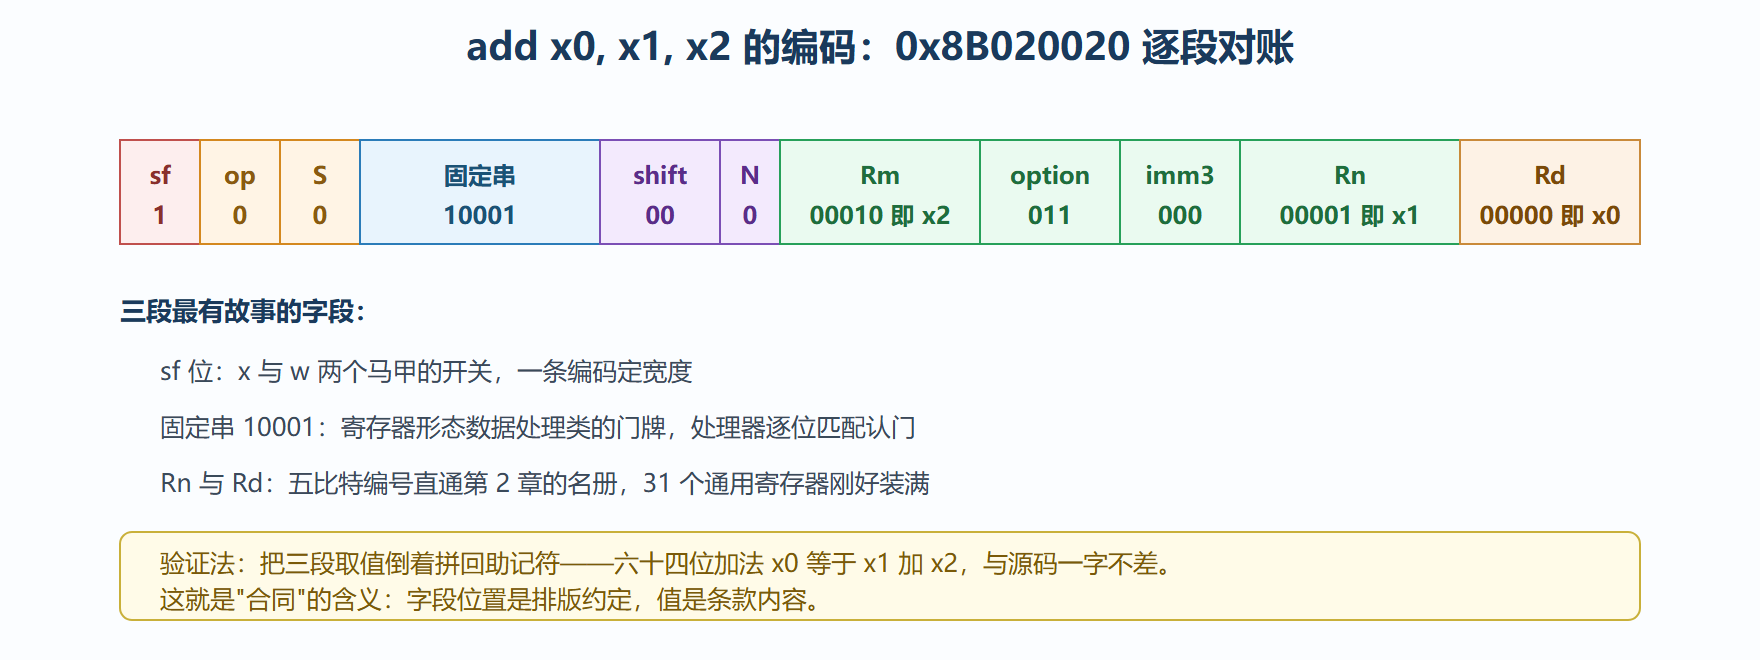
先把十六进制展开成三十二个比特:1000 1011 0000 0010 0000 0000 0010 0000。寄存器形态的数据处理指令按这个地图切分:
比特位: 31 30 29 28-24 23-22 21 20-16 15-13 12-10 9-5 4-0 含义: sf op S 10001 shift N Rm option imm3 Rn Rd 取值: 1 0 0 01011 00 0 00010 011 000 00001 00000
逐段对账:最高位 sf=1 声明六十四位运算(为 0 则是 w 寄存器的三十二位运算——第 2 章"两个马甲"在编码层的落点);op=0、S=0 表示不加不减标志,若是 adds 这一位就是 1;固定串 10001 是"寄存器形态数据处理类"的门牌号,处理器靠它认门;Rm=00010 就是 x2,Rn=00001 就是 x1,Rd=00000 就是 x0——寄存器编号是五比特,所以恰好装下三十一个寄存器,这不是巧合而是设计。中间的 option=011 声明第二源做左移扩展,imm3=000 表示移位量为零。整条指令直译出来:"六十四位、不刷标志、把 x1 加上 x2(不移位),结果放 x0"。合同与助记符,一字不差。
图 3-2:0x8B020020 的位段解剖图
二、标本二:立即数形态与它的"吝啬"
add x0, x1, #12 编码为 0x9100C020。换模板了:固定串从 10001 变成 100010,这是"立即数形态"的门牌。立即数段只有 12 比特——为什么这么吝啬?因为四字节里要同时塞下操作码、两个寄存器编号与立即数,12 位是妥协的产物。为了弥补,设计者加了一个小机关:还有一个 sh 位,置 1 时把 12 位立即数整体左移 12 位再使用。所以合法立即数其实是"0 到 4095 的任意数"或"这个数左移 12 位",其他值编不进去。这解释了一个常见反汇编现象——mov x0, #100000 之类的指令不存在,编译器会改用字面量池:把常数放进内存,用一条 ldr 取进来。伪指令 ldr x0, =100000 就是给这个套路开的语法糖。
逻辑类指令(and、orr、eor)的立即数更"怪":用 N、immr、imms 三个字段联合编码出"位模式循环"——只能表达形如连续 1 再循环移位的模式。设计动机是硬件译码零成本:一段移位器就复现了模式。代价是编程时偶尔碰到"这个常数编不进去"的报错,此时同样退回字面量池。两类立即数的边界不必背,写汇编时让汇编器报错提醒即可——但要看得懂报错背后的原因,知道不是汇编器挑刺,而是合同的格式限制。
三、标本三:伪指令现形 0xD2800001
mov x0, #1 展开是 1101 0010 1000 0000 0000 0000 0000 0001。门牌串是 100101,前缀 opc 为 10——这不是逻辑类,而是 MOVZ 宽立即数移动:一次写入 16 位立即数到半字位置,hw 字段决定放低半字还是高半字。真相是:mov 立即数形态根本没有自己的编码,汇编器按立即数形状自动挑选 movz、movn(取反写入)或 orr 之一。3.1 节说"识破伪指令",在编码层识破的就是这件事。验证的手段很简单——让汇编器输出真实身份:
$ echo "mov x0, #1" | aarch64-linux-gnu-as -o /dev/stdout - 2>/dev/null | aarch64-linux-gnu-objdump -d - 0: d2800001 mov x0, #0x1 $ echo "mov x0, #4097" | ... 同法炮制 0: d2820001 mov x0, #0x1001 // 换成了另一个编码模板
两次 mov 用的门牌不同,助记符却相同——伪指令的本质是"汇编器替你选编码"。
深挖:判零为什么免费
3.1 节提过 cbz 判零即跳,本节有了编码知识可以解释它为什么"免费"。比较一个寄存器与零,不需要真的做减法——硬件只需检测全零信号线。于是 cbz x0, label 的编码里没有任何"与零比较"的运算字段,只有寄存器编号、跳转偏移与判零门牌,空间全留给了 19 位的跳转偏移(覆盖前后约一兆字节)。对照 cmp x0, #5 那样的真比较,后者要动用加法器,编码里也得装下立即数。理解这一点,读代码时就能解释一类现象:编译器把 if (x != 5) 改写成 if (x - 5) 加判零并不罕见——把真比较转成判零,有时能让指令更省。
小练习:用本节的位段地图拆一条 cbz x4, .Ldone 的编码(工具链里随便编一段就有),核对三件事——寄存器字段是不是 00100(x4 的编号)、偏移是不是按"相对当前指令的字数"编码(不是字节数)、最低位固定串是否就是判零类的门牌。三个都对上,位段地图就从知识变成了手感。
本节要点回顾
- 合同观:机器码不是加密,是排版固定的字段集合,助记符只是可读副本。
- 门牌号:每类指令有固定串门牌(如
10001、100010),处理器靠逐位匹配分类。 - 五比特寄存器编号:Rd、Rn、Rm 各占五位,直通三十一个通用寄存器。
- 立即数的吝啬与机关:加法类 12 位加移位开关,逻辑类按位模式循环,编不进就走路字面量池。
- 伪指令现形:
mov立即数按形状自动选 MOVZ、MOVN 或 ORR 模板,编码层没有mov。
编码会拆了,还剩最后一个悬案:为什么会有两套宽度的指令?下一节做 Thumb-2 混编实验,两种编码同场竞技。