4.1 内存访问机制与寻址模式
4.1 内存访问机制与寻址模式
本节摘要:ARM 访存指令的语法浓缩在一个方括号里——零偏移、偏移寻址、前索引、后索引四种写法对应四种地址计算时序,
!写回符决定基址寄存器是否更新。本节把四种模式逐一做实验对照,再顺手解决一个常被忽略的问题:搬运多字节数据时,小端机器上的字节到底怎么排。
第 3 章给访存类只留了一小节篇幅,因为真正的戏都在这里。先把语法说尽——方括号是 ARM 汇编里信息密度最高的几个字符,读反汇编时的困惑一半来自它;再把数据形态说清——你搬的一个四字,在内存里是"反着躺"的。这两件事都吃透,访存语法就毕业了。
方括号语法的全部花样
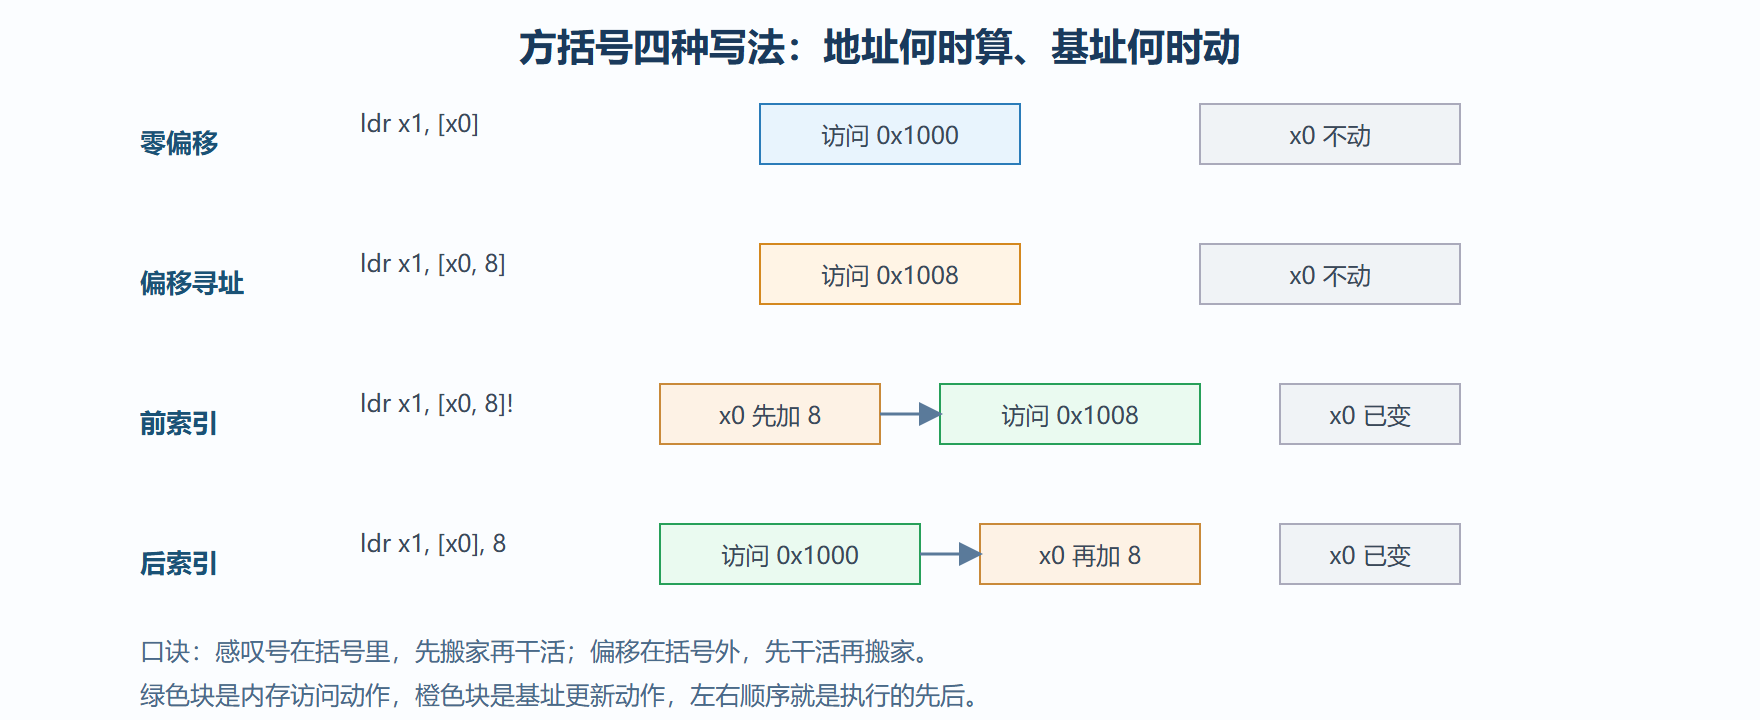
先给结论表,再逐行验证。设基址寄存器 x0 初值为 0x1000:
| 写法 | 名称 | 实际访问地址 | 访问后 x0 | 典型用途 |
|---|---|---|---|---|
ldr x1, [x0] |
零偏移 | 0x1000 | 0x1000 | 最普通的取值 |
ldr x1, [x0, #8] |
偏移寻址 | 0x1008 | 0x1000 | 访问结构体字段 |
ldr x1, [x0, #8]! |
前索引加写回 | 0x1008 | 0x1008 | 指针先移再用 |
ldr x1, [x0], #8 |
后索引 | 0x1000 | 0x1008 | 指针先用后移 |
四种写法的指令文本只差一个 ! 和一个逗号的位置,语义却完全不同——这就是第 1 章说"汇编语义简单但格式严苛"的样本。记忆口诀:感叹号在括号里,先搬家再干活;偏移在括号外,先干活再搬家。逐行用反汇编与寄存器观察验证(模拟器里把 x0 设成一段可读内存的地址):
(gdb) set $x0 = 0x4000a0 (gdb) x/2gx $x0 // 看一眼内存内容,待会核对取回的值 (gdb) si // 单步执行 ldr x1, [x0], #8 (gdb) p/x $x1 // 取到的是旧地址上的值 (gdb) p/x $x0 // x0 已变成 0x4000a8:后索引先取后移
两个高频落点值得单独说。结构体字段访问用偏移寻址:ldr x1, [x0, #24] 取的就是"首地址加 24 字节"那个字段,编译器生成的正是这个形态,读 C 结构体的反汇编时把常量当字段偏移对号即可。数组遍历用后索引:第 1 章的累加循环里那句 ldr x3, [x0], 8 就是后索引——取完当前元素指针自动前进一个元素宽,循环体里省掉一条加法。stp 与 ldp(成对搬运)同样接受这些模式,第 5 章函数序言里 stp x29, x30, [sp, -32]! 就是前索引的经典应用:栈指针先减 32,再把两个寄存器存进去,一条指令完成"开帧"。
图 4-2:四种寻址模式的时序对照
字节序:小端世界的实测
搬运一个字节没有顺序问题,搬运多字节数据就有——一个 64 位整数 0x0123456789ABCDEF 落进内存,字节按什么方向躺?AArch64 在主流配置下是小端:低位字节放低地址。空口无凭,测一次:
(gdb) set var *(long *)0x4000e0 = 0x0123456789ABCDEF (gdb) x/8bx 0x4000e0 0x4000e0: 0xef 0xcd 0xab 0x89 0x67 0x45 0x23 0x01
内存里从低到高是 EF、CD、AB……正好倒序——低位字节 EF 住在最低地址。这就是小端的实锤。三个工程后果要记住:其一,把含多字节整数的结构体按内存原样发到网络或写入文件,接收方如果按大端解读,数据全错,所以跨机协议要显式序列化;其二,某些老网络协议与文件格式是大端,解析时必须逐字段转换;其三,AArch64 的 rev 指令一条完成字节序翻转(rev16 翻转半字内两字节、rev32 翻转字内四字节、rev 翻转全 64 位),解析大端数据时的惯用法是"正常加载加一条 rev",比逐字节拼装快得多。
非对齐访问的边界
顺带交代对齐规则:正常加载存储要求地址与数据宽度对齐(八字节访问地址须是 8 的倍数),非对齐会触发异常。例外是 ldrb 这类单字节访问天然无对齐要求;部分实现支持打开非对齐容忍开关,但裸机代码不要依赖——启动早期 MMU 与对齐检查未配置时,一个非对齐 ldr 就能让处理器 faults。写解析网络包这类天然非对齐的代码时,惯用法是 ldrb 逐字节取再手动拼装,慢但稳。
延伸案例:结构体排布如何改变访存指令的形状
寻址模式与数据布局是一体两面:[x0, #24] 里那个 24 是不是合理的字段偏移,取决于结构体怎么排。做一个对账实验——两个内容相同的结构体定义,字段顺序不同:
struct A { char tag; long value; int score; }; // tag 后垫 7 字节,value 后垫 4 字节 struct B { long value; int score; char tag; }; // 无需垫洞,尺寸更小
反汇编里看访问 value 的代码:访问 A 版本是 ldr x1, [x0, #8],访问 B 版本是 ldr x1, [x0]——偏移为零时编译器直接省掉偏移。把两个结构体各开一百万个的数组遍历计时,B 版本内存占用少近三成,遍历也更快(同缓存行装下的元素更多)。这就是 8.3 节数据布局优化的语法层根源:字段顺序写进 C 的那一刻,访存偏移就定型了。把字段按尺寸从大到小排,是让垫洞消失的通用法则。
常见问答
问:怎么快速判断一台机器的大小端? 答:一行联合体或指针强制转换即可——把 1 存进一个 64 位变量,取最低地址字节,读出 1 是小端、读出 0 是大端。AArch64 常规配置一律小端,但读老 ARM 平台代码时这个检测仍有价值:某些网络设备旧固件按大端解析报文,混编移植时字节序假设必须显式对表。
本节要点回顾
- 四种寻址模式:零偏移、偏移、前索引、后索引,差别在地址计算与基址更新的先后。
!的含义:写回符,前索引专属;后索引天然带基址更新,不需要!。- 结构体与数组的惯用法:字段用偏移寻址,遍历用后索引,开帧用前索引
stp。 - 小端实锤:低位字节住低地址,跨机传结构体必须序列化。
- 对齐是默认契约:非对齐宽访问触发异常,裸机代码用逐字节拼装兜底。
一条指令的语法毕业了。但两个核心同时访问内存时会发生什么?下一节进入一致性与屏障的世界,那里有一个经典的双核撕扯实验等着复现。