4.3 虚拟内存与地址翻译
4.3 虚拟内存与地址翻译
本节摘要:AArch64 的每一笔访存用的都是虚拟地址,MMU 按两级(或更多)页表把它翻译成物理地址,翻译结果缓存在 TLB 里。本节从"为什么需要翻译"讲起,画清 48 位地址的两级翻译路径,讲明
ttbr0与ttbr1各管半边空间,最后做一个从内核日志读懂翻译故障的实验。
前面两节我们默认内存就是一块平坦的空间。从本节起把最后一层包装拆掉:程序看到的地址与内存芯片上的地址根本不是同一套编号。联结两套编号的机构叫 MMU,它跑在每次访存的必经之路上——第 1 章那张下行路径图里 TLB 查询一站,本节把它展开到页表级。
为什么需要翻译
直接给结论的版本:翻译层带来三样东西。隔离——每个进程活在自己的地址空间里,野指针踩不到别的进程;重排——物理内存碎片化无所谓,进程看到的永远是连续的虚拟空间;保护——页表给每页标注可读、可写、可执行,越权访问当场触发异常(还记得第 2 章说"权限问题常伪装成指令问题"?段错误就是翻译层发出的)。代价是每次访存多查一张表——如果每次都真查内存里的页表,访存会慢好几倍,所以翻译结果被缓存在 TLB 里,命中率通常极高。汇编工程师关心的是:翻译对指令集几乎透明(你写的 ldr 语法不变),但裸机启动早期 MMU 未开,那时所有地址都是物理地址;以及翻译故障是真实的运行时事件,内核日志里的页错误都要会读。
两级翻译的路径
AArch64 常用 48 位虚拟地址、4KB 页粒度的配置。翻译分两段走,每段查一级表:
48 位虚拟地址的切分(4KB 页、三级查表示意): [63:48] 符号扩展判断 [47:39] L0 索引 [38:30] L1 索引 [29:21] L2 索引 [20:12] L3 索引 [11:0] 页内偏移
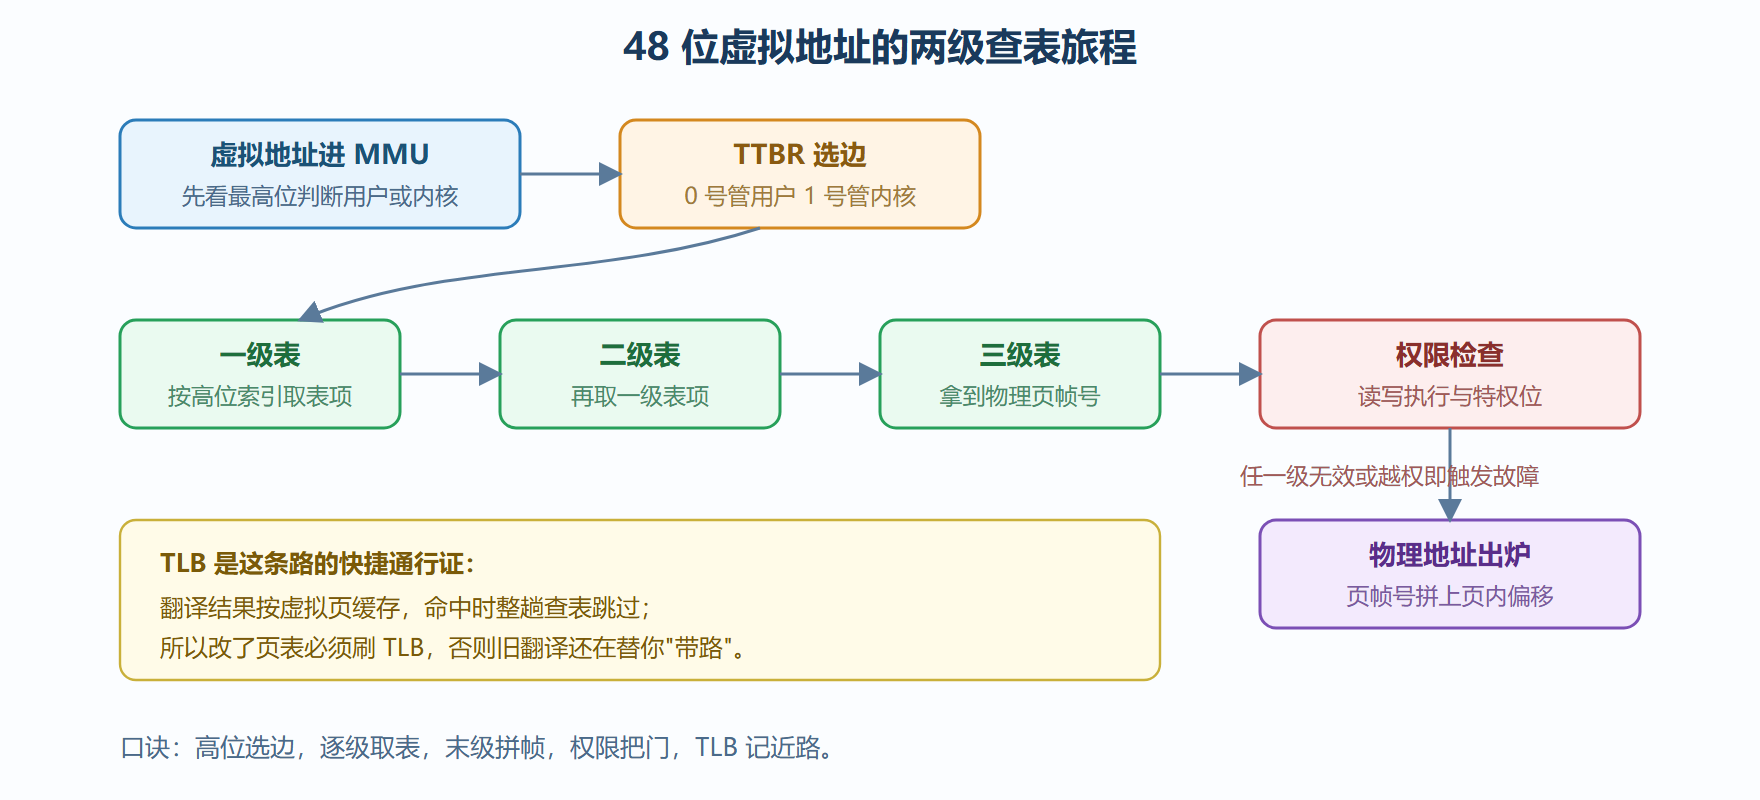
流程:先看最高 16 位全 1 还是全 0——全 0 属于用户空间,用 ttbr0 指的表基址开查;全 1 属于内核空间,用 ttbr1。从表基址出发,按 L0 索引取出一个表项,里面是下一级表的物理地址;再按 L1 索引走下一步,如此到 L3 表项,里面才是最终 4KB 页的物理页帧号;拼上页内偏移,翻译完成。每一级表项里除了下一级地址,还有权限位(可读可写可执行、用户与内核分权)、访问与脏标记、缓存策略提示。任何一级表项标记"无效",或权限检查不过,翻译故障当场发生,处理器跳到向量表的对应项——这就是页错误的出生地。
图 4-4:虚拟地址到物理地址的翻译路径
实验:从一次翻译故障倒推现场
读翻译最好的办法是看它失败。在裸机环境(第 6 章会正式搭)或内核模块里故意访问一个未映射地址,从异常综合寄存器 esr_el1 与故障地址寄存器 far_el1 取现场:
(gdb) p/x $far_el1 $1 = 0x4001000 // 出事的虚拟地址 (gdb) p/x $esr_el1 $2 = 0x96000005 // 解码:数据异常类 EC=0x24 长度级 0 写操作 (gdb) p/x $ttbr0_el1 $3 = 0x4002c000 // 用户空间表基址,可以手动沿位段走一遍查表
解读:esr 的高位段声明这是"数据异常"类别,低位段给出原因码——5 表示"翻译故障,最低级页无效"。把 far 的值按本节开头的位段切开,再沿 ttbr0 的表基址人工走三级查表(用 gdb 读物理内存),你会发现第三级表项确实是无效标记。这一整套动作练熟之后,内核日志里形如"Unable to handle kernel paging request"的报错就不再是咒语,而是可以逐字段对账的记录单。变式:把那个表项手工改成有效并指向一块可读内存,刷新 TLB 后重跑——故障消失,你也从此真正拥有页表。
深挖:两级世界与粗颗粒页的取舍
48 位地址被 ttbr0 与 ttbr1 各管一半的格局,值得再展开一层。用户空间(高位全 0)与内核空间(高位全 1)各有独立表根,带来一个重要工程性质:切换进程只需换 ttbr0,内核的映射纹丝不动——所有进程共享同一张内核页表,上下文切换的页表成本被压到"换半边"。这也解释了内核地址为什么传统上排在地址空间顶端:高位全 1 的形态让它天然与用户指针区分开,用户态传来的野指针进内核一看高位就能拒收。
页粒度也有取舍。4KB 页粒度细、内碎片小,但三级查表长;更大的块描述符(2MB 与 1GB)能在中间层级直接终结翻译——一段 1GB 的连续映射只需一个表项。映射大块内存的数据库与模拟器常用大页压 TLB 未命中率:TLB 条目数固定,每个条目覆盖的地址范围翻千倍,命中率自然上去。代价是内碎片与页面调度粒度变粗——还是那句话,工程是取舍。
读故障日志的进阶对账:esr 里的原因码其实是个小型的"故障分类学"——翻译故障分"地址级"与"权限级"两大族,再按发生层级(第几级表)细分。加上写入还是读出、用户态还是内核态两个维度位,一次 esr 解码能把故障画像缩到很小的范围。建议亲手把一次真实页错误的 esr 全部 32 位展开成字段表贴在工位上——下次线上告警时它就是解码器。
常见问答
问:改了页表为什么老要 dsb 加 isb 连招? 答:改表只是改了内存里的数据,TLB 里还缓存着旧翻译;dsb 确保表项写入真正完成,刷新 TLB 的指令完成后 isb 保证后续取指看到新世界的地址。三步少一步,就可能出现"半新半旧"的翻译——这类问题复现概率低、影响极大,别赌。
本节要点回顾
- 翻译三收益:隔离、重排、保护,代价由 TLB 兜底。
- 两级查表:高位选边(
ttbr0用户、ttbr1内核),逐级索引取表项,末级拼页帧。 - 表项即合同:每级表项带权限位与无效位,故障在查表或权限检查处发生。
- TLB 记近路:改页表必须刷 TLB,
isb同步,否则旧翻译替你带错路。 - 故障会读:
far给地址、esr给原因,两者对照就是排错的对账单。
到此访存章收官:语法、秩序、翻译三层齐了。下一章把镜头转向程序组织——分支、函数调用与栈帧,那里要综合运用本章全部知识。