1.1 Blender架构与插件机制
1.1 Blender 架构与插件机制
本节摘要:Blender 插件机制的本质是"解释层即接口层"——插件不是运行在操作系统上的独立进程,而是运行在 Blender 自研 Python 运行时之上的语义透明代码。本节拆解数据层、执行层、表现层的三层嵌套结构,梳理插件的四种存在形态,并提炼出数据优先、上下文敬畏、非阻塞、版本韧性四条隐性守则。理解这张地图,后面的每一行代码才有落点。
学习目标
阅读完本节,你应当能够:
- 画出 Blender 三层架构草图,并说出每层的职责与代表机制;
- 解释为什么
bpy.data.objects.new()之后物体不一定出现在视口; - 区分 Operator 插件、Add-on、资产插件、几何节点插件四种形态的适用场景;
- 用"数据优先"的视角重写一段依赖
bpy.ops的脚本。
一、从一个问题开始:为什么 Blender 插件是 Python?
为什么 Blender 不像 Photoshop 那样依赖编译好的二进制插件,也不像某些引擎那样强制原生模块?答案不在技术限制,而在哲学选择:Blender 走了一条"解释层即接口层"的道路。插件运行在 Blender 自带的 Python 运行时之上,天然具备三个好处——调试可见(能 print、能断点)、热重载(改完代码重新注册即可)、数据上下文感知(直接读写场景数据)。代价也明确:你不能绕过 bpy 的数据模型去直接操作 GPU 缓冲区,也不能脱离它的事件循环自立线程。这既是限制,也是保护。
把 Blender 想成一家剧场:C++ 内核是舞台机械与灯光总控,Python 是导演能用的对讲系统,插件是导演带来的道具组。道具组再厉害,也得通过对讲机说话,不能自己爬到桁架上接线——不是因为傲慢,而是因为只有走对讲机,调度才知道谁在动什么,演出才不会乱。
二、不可绕行的底层基座:三层嵌套结构
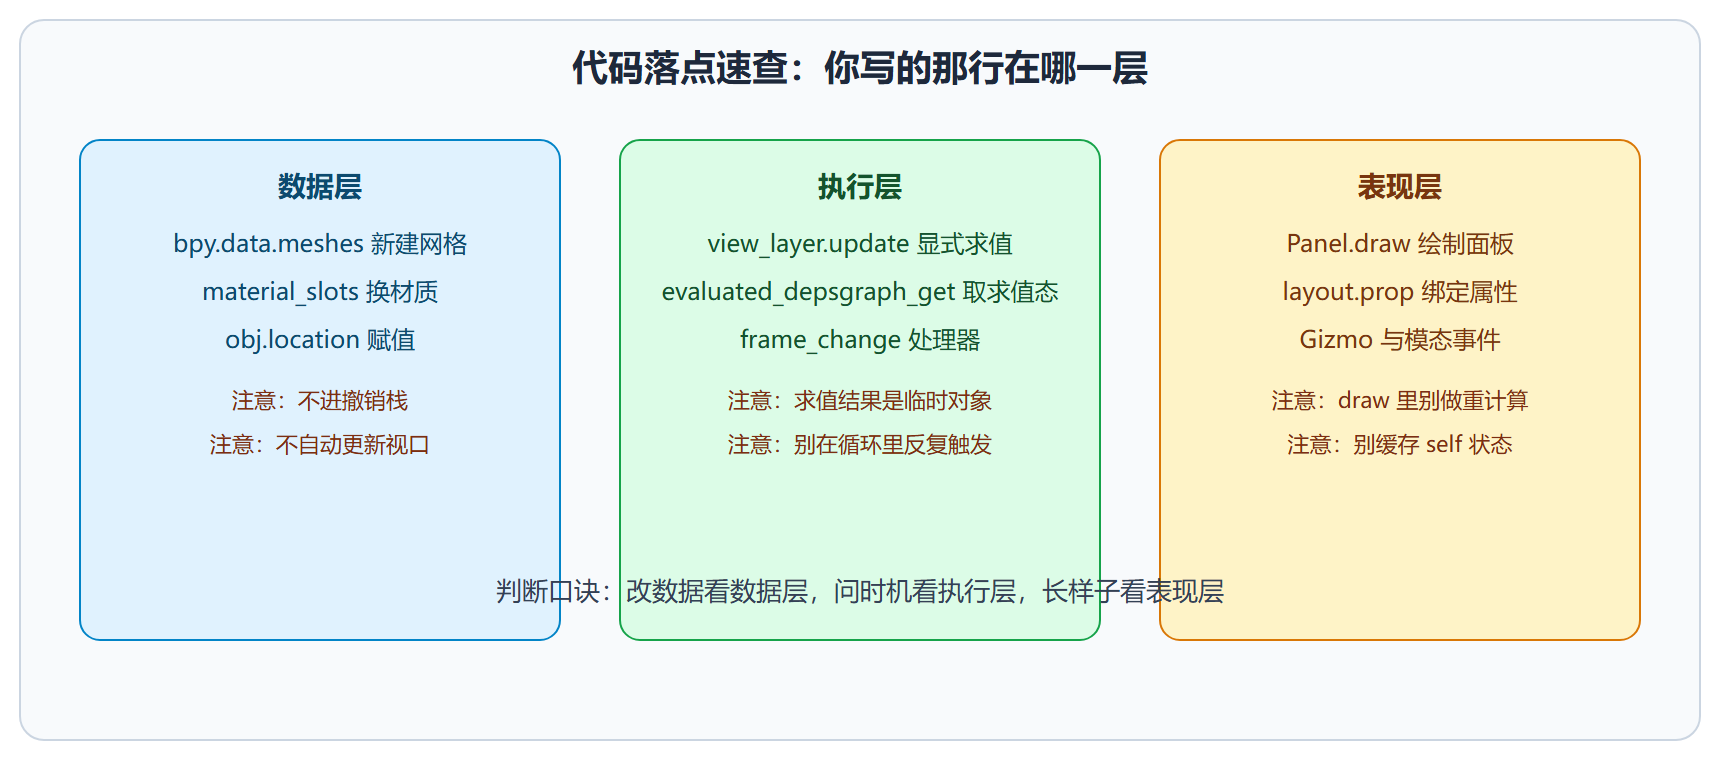
数据层:DNA 与 RNA
最内核的是数据层,由一套高度规范化的 C 结构体构成,社区惯称 DNA。每个 Scene、Object、Mesh、Material 在内存中都对应一块连续的 C 结构体,彼此以指针连成有向图:场景指向集合,集合指向物体,物体指向网格数据,网格再指向顶点、边、面等低阶容器。
这层不直接暴露给 Python,而是经过 RNA 这个元数据反射系统桥接。RNA 不是简单的读写包装器,而是一个动态元描述引擎:每个属性都带着类型信息、取值范围、更新回调、界面标签。bpy.data.objects 看着像 Python 字典,实际是惰性代理对象——首次触达才穿越 Python-C 边界查询并封装。这带来三个推论:属性访问不便宜(第 5 章会量化);类型系统与序列化共用同一份元数据;.blend 文件的存取也以它为准。
执行层:依赖图与事件调度
中间层负责把数据变更变成计算行为,支柱是依赖图(Depsgraph)、渲染管线与事件调度器。现代 Blender 的依赖图是基于数据依赖的有向无环图:你修改一根骨骼的旋转,它并不立刻重算所有子对象,而是把相关节点标记为"脏",在下一帧求值前按拓扑序做最小集更新。
对插件开发者而言,这件事是透明且必须尊重的。它解释了两个常见困惑:其一,bpy.data.objects.new() 只完成了数据层构造,要链接进集合并触发视图层更新,物体才会出现在视口;其二,很多插件的收尾动作是显式更新视图层,那是在主动触发执行层求值。
表现层:数据驱动的动态界面
最外层是用户每天面对的界面:区域、面板、控件由 Python 动态生成的布局树驱动,最终变成 GPU 绘制指令。Blender 的 UI 不是静态模板,而是每次重绘时根据当前上下文重新"问一遍数据"生成的视图。这也是第 3 章的主题。
一句金句:数据层是唯一真相源,UI 只是它此刻的倒影——插件改数据,别改倒影。
三、插件的生命节律:从导入到注销
插件的生命起点是模块导入:启用插件时,解释器执行插件主模块,此时它只是"被加载进内存",尚未激活。真正的激活发生在 register() 被调用时,开发者要在里面完成三类注册:类注册(向类型系统注入 Operator、Panel、PropertyGroup)、属性注册(向 Scene、WindowManager 等数据块挂自定义属性)、处理器注册(把回调挂到帧变更、文件加载等事件钩子上)。注销则是严格的逆序:先摘处理器、再删属性、最后注销类。顺序错了,轻则 UI 残影,重则崩溃。细节在 1.4 节展开,这里先记住骨架。
四、插件的四种存在形态
| 形态 | 典型构成 | 适合场景 | 局限 |
|---|---|---|---|
| Operator 插件 | 若干 bpy.types.Operator 子类 |
批量重命名、清理材质等原子操作 | 无持久状态,跨操作不记上下文 |
| Add-on 插件包 | 注册入口加 Panel、PropertyGroup、Handler | 完整工作流工具(硬表面、散射等) | 复杂度高,需要生命周期管理 |
| 资产插件 | 打包材质、节点组为可检索资产 | 内容分发、团队规范沉淀 | 重在元数据治理而非代码 |
| 几何节点插件 | 动态构建 GeometryNodeTree | 程序化生成、可非破坏编辑的逻辑 | 逻辑暴露给用户,需要更稳的接口设计 |
四者不是平行选项,而是演化阶梯:成熟项目常始于一个 Operator,长成 Add-on,再把核心算法沉淀为资产或节点组。它们的耦合深度递增,对架构理解的要求也递增。
五、架构即契约:四条隐性守则
数据优先。问"我要改什么数据",而不是"我要点哪个按钮"。bpy.ops.object.select_all 便捷但依赖操作符内部状态;遍历选中集合直接改属性才可预测、可测试。养成习惯:在 UI 里看到控件,就追问它绑定的是哪个 RNA 属性、属于哪个数据块。
上下文敬畏。context 不是万能胶水,而是随区域、模式、焦点实时变化的只读快照。context.active_object 在物体模式下有效,某些场合可能是 None。鲁棒的写法是先判空,或用 poll 类方法把环境判断前置。
非阻塞信仰。主循环是单线程的,耗时操作塞进 execute 会冻结整个界面。正解是模态操作器、定时器与后台任务(第 5 章主场)。在一个实时交互的创作环境里,响应性就是尊严。
版本韧性。API 表面稳定、内核语义漂移是常态:顶点访问接口在 3.x 后重构出批量读写接口,单位系统的重写也让个别属性含义微调。专业插件会主动探测 bpy.app.version,为关键调用写兼容层,而不是只适配自己机器上的那一个版本。
⚠️ 常见坑:绕过操作符直接改
mesh.vertices的坐标,改动不进撤销栈,用户按 Ctrl+Z 回不去——这不是 bug,是你没有签署"事务契约"。需要可撤销时,要么走bpy.ops,要么把改动包进自定义 Operator 并声明 UNDO 选项。
💡 关键直觉:把每次
bpy调用都想成"跨越一次解释器边界的问询"。访问越少、越成批,代码越快;问得越散,越慢越脆。
三层结构与典型困惑对照
六、把地图装进口袋
回头看开头的剧场比喻:DNA 是后台的仓库与账本,RNA 是账本的查询索引,依赖图是舞台监督的调度表,UI 是观众看到的演出。插件开发者是道具组——你可以往仓库里放东西、改账本、给调度表提要求,但每一步都要走对应的接口。走接口不是官僚主义,而是让整个系统能记住你做过什么(撤销)、复现你做过什么(存文件)、在你做错时兜底(上下文校验)。
六、深入辨析:三个高频追问
为什么 Blender 选 Python 而不是更快的原生接口?
因为插件生态的第一诉求不是极致性能,而是参与度。解释型接口让艺术家、学生、技术美术——而不是只有系统程序员——都能给软件写扩展;调试可见与热重载把"改一行试一下"的迭代成本压到秒级。性能短板则用分层设计弥补:重活留给 C 内核,Python 只做编排。这个取舍塑造了整个生态的面貌:插件数量庞大、入门平缓、深度上限由对架构的理解决定。第 5 章会讲到,当 Python 真的不够用时,还有原生扩展这条窄门——但那是深思熟虑后的选择,不是默认起点。
修改器、约束、几何节点,插件开发者要都学吗?
按需分层。修改器与约束是数据模型的一部分——哪怕不写自定义修改器,读写它们的参数栈也是日常(给物体加细分、改级别)。几何节点则越来越像"插件的另一种形态":逻辑可视化、参数可动画、非破坏编辑,某些场景下用节点组实现比写代码交付更快。建议的顺序:先掌握用代码操作它们(读写修改器栈、动态建节点树),再考虑是否深入自定义节点。前者是刚需,后者是选修。
数据优先原则会不会让代码变啰嗦?
短期内会——操作符一行搞定的事,数据访问要写三四行。但啰嗦换来的是可预测:不依赖界面状态、可以在无头模式跑、可以被单元测试覆盖。判断标准是代码的消费者:给用户点的入口要体面(操作符),内部管线要可靠(数据访问)。两者不是对立而是分工,成熟插件里通常同时存在,边界清晰。
七、给架构地图补最后一块:版本演进的视角
三层结构是共时快照,加上时间轴才能解释"为什么 API 长成这样"。回望插件机制的演化,三个阶段的跃迁清晰可辨。
早期(2.4 到 2.7 时代)是"脚本即插件":几十行调用拼成一个工具,没有状态管理、没有界面抽象、与生命周期脱节。开发者挣扎于上下文的易失与全局状态的污染之间,如同在流沙上筑塔。转折出现在 2.8 前后:现代界面框架与属性组机制确立,操作符成为事务边界,属性组成为状态契约——插件开始拥有"生命体征",要声明依赖、管理状态、响应事件。Hard Ops 这类标志性插件在此阶段涌现,其代码已具备清晰的分层雏形。最近的阶段可称"生态原生":资产系统、定时器、类型提示支持等特性不再服务于"让插件跑起来",而是致力于"让插件成为宿主的一部分"。
对开发者的启示是:你今天写的每个类、每次注册,都站在第二阶段的遗产上;而你遵守契约的程度,决定了你的插件能否平滑走进第三阶段。架构地图的经线是分层,纬线是演化——两线交叉处,就是你的代码该在的位置。
💡 关键直觉:API 的每次"不方便",几乎都是某次架构权衡的残留。抱怨之前先问"这个设计在保护什么",答案常常就是第 1 章这四条守则里的一条。
一节小结
- 要点一:Blender 插件运行在自研 Python 运行时之上,"解释层即接口层",换来调试可见与热重载,代价是不能绕过数据模型;
- 要点二:三层结构中数据层是唯一真相源,RNA 让 API、UI、序列化共享同一份元数据;
- 要点三:新建对象只完成数据层构造,要链接集合并更新视图层才可见——这是新手第一大困惑的答案;
- 要点四:四种插件形态是演化阶梯,从 Operator 到几何节点,耦合与要求递增;
- 要点五:四条守则——数据优先、上下文敬畏、非阻塞、版本韧性——是后面所有章节反复出现的判断依据;
- 要点六:绕过操作符直接改数据不进撤销栈,事务边界由 Operator 划定。
下一节我们把这套地图落到地上:搭一个不会自欺欺人的开发环境,把调试通道一条条打通。