5.1 性能瓶颈分析与优化
5.1 性能瓶颈分析与优化
本节摘要:在 Blender 中,性能瓶颈不是"CPU 占用高",而是跨层状态不一致的涌现现象——插件逻辑、绑定层、内核、依赖图、GPU 驱动之间的握手成本才是真凶。本节建立七层传导模型,给出执行效率的 Python 层、C 层、异步层三级迁移策略,以及分层计时、内存追踪、帧分析三位一体的诊断工具箱。先测量,后优化,永远不猜。
上手前先明确
阅读完本节,你应当能够:
- 解释一次"简单的属性赋值"背后的跨层传导链;
- 用批量接口替代逐对象循环,并说清快在哪;
- 把计算责任从解释器向内置算子与几何节点迁移;
- 用分层计时定位耗时归属(解释开销、调用开销还是同步等待)。
一、性能不是指标,而是状态
放下"CPU 占用率高就慢"的直觉。Blender 是三层嵌套的异构执行环境:最底层是 C/C++ 内核(几何计算、渲染管线、动画求值);中间是高度定制的 Python 绑定层(把 C 结构体封装成 Python 对象并维持生命周期映射);最上层才是插件逻辑——运行在解释器里,受全局锁制约,却频繁穿越边界调用底层函数。三层之间布满语义断崖与资源鸿沟。
看一个典型场景:遍历所有对象并为每个调用选中设置。表面上只是循环加赋值,实际触发至少五次跨层跃迁——解释器执行循环字节码;对象集合触发 C 层动态构造迭代器;每次调用先经属性代理再跳转 C 函数;C 函数修改状态后还要通知依赖图标记变更;最终排队视口重绘、重建 GPU 命令缓冲。链条上任何一环的延迟都被放大,且各环耗时特性迥异:解释循环是串行等待型,C 调用是高频低延迟型,依赖图与 GPU 同步则是不可预测的异步阻塞型。
由此得出本节的第一原理:瓶颈往往不在单一层,而在层间握手协议的隐式成本。最典型的滥用是在循环里反复触发全量求值——每处理一个对象刷一次视图,总开销从线性退化成平方级,而开发者只看到"循环变慢了",误判为算法问题。
二、Python 层:语义税与它的减免
Python 的动态性是双刃剑。一次对象列表推导,每个元素的取用都要经过 C 层查找、类型检查、对象封装,单次开销几百纳秒——集合里有五千个对象时,光迭代就吃掉大半毫秒,业务逻辑本身可能只占零头。
更隐蔽的是属性访问链。obj.data.vertices[0].co.x 不是一次内存读取,而是四到五次跨层调用:取网格数据块、取顶点集合、索引访问、取向量、取分量,每步都涉及引用计数与空指针检查。实测中,密集顶点操作里这种链式访问比先缓存顶点集合再循环慢好几倍。
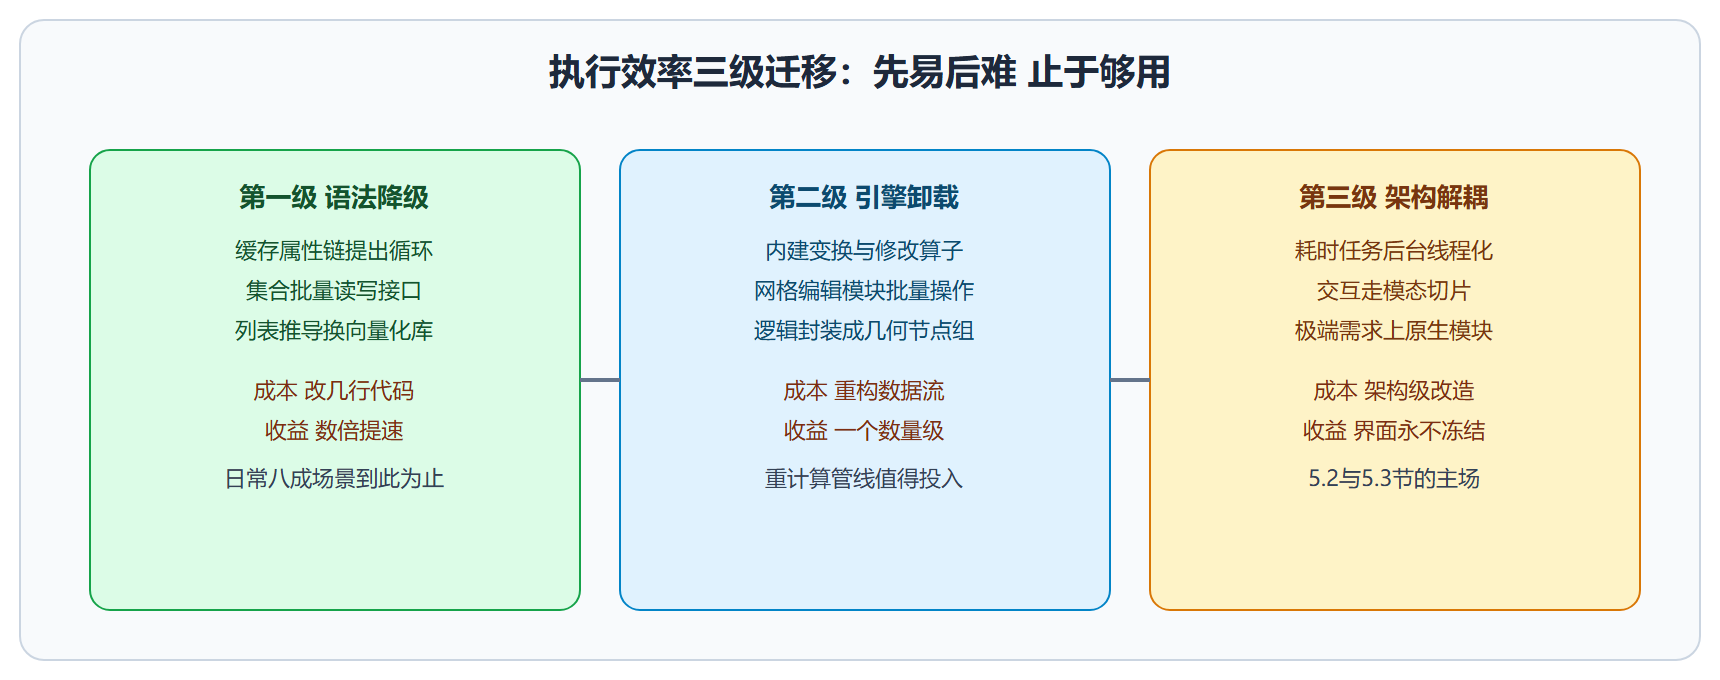
减免手段按力度递进。先降级语法:预缓存反复访问的中间对象,避免循环内重复解链。再用批量接口:集合对象提供批量读写——一次性把属性值拷进连续数组,处理完再整体写回,跨层握手从 N 次变两次:
import numpy as np def offset_vertices_fast(mesh, dz): n = len(mesh.vertices) coords = np.empty(n * 3, dtype='f4') mesh.vertices.foreach_get("co", coords) # 一次跨层拷出 coords[2::3] += dz # 向量化处理 mesh.vertices.foreach_set("co", coords) # 一次跨层写回
最后换领域工具:拓扑级操作交给网格编辑模块(bmesh)——它创建的网格不经主数据注册、免依赖图跟踪,顶点边面以 C 数组驻留,查表后直接寻址,且支持批量操作(一次三角化全部面)。
💡 关键直觉:每次
.都是跨边界问询。循环里出现属性链,就把它提出循环缓存;集合要整体读写,就上批量接口——这两招覆盖八成的日常提速。
三、C 层与异步层:把计算搬到该在的地方
善用内建算子。顶点整体偏移,Python 循环写之外还有内置变换算子——后者在 C 层直接操作坐标数组,规避解释开销且利用单指令多数据加速。基准测试量级:十万顶点抬高一单位,纯 Python 循环四十多毫秒,内置算子个位数毫秒。差距源于计算密度:前者每顶点数次函数调用与类型检查,后者把全部计算压进一次 C 调用,数据在缓存里连续流动。
更进一步的架构级卸载:把复杂几何逻辑(布尔、细分、重拓扑)封装成可复用的节点组,插件只传参数,由几何节点引擎执行(GPU 加速),Python 层退居参数编排。执行效率优化从"代码级"跃升到"架构级"——把计算交给为该领域优化的专用引擎,而不是在通用解释器里硬刚。
异步分层。界面线程单线程,阻塞即冻结。被动方案是把耗时任务切片交给定时器;主动方案是设计时间解耦架构——参数变更只入队不计算,后台线程消费队列做重活,完成后经定时器回主线程更新界面。第 5.2 节整节展开。
四、诊断工具箱:没有测量就没有优化
分层计时。单一只计时函数无法区分耗时属于解释开销、C 调用还是同步等待。在关键路径插入多层打点,分别量出"纯 Python 段""跨层调用段""求值同步段",归属立刻清晰:
import time def profiled_execute(context): t0 = time.perf_counter() data = prepare_data(context) # 纯Python段 t1 = time.perf_counter() result = bpy.ops.mesh.some_operator() # 跨层调用段 t2 = time.perf_counter() context.view_layer.update() # 求值同步段 t3 = time.perf_counter() print(f"python={1000*(t1-t0):.2f}ms " f"c_call={1000*(t2-t1):.2f}ms " f"sync={1000*(t3-t2):.2f}ms")
内存追踪。解释器层的内存热点用标准库的追踪模块定位——启动追踪、跑一遍插件逻辑、输出当前与峰值及按行统计的前几名。但它看不到 C 内存,后者要用专门的调试启动参数让内核输出分配清单(5.4 节详述)。
帧分析。界面卡顿但代码不慢时,嫌疑在 GPU 命令流。帧捕获工具(全平台可用的渲染文档级工具)能揭示:是否重复绑定同一纹理、是否每帧提交了成百上千次细碎绘制。一个真实案例:粒子插件代码只花十二毫秒,帧率却卡在三成——帧分析显示每帧两千多次小批次绘制,GPU 本身只用八毫秒。瓶颈在命令提交带宽饱和而非计算。解法是合并绘制:数据进单个缓冲、一次实例化绘制全部完成,帧率翻数倍。
| 症状 | 首选诊断 | 常见根因 |
|---|---|---|
| 循环慢 | 分层计时 | 属性链未缓存、批量接口未用 |
| 操作后卡一下 | 分层计时的同步段 | 循环内触发全量求值 |
| 内存稳步上涨 | 内存追踪加分配清单 | 数据块未移除、内存池未释放 |
| 代码快但帧率低 | 帧捕获分析 | 绘制调用细碎、重复绑定 |
⚠️ 常见坑:凭感觉优化——没打点就重写"慢"的函数。十有八九真正的耗时在别处(同步等待或绘制提交),重写只是把不慢的代码变难读。
三级迁移路线图
五、性能即设计
回望本节:跨层传导解释了"为什么慢",三级迁移回答了"怎么快",诊断工具箱保证"不瞎快"。但所有技术最终指向一个认知:性能是架构设计的初始约束,不是交付前的补救动作。一个经得起生产考验的插件,架构里必然写着三种性能原语——边界意识(清醒认知每行代码所处的层,选对执行载体)、状态契约(不长期持有数据引用、显式释放资源、按需触发求值)、时间解耦(交互、计算、呈现三条独立时间流,用消息替代调用)。当你的插件在十万面场景保持流畅交互、连续运行八小时内存纹丝不动——你交付的不再是一个工具,而是一个可信赖的创作伙伴。
六、性能优化的决策问答
优化做到什么程度算够?
定预算,不定感觉。给核心交互定硬指标:面板操作反馈不超过一帧、常用操作符完成不超过百毫秒、后台任务不拖慢视口刷新。达标即停,把时间投给功能与稳定性——过度优化与性能不足同样是对用户时间的浪费。指标写进第 6 章的测试,回归时自动报警,性能才不会在迭代中悄悄流失。
向量化改造值得投入多少学习成本?
值得,且优先级高于多数优化技巧。向量化思维(把循环变成数组运算)一旦建立,适用于顶点处理、矩阵变换、颜色批调等几乎所有数据密集场景,且代码更短更清晰。学习曲线主要在理解数组操作的语义(广播、索引技巧),一周上手,终身受益。它是"投入一次、处处收割"的少数技能之一。
缓存是性能银弹吗?
缓存是最常见的优化手段,也是最常见的新 bug 来源:失效策略做错,缓存就从"加速器"变成"错误数据的供应商"。三条纪律:缓存的键必须包含所有影响结果的输入(版本号、参数、依赖对象的标识);失效宁过度勿不足(不确定时重算);永远保留"关缓存"的开关,排查时先关缓存验证逻辑对不对。做完这三条,缓存才是安全的。
⚠️ 常见坑:在模态交互的每个事件里都触发全量求值。事件频率是每秒几十上百次,全量求值随场景规模非线性增长,两者相乘就是掉帧。正确节奏是"标记脏、按需求值"——数据变化只打标记,真正求值推迟到需要读取结果的时刻。
七、性能工作的组织方法
最后讲组织层面:性能工作怎么排进开发流程,而不是沦为"有空再做"。
**建立基线文化。**核心操作符的耗时在每次版本发布前测一遍,记录成趋势表。没有基线的优化是盲人摸象,有基线的优化是有的放矢——某次提交后耗时翻倍,回溯提交记录就能定位。基线表格放进项目文档,让"变慢"成为可见事件。
**预算前置。**设计新功能时先定性能预算("这个面板刷新必须在一帧内"),预算进设计文档。事前定预算是设计约束,事后补优化是债务清算——两者的开发体验与代码质量天差地别。预算不必精确,量级正确就有约束力。
**把已知慢点写进文档。**某些操作在特定场景下就是慢(十万面以上的某类处理),文档里如实标注并给出规模建议。诚实的性能说明是专业插件的名片,掩盖则会在用户的大型场景里变成口碑事故。
本节速览
- 要点一:瓶颈常在层间握手而非某层内部,循环内触发全量求值是平方级退化的头号元凶;
- 要点二:属性访问链是语义税,缓存加批量接口是最便宜的减免;
- 要点三:内建算子与几何节点是 C 级与 GPU 级的合法快车道;
- 要点四:分层计时区分解释、调用、同步三段归属,先测量后优化;
- 要点五:代码快而帧率低,查绘制调用数量与命令提交带宽;
- 要点六:性能三原语——边界意识、状态契约、时间解耦——写进架构而非补丁。
瓶颈已定位,下一节处理其中最恼人的一类:耗时任务如何不冻结界面。