第五章 扩展与自动化边界
第 5 章 · 扩展与自动化边界
本章要回答的三个问题:工具的能力边界在哪里,扩展机制怎么把第三方能力接进来?插件商店琳琅满目,怎么挑、装之前要审什么?哪些测试环节适合交给自动化流水线,哪些交给机器反而亏——边界的判据是什么?
为什么会有这一章
前四章把工具自身的能力讲完了:拦截、重放、批量、扫描、自定义规则。但真实工作里你很快会遇到工具没有内置的东西——私有协议的解析、内部平台的消息格式、与自家工单系统的联动。扩展机制的存在意义就是把这些"你的环境特有"的需求接进工具:它开放了内核的事件流与数据模型,任何会写一点代码的人都能在流量路径上安插自己的处理逻辑。
硬币的另一面是风险。扩展以高权限运行在测试进程内部,看得见你的全部流量包括凭证;商店里的插件来自全球匿名作者,质量与动机参差。所以本章的立场很明确:扩展生态要用,但要像对待供应链一样对待它——来源可信度审查、最小集安装、行为核对。与之配套的是更大的一个判断:哪些环节值得自动化、哪些环节保持人工。这章给出的判据会一直适用到你的整个工程生涯。
读完能解决什么
- 说清扩展的挂载点模型:一个请求在哪些环节可以被插件看到与改写;
- 建立插件选型的审查清单:来源、更新活跃度、权限需求、行为验证;
- 判断一个重复劳动是否值得自动化,用明确的判据而非"感觉很费";
- 搭一条最小可用的自动化流程(触发、执行、结果落地),并知道它不该接管哪些环节。
本章知识点清单
- 扩展挂载点:代理事件、扫描事件、消息编辑、UI 扩展各自的时机与用途;
- 开发路径:从加载数据到最小可用插件的开发与调试方式;
- 供应链审查:插件来源分级、更新与维护信号、高危权限的识别;
- 自动化边界判据:重复性、判定确定性、失败代价三个维度;
- 流水线位置:批量任务触发的定时扫描适合什么场景、不适合什么场景。
各节怎么分工
| 节 | 回答的问题 | 关键产出 |
|---|---|---|
| 5.1 Extender 与扩展API | 扩展怎么挂载、怎么写 | 最小可用插件的认知地图 |
| 5.2 自动化工作流与边界 | 哪些活交给机器 | 边界判据 + 最小流水线 |
图:一个请求经过扩展挂载点的旅程
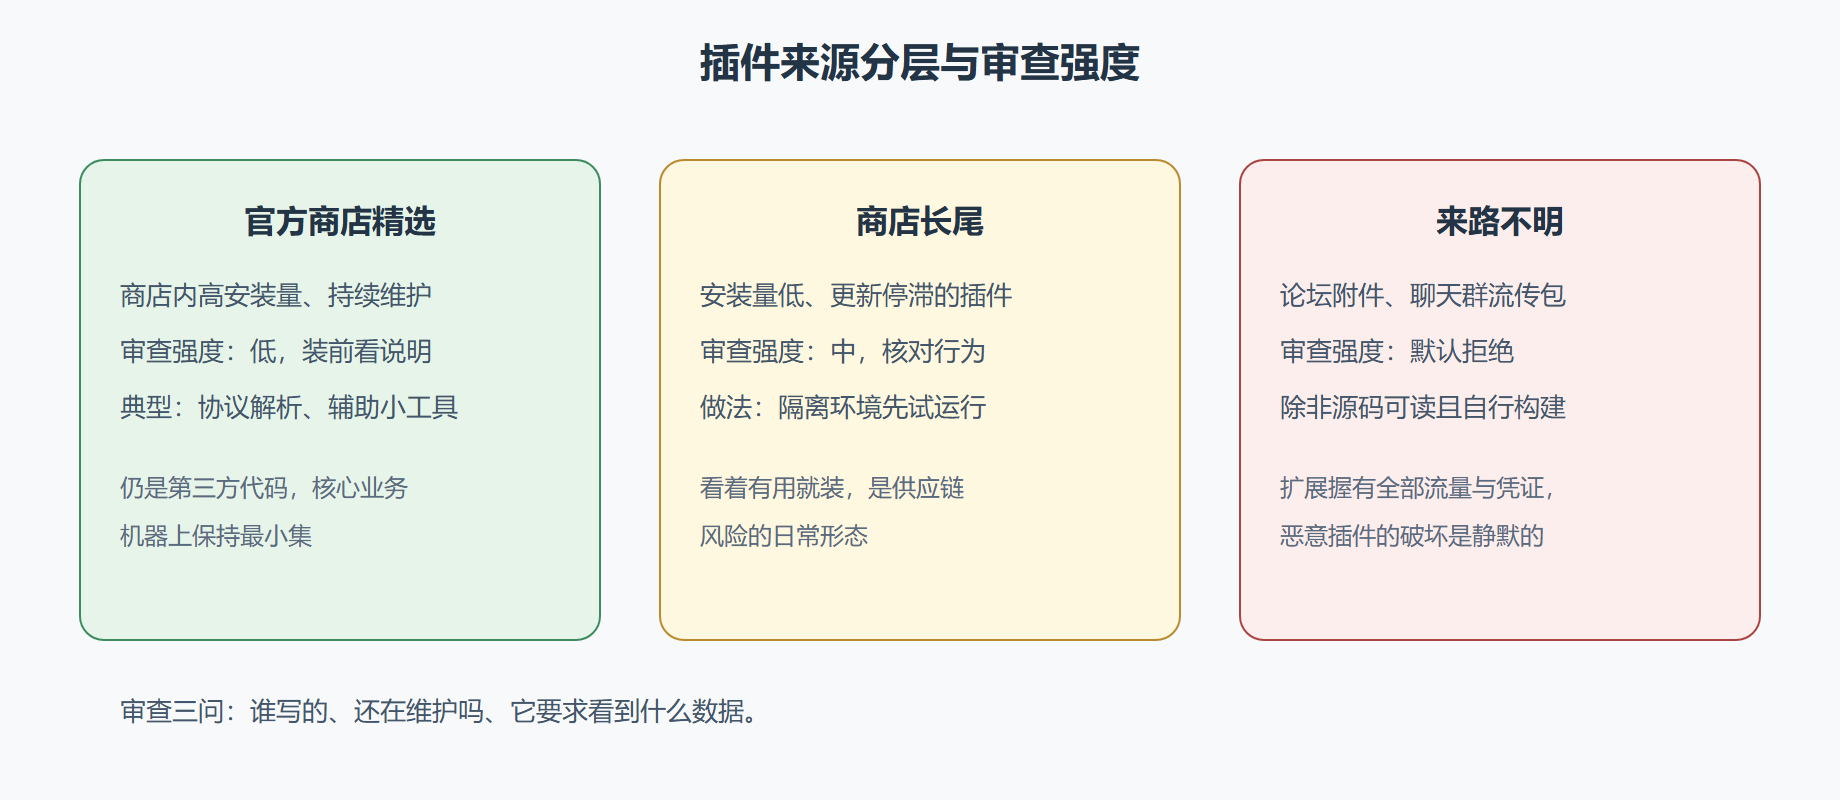
图:插件生态的分层视图
高频疑问先行回答
问:不会编程,这一章还有必要读吗?
答:有必要。本章大半内容与代码无关:挂载点模型帮你理解流量在工具内的旅程,插件审查清单保护你的凭证与数据,自动化边界判据决定你团队的工程投入方向。会编程只在 5.1 节动手写插件时才被需要,而且是"读懂大致结构"级别的。
问:插件到底能访问到什么,风险有多具体?
答:具体到你的全部抓包内容,包括测试账号的凭证、内网接口地址、业务数据。一个恶意插件理论上可以静默外传这一切。这就是本章坚持"来源分级、最小集、行为核对"三个动作的原因——扩展生态的风险模型和供应链安全完全同构。
问:自动化是不是做得越彻底越好?
答:不是。5.2 节的三个判据(重复性、判定确定性、失败代价)就是反着说的:一次性的活不值得自动化,判定靠语境的活自动化不了,失败代价高的活不敢自动化。自动化程度合适与否的检验标准是:出事时人能不能在一分钟内接管。
问:团队里只有自己一个人用这些工具,流程还有意义吗?
答:流程首先是给自己的。一页计划、一份检查单、一套标注习惯,最大的受益者是三个月后的自己——尤其是当你要向别人解释"这个结论怎么来的"的时候。单人也值得有工程化的工作方式,这是职业与爱好的分界。
章内练习路线
本章的练习与前几章不同,产出物是流程资产而不是漏洞条目。5.1 节的练习是装一个商店插件并完整走一遍审查清单,把审查结果写成几行记录;有余力再用脚本语言写一个只读标注插件。5.2 节的练习是纸面上的:拿你自己的例行动作清单过一遍三筛,标出哪些值得自动化、哪些明确不该——这份判断本身比任何插件都有长期价值。两节合起来回答的是同一个问题:工具的能力边界在哪,你的流程该在哪里接手。
先决条件
- 前四章的模块机理已通,理解流量在工具内的路径;
- 本章不要求编程能力,但 5.1 节的示例按"能读懂大致结构"的深度讲解。
往下走到哪
能力拼图至此完整。第六章转换视角:把前三十章的产出——疑点、条目、证据——加工成一份能推动修复的报告,并从蓝队角度反推检测规则。工具是手段,推动修复才是这门手艺的目的地。