1.2 核心定位与 CAP
1.2 核心定位与 CAP
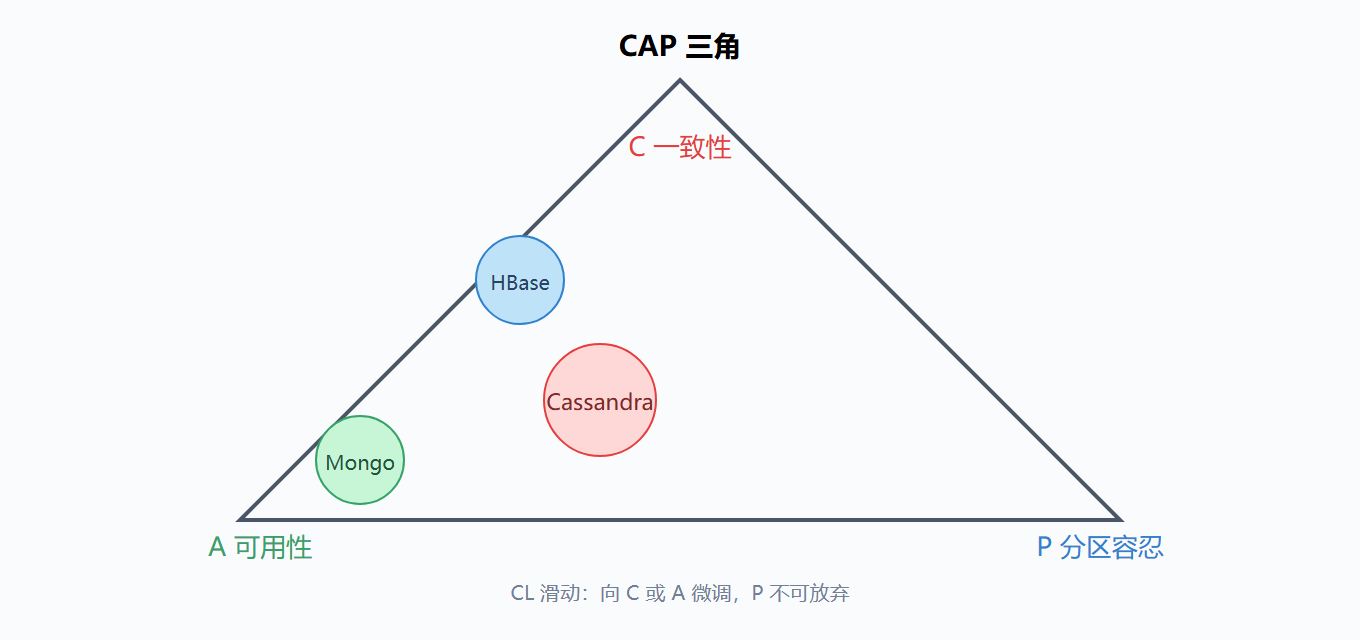
本节摘要:CAP 对 Cassandra 是坐标系而非「三选二判决书」。默认锚定 AP,通过一致性级别(CL)与复制因子 R 实现 W+R≥N 下的有界陈旧;
LOCAL_QUORUM规避跨 DC 延迟。本节对照 MongoDB 读偏好与 HBase 线性化读。
本节目标
阅读完本节,你应当能够:
- 解释 W+R≥N 如何保证 QUORUM 读看到 QUORUM 写
- 区分
ONE、QUORUM、LOCAL_QUORUM、ALL的延迟与容错 - 说明 Read Repair、Hinted Handoff、Anti-Entropy 三层收敛机制
- 指出 AP 选型在可见性、因果序、分布式事务上的代价
一、问题与直觉
银行核心账务要「写完立即可查」;IoT 埋点允许秒级延迟。同一公司两种 SLA,却常被塞进一种 CL。Cassandra 的答案不是统一强一致,而是每次读写由客户端声明 CL——像给每次操作贴 SLA 标签。MongoDB 用 readConcern/writeConcern 近似这一思想,但仍有主节点选举窗口;HBase 默认强一致读,牺牲的是分区时的可用性。
二、核心原理
W+R≥N 规则(R 为副本总数):若写用 W = ⌊R/2⌋+1(QUORUM),读也用 QUORUM,则读写 replica 集合必交,读到的是最新写入或更新版本(在无并发写冲突时)。
| CL | 所需 ACK | 典型场景 | vs Mongo/HBase |
|---|---|---|---|
| ONE | 1 | 指标、日志 | Mongo w:1;HBase 不常用 |
| QUORUM | ⌊R/2⌋+1 | 通用 OLTP | 接近 majority |
| LOCAL_QUORUM | 本地 DC 法定人数 | 低延迟多 DC | Mongo 无原生 DC CL |
| ALL | R | 批量导入 | HBase 同步复制更重 |
最终一致性靠四层机制收敛(SOURCE 1.2):
- LWW + 时间戳:每列带 timestamp,冲突取最大
- Read Repair:读时比对副本,异步写回最新
- Hinted Handoff:目标节点短暂离线,协调者代存 hint
- Anti-Entropy Repair:Merkle Tree 比对,周期性全量/增量修复
-- 同一 keyspace 不同表可用不同 CL(SOURCE 2.2) CONSISTENCY LOCAL_QUORUM; UPDATE users SET last_login = toTimestamp(now()) WHERE id = 1001; CONSISTENCY ONE; INSERT INTO user_events (user_id, event_type, ts) VALUES (1001, 'click', toTimestamp(now()));
LWT(Lightweight Transactions) 用 Paxos 实现 IF NOT EXISTS,3.x 起支撑库存扣减——这是 Cassandra 在 AP 基座上开出的「有条件强一致」窗口,代价是延迟约为普通写 3–5 倍。
三、工程实践要点
CL 与 R 联动:R=3 时 QUORUM=2;若业务要容忍 1 节点永久故障仍 QUORUM 写,R 应升到 5。盲目 CL=ALL 在 R=3 下任一节点 GC 停顿即写失败。
跨 DC:NetworkTopologyStrategy + LOCAL_QUORUM 让读写在本地 DC 闭环;EACH_QUORUM 用于全球共享权威数据(汇率),延迟显著上升。
与 PostgreSQL:需要 Serializable 隔离与 FK 时,应保留 PG 作事务源,Cassandra 作事件/宽表副本,而非单库硬扛。
⚠️ 常见坑:
WriteTimeoutException后不确定是否写入——业务必须幂等,或用 LWT 包裹关键路径。
💡 关键直觉:Cassandra 把一致性从「数据库全包」改成「每次操作的显式参数」——这是 AP 系统最诚实的接口设计。
核心回顾
- CAP 是坐标系;Cassandra 默认靠近 A+P,C 由 CL 按需购买
- W+R≥N 是 QUORUM 语义的可证明基础
- 四层收敛(LWW/Read Repair/Hint/Repair)弥补异步复制
- LOCAL_QUORUM 是多 DC 低延迟的默认选择
- LWT 提供 Paxos 级 CAS,不是通用分布式事务
- Mongo/HBase/PG 分别偏向可调副本、强读、ACID——选型看契约对齐
下一节展开去中心化、线性扩展与多 DC 如何成为上述 CAP 选择的工程后果。
演练:三种 CL 的延迟与故障行为
在 RF=3、跨 2 个 DC(本地 2 副本 + 远端 1 副本)的集群上实测:
| CL | 需 ACK | 本地 RTT | 远端 RTT | 故障容忍 | 适用 |
|---|---|---|---|---|---|
| ONE | 1 | 1× | 0 | 0 节点 | 日志、指标 |
| LOCAL_QUORUM | 2(本地) | 2×并发 | 0 | 本地 1 节点 | 多 DC OLTP |
| QUORUM | 2(任意) | 可能含远端 | 1×跨 DC | 1 节点 | 全局权威数据 |
| EACH_QUORUM | 每 DC 2 | 每 DC 各 2× | 跨 DC 等待 | 每 DC 1 节点 | 汇率、航班状态 |
| ALL | 3 | 全部 | 全部 | 0 节点 | 批量导入 |
-- 同一 keyspace 按表分层,是 CL 组合使用的标准姿势 CONSISTENCY LOCAL_QUORUM; -- 账户余额:本地强一致 SELECT balance FROM accounts WHERE id = 8801; CONSISTENCY ONE; -- 浏览历史:可容忍陈旧 INSERT INTO view_history (uid, item_id, ts) VALUES (8801, 'sku-9912', toTimestamp(now()));
结论:多 DC 场景 LOCAL_QUORUM 的 P99 通常比 QUORUM 低一个数量级,因为远端 RTT 被彻底移出关键路径。
推演:W+R≥N 的数值计算
设 RF=5(N=5),写 W=3,读 R=3。因为 3+3>5,两个操作必有一个副本相交,交点上存着最新版本或更新版本——这就是 QUORUM 读写「必见」的数学依据。若 W=2, R=2,则 2+2=4<5,存在两个不相交的 2 副本集合,读可能错过最新写。
| W | R | N | W+R≥N | 读必见写 |
|---|---|---|---|---|
| 3 | 3 | 5 | 6≥5 ✓ | 是 |
| 2 | 2 | 5 | 4<5 ✗ | 否 |
| 1 | 5 | 5 | 6≥5 ✓ | 是(读全副本) |
| 3 | 1 | 5 | 4<5 ✗ | 否 |
LWT 的适用边界
-- Lightweight Transaction:Paxos 级条件写,仅用于关键路径 UPDATE inventory SET stock = stock - 1 WHERE sku_id = 'sku-9912' AND stock > 0 IF EXISTS AND stock > 0;
LWT 底层走 Paxos,延迟约为普通写 3–5 倍,且会临时占用串行化配额(concurrent_lwt_requests)。适合扣库存、注册手机号、分布式锁这类「必须原子」的小操作;不适合批量扣减、跨分区转账(应回退应用层 Saga 或 PostgreSQL 事务)。用 LWT 前先问:如果数据可以重算,是否还需要线性一致性?
故障恢复场景复盘
把三个真实故障场景逐一遍历,观察 CL 如何决定「谁会痛、谁没事」:
| 场景 | 写侧 | 读侧 | 恢复后 |
|---|---|---|---|
| 单副本磁盘满,写 CL=QUORUM | 仍成功(另 2 副本 ACK) | 读到旧数据,触发 Read Repair | 修复磁盘后 hint 回放 |
| 机架交换机故障,影响 1/3 副本 | QUORUM 仍可写 | LOCAL_QUORUM 读正常 | Merkle 比对后流式补数 |
| 全 DC 网络分区 | QUORUM 写失败,业务降级 ONE | 读本地 DC 副本 | 分区愈合后 anti-entropy |
-- 分区期间的降级写入:接受短期丢数据的代价换可用性 CONSISTENCY ONE; INSERT INTO audit_log (id, op, ts) VALUES (uuid(), 'degrade-write', toTimestamp(now()));
复盘结论:Cassandra 的 CAP 答案不是「永远一致」,而是「给每种故障预配一种 CL 响应」。业务方在架构评审时应当把这张表填完,而不是笼统说「我们要强一致」。