3.2 主键设计与分布
3.2 主键设计与分布
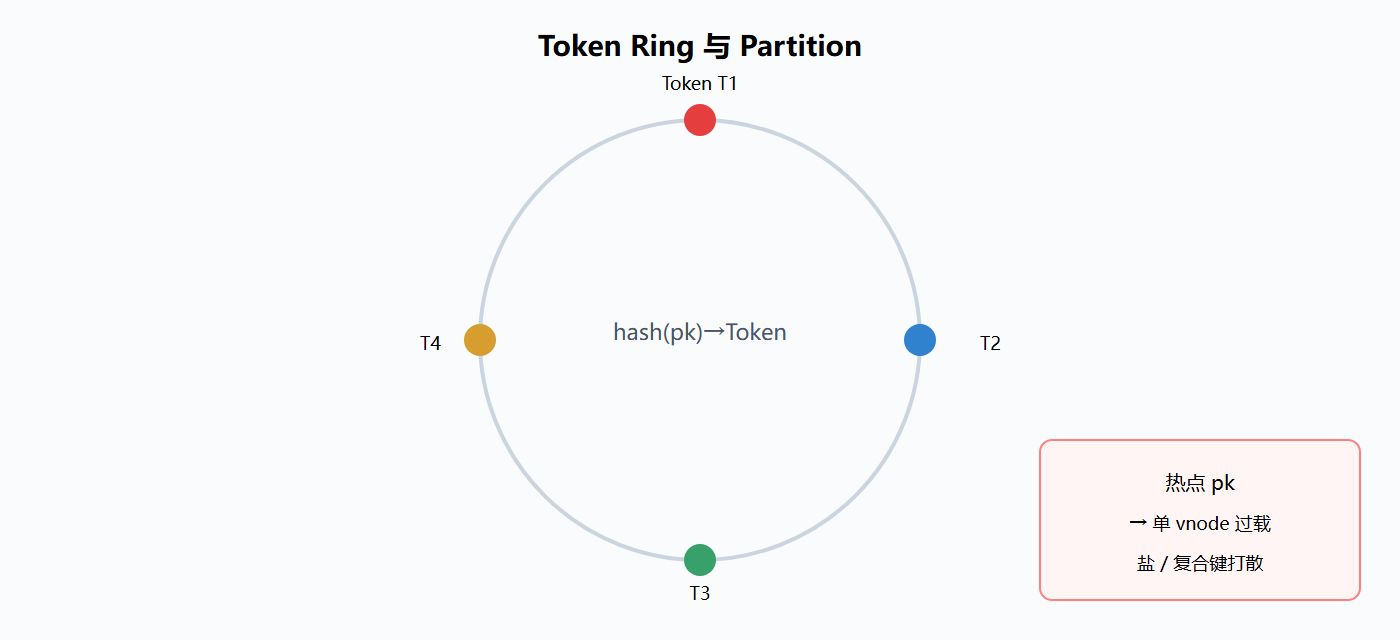
本节摘要:Partition Key 经 Murmur3 决定数据落哪个 vnode;Clustering Key 仅分区内排序。复合键、盐、时间桶是治理热点的三件套。对照 HBase RowKey 反转与时间前缀、Mongo 分片键选择。
本节导航
阅读完本节,你应当能够:
- 设计
(partition_key, clustering_key)并预测 co-located 查询 - 用
nodetool tablestats发现大 partition 与 skew - 解释加盐 partition 的读写代价
- 对比 HBase RowKey 与 Cassandra partition key 设计异同
一、问题与直觉
电商「全国单日订单 ID 自增」作 partition key——所有新订单 hash 到相邻 token,三台机器吃满 80% 写。HBase 老手会在 RowKey 前加 salt/reverse timestamp;Mongo 选 shard key 也要避单调递增。Cassandra 同样:key 的选择 = 负载均衡 + 查询能力 的联合优化,没有事后索引能救。
二、核心原理
单键 vs 复合 partition key:
-- 按用户查订单 OK;按日期查全站订单 FAIL PRIMARY KEY (user_id, order_id) -- 按日期分区 + 用户 clustering:适合日报表 PRIMARY KEY ((day, bucket), user_id, order_id)
盐(bucket):bucket = user_id % 16 打散热点用户,代价是按 user 查询需 fan-out 16 个 partition——常建第二张「用户视角」表(查询驱动双表)。
| 模式 | partition | clustering | 典型查询 |
|---|---|---|---|
| 用户时间线 | user_id | event_time DESC | 某用户最近事件 |
| 设备时序 | device_id | ts | IoT 曲线 |
| 日历聚合 | (day, region) | metric | 区域日报 |
大小限制:单 partition 建议 < 100MB / 10 万列级;超过则 flush/compaction 与 repair 都痛。HBase 单 Region 类似上限思维。
三、工程实践要点
诊断:nodetool tablehistograms 看 partition size 分布;驱动层 TokenAwarePolicy 让协调者与 replica 同机减少 hop。
时间序:timeuuid 或 timestamp clustering + TWCS;避免只用 timestamp 作 partition(易热点「当前秒」)。
与 PostgreSQL:需要 ad-hoc 多维分析时,CDC 到 OLAP(ClickHouse/BQ),Cassandra 只作写路径。
⚠️ 常见坑:把 UUID v1 作 partition key——时间前缀导致顺序写热点。
💡 关键直觉:partition key 选错 = 集群 scale-out 失效;clustering key 选错 = 单次查询变慢。
核心回顾
- Murmur3 + vnode 映射物理节点
- 复合 partition 平衡查询与均衡
- 加盐 治热点,常需第二张表
- 大 partition 是 repair/compaction 杀手
- HBase RowKey 设计 问题域相似,语法不同
下一节用「查询驱动」方法论串起多表设计与反模式清单。
推演:三种主键方案对比
以「电商订单」为例,三种设计对应三种查询能力:
| 方案 | PRIMARY KEY | 支持查询 | 缺陷 |
|---|---|---|---|
| A | PRIMARY KEY (order_id) |
按订单查 | 无法按用户查 |
| B | PRIMARY KEY (user_id, order_id) |
按用户+订单查 | 无法按时间扫 |
| C | PRIMARY KEY ((user_id, day), order_id) |
按用户+天查 | 跨天需并查 |
-- 方案 C 的落地:复合分区键 (user_id, day) CREATE TABLE orders_daily ( user_id text, day date, order_id text, amount decimal, PRIMARY KEY ((user_id, day), order_id) ); -- 查询"某用户某天订单" SELECT * FROM orders_daily WHERE user_id = 'u-7788' AND day = '2024-08-14'; -- 查询"某用户近 7 天订单"需要 7 个分区并行查(fan-out)
结论:Cassandra 没有万能主键,只有「匹配你的查询清单」的主键。设计时先写查询,再反推键结构,这就是查询驱动建模的核心。
演练:热点分区诊断
# 查看每个分区的大小分布(最直接的热点信号) nodetool tablehistograms shop.orders_by_user # 关注 Partition Size 一行的 p99/p100,若与中位数差几个数量级 → 热点
-- 定位大分区(诊断用) SELECT user_id, count(*) FROM shop.orders_by_user WHERE user_id = 'u-7788'; -- 只查已知热点用户
热点治理三件套:加盐(拆 partition key)、时间桶(按天/小时切分区)、拆行(把聚合对象拆成多行)。加盐是最后手段,因为它牺牲「按原 key 查询」的便利,常需配套第二张视角表。
加盐与双表模式实操
-- 用户视角表:按 user_id 查(fan-out 16 个盐桶) CREATE TABLE orders_by_user_salted ( salt int, -- 0..15 user_id text, order_id text, amount decimal, PRIMARY KEY ((salt, user_id), order_id) ); -- 订单视角表:按 order_id 直查,一桶一分区 CREATE TABLE order_by_id ( order_id text PRIMARY KEY, user_id text, amount decimal );
# 应用层写入:写两张表,保证数据最终一致 salt = zlib.crc32(user_id.encode()) % 16 session.execute("INSERT INTO orders_by_user_salted ... ", (salt, user_id, ...)) session.execute("INSERT INTO order_by_id ... ", (order_id, user_id, ...))
双表一致性靠应用层补偿(如失败重试、Kafka 重放),没有跨分区事务。这是查询驱动建模的常态:冗余数据 + 显式同步,换取每种查询都有最优路径。
主键设计的边界与极端情况
时间作分区键的陷阱:把 ts 直接作分区键会导致「当前时刻」成为热点——所有写入同时涌向一个分区。正确做法是时间作聚类键,分区键用设备/用户等天然分散维度。
UUID v1 的陷阱:UUID v1 带时间前缀,顺序生成会造成 token 单调递增,同一时刻落在相邻 vnode,形成写入热点。用 v4 随机 UUID 或业务自然键作分区键。
超大分区:单分区超过 100MB 或 10 万行会让 Compaction、repair、读归并全部退化。诊断后按时间桶拆分:把 PRIMARY KEY (user_id) 改 PRIMARY KEY ((user_id, month), ts)。
-- 时间桶拆分的完整示例 CREATE TABLE events_monthly ( user_id text, month text, -- '2024-08' ts timestamp, payload text, PRIMARY KEY ((user_id, month), ts) ); -- 跨月查询需要应用层并查多桶再合并
与 HBase RowKey 的对照:HBase RowKey 反转(reverse timestamp)也是治热点的老手段,本质与 Cassandra 时间桶一致;区别在于 Cassandra 把这种选择语法化为 PRIMARY KEY 的括号结构,而 HBase 靠手工拼字符串。语法不同,思考同源。
一张图记住主键心智模型
PRIMARY KEY ((分区键, 分区键), 聚类键, 聚类键) └─决定数据在哪个节点┘ └─分区内排序┘ 等值查询条件 = 精确指定 范围查询上限/下限
一句话总结:分区键回答「数据在哪」,聚类键回答「分区内怎么排」。设计顺序永远先分区键(负载均衡 + 等值查询),再聚类键(排序 + 范围查询)。两者都定错,集群能跑但查询全错;只定错聚类键,损失的是查询效率而非分布均衡——优先级上先保分区键正确,再优化聚类键。