第4章 · 集群运维
第4章 · 集群运维
章节摘要:生产 Cassandra 靠 Snitch + NTS 把拓扑写进配置,靠 repair 维持 Merkle 一致,靠 快照 做备份。扩缩容用 bootstrap/decommission/rebuild。本章合并安全管理(RBAC、加密)与备份恢复。
先说结论
阅读完本章,你应当能够:
- 完成最小生产集群的
cassandra.yaml与 rackdc 配置 - 执行 add node、decommission 与
nodetool repair - 使用 snapshot + sstableloader 恢复流程
- 启用 PasswordAuthenticator 与 inter-node TLS 要点
核心概念速览
Cassandra 没有「一键扩缩容」——
nodetool是 DBA 的母语。
子章节导航
4.1 部署与配置
JVM 堆、数据目录、seed、并发线程池。
4.2 扩缩容与修复
Streaming、Incremental Repair、Reaper。
4.3 备份与安全
快照、Offsite、Role、加密。
子章节之间的逻辑关系
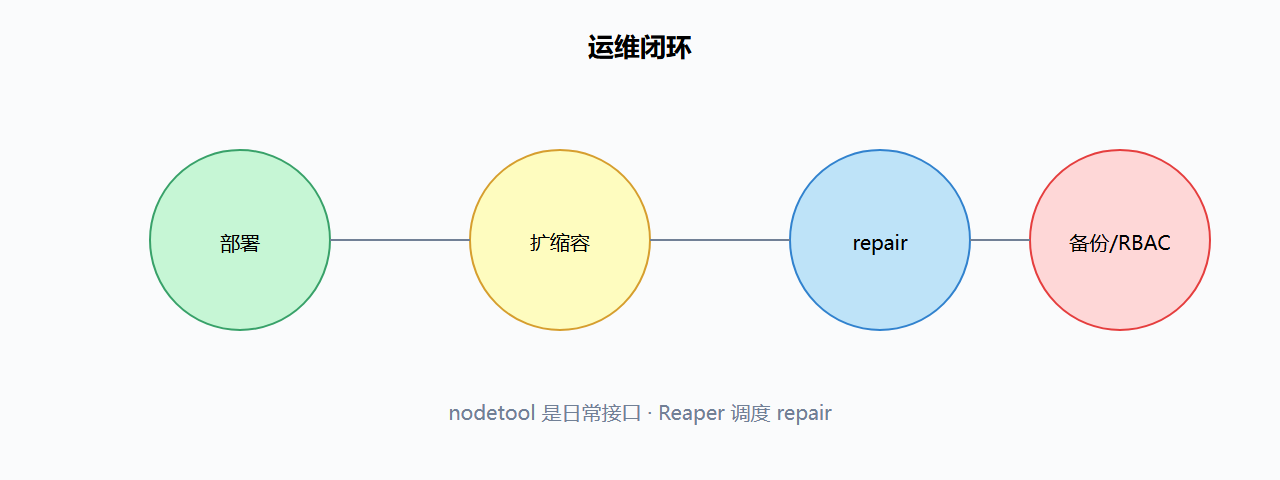
正确拓扑 → 平滑扩缩 → repair 保一致 → 快照兜底 + 安全合规
前置知识与后续延伸
- 前置:第2章 复制与 Gossip;第3章 keyspace
- 延伸:第5章 GC 与 Compaction 调优
运维日历与值班清单
| 周期 | 动作 | 命令 / 工具 | 验证目标 |
|---|---|---|---|
| 每日 | 节点状态巡检 | nodetool status |
全部 UN |
| 每日 | 延迟与 GC 监控 | Prometheus + Grafana | P99 平稳 |
| 每周 | 增量 repair | nodetool repair -inc / Reaper |
Merkle 差异清零 |
| 每月 | 全量 repair 抽检 | nodetool repair -full |
分区愈合 |
| 每季度 | 恢复演练 | snapshot + 恢复脚本 | RPO/RTO 达标 |
| 每季度 | 版本升级评估 | 阅读 release notes | 确认补丁基线 |
# 值班第一条命令:秒级判断集群健康 nodetool status # 若出现 DN(Down Normal),优先看系统日志定位崩溃原因 grep -i "error\|fatal" /var/log/cassandra/system.log | tail -20
常见疑问答疑
三副本还要备份吗? 要。副本防「节点宕机」,备份防「逻辑错误、误删、勒索软件」——后者会让所有副本同步变坏。副本是冗余,快照才是时间点恢复的唯一手段。
repair 为什么不能不做? 因为 Cassandra 的复制是异步的,分区、GC 停顿、短暂离线都会造成副本间差异,差异不清理会持续累积,最终在故障恢复时引发读修复风暴。repair 是异步复制模型的闭合环,不是可选项。
加节点为什么有「阵痛期」? streaming 迁移数据占用带宽与 I/O,与 Compaction 争抢磁盘,表现为写入延迟暂时升高。缓解手段是限速、避开高峰期、按 vnode 小步迁移。
K8ssandra 和裸机部署选哪个? 团队已有 K8s 平台与 operator 经验选 K8ssandra;追求最小依赖与极致性能选裸机/VM。两者对 Snitch、repair、备份的要求一致,只是编排层不同。
术语速查
| 术语 | 一句话定义 | 章节 |
|---|---|---|
| Snitch | 节点到 rack/DC 的拓扑映射 | 4.1 |
| Bootstrap | 新节点加入并 streaming 数据 | 4.2 |
| Decommission | 节点退出并迁出数据 | 4.2 |
| Incremental Repair | 只修差异 token 段的增量反熵 | 4.2 |
| Reaper | 定时调度 repair 的开源工具 | 4.2 |
| Snapshot | 基于硬链的秒级快照 | 4.3 |
| sstableloader | 离线导入 SSTable 的工具 | 4.3 |
| RBAC | 基于 ROLE 的授权体系 | 4.3 |
进入第5章前的自测
# 完成一次"看状态—做备份—跑 repair"的完整演练 nodetool status nodetool snapshot -t drill_$(date +%F) nodetool repair -inc
能答出三问即可继续:其一,repair 与 gc_grace_seconds 的关系;其二,为什么换节点要 replace_address 而不是直接删旧加新;其三,快照恢复后为什么还要 repair。