第5章 · 性能与选型
第5章 · 性能与选型
章节摘要:性能问题半数在 JVM GC 停顿 与 Compaction 积压;优化靠 G1 参数、批写、缓存与 CL 降级。选型章用数据契约框架对照 MongoDB、HBase、PostgreSQL、DynamoDB。
本节导读
阅读完本章,你应当能够:
- 配置 G1GC 与
memtable_heap_space_in_mb避免 Full GC 伤 CL - 使用
UNLOGGED BATCH、async 驱动与 Key Cache responsibly - 读懂
nodetool tablestats与 Prometheus 核心指标 - 填写 Cassandra vs Mongo/HBase/PG 选型决策表
核心概念速览
800ms Full GC 一次,QUORUM 超时重试可能把负载翻倍——性能是分布式事件。
子章节导航
5.1 JVM 与 GC 调优
堆、G1、GC 与 Gossip/CL 的耦合。
5.2 读写性能优化
批写、缓存、speculative retry、压缩策略。
5.3 竞品对比与选型
一致性/操作/演化三维契约 + 决策表。
子章节之间的逻辑关系
GC 稳定 → 写读路径可调 → 对照业务契约选型
前置知识与后续延伸
- 前置:第2章 LSM;第4章 部署
- 延伸:DataStax Astra 云托管、Pulsar/Kafka CDC 集成(生产架构)
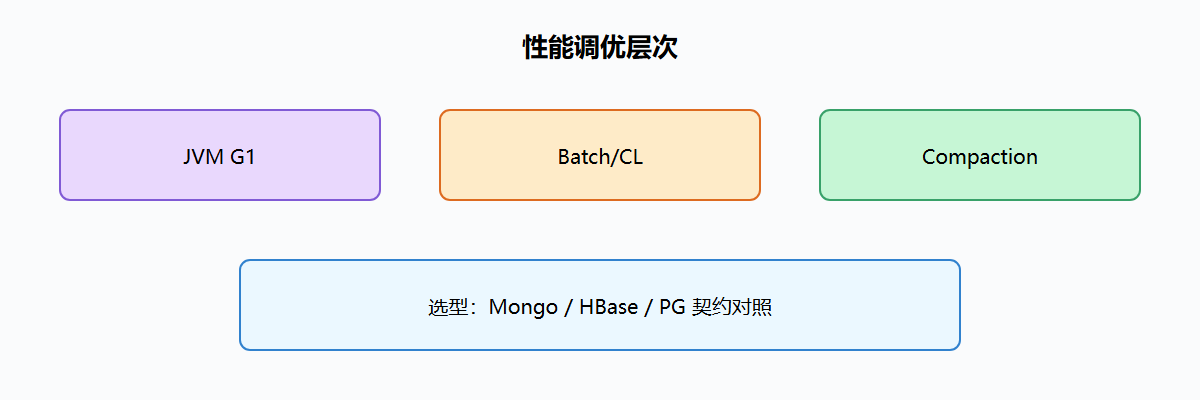
调优决策速查表
| 症状 | 首选动作 | 次选 | 禁忌 |
|---|---|---|---|
| 写 P99 毛刺 | 检查 GC 停顿 | 调大 concurrent_writes | 无脑加堆 |
| 读延迟升高 | 查 SSTable 数量 | 切 LCS / 加 Key Cache | 全表加索引 |
| Dropped Mutations | 查磁盘 I/O | 降 CL | 忽略继续发版 |
| 跨 DC 慢 | 换 LOCAL_QUORUM | 客户端路由本地化 | QUORUM 硬扛 |
| Compaction 积压 | 限速 + 错峰 | 切 TWCS/降低写放大 | 手删 SSTable |
# 性能问题先看三屏:GC、Compaction、Dropped jstat -gcutil <pid> 1000 # GC 实时状态 nodetool compactionstats # Compaction 积压 nodetool tpstats | grep Drop # 丢弃消息
常见疑问答疑
为什么堆推荐 8GB 封顶? 堆越大,G1 Full GC 的标记与回收时间越长,GC 停顿伤害 Gossip 心跳与 CL 超时。Cassandra 的吞吐靠堆外缓存(Bloom、Key Cache)与磁盘,不靠大堆。需要更多容量就加节点,而不是加堆。
UNLOGGED BATCH 到底省了什么? 省的是「多次 RPC 的协调开销」——同分区多行合并成一次协调。跨分区的 BATCH 不省协调,反而因协调者逐条路由而更慢,且 LOGGED BATCH 还带 Paxos 级日志。
Key Cache 和 Row Cache 什么区别? Key Cache 缓存「key 到 SSTable 偏移」的定位信息,Row Cache 缓存整行数据。Key Cache 命中省一次读盘,Row Cache 命中省整个查询。Row Cache 内存贵且一致性维护复杂,生产默认关。
二级索引为什么别乱建? 高基数(如 email)字段建索引,查询时索引扫描返回大量候选分区,性能反而不如全表过滤;写侧还有额外写放大。SAI 改善了实现,但没有改变「建模放错位置」的本质。
术语速查
| 术语 | 一句话定义 | 章节 |
|---|---|---|
| G1GC | 分区化垃圾收集器,4.x 推荐 | 5.1 |
| STW | Stop-The-World 全暂停 | 5.1 |
| Off-Heap | 堆外内存(Bloom/Key Cache) | 5.1 |
| UNLOGGED BATCH | 同分区批量写 | 5.2 |
| Key Cache | key 定位缓存 | 5.2 |
| Speculative Retry | 多副本抢答降 P99 | 5.2 |
| LWT | 条件写,Paxos 级 | 5.2 |
| 数据契约 | 一致性/操作/演化三维对齐 | 5.3 |
收尾自测
# 验证你对全册五个章节的串联理解 cqlsh -e "CONSISTENCY LOCAL_QUORUM; SELECT * FROM shop.orders LIMIT 1" nodetool status nodetool repair -inc
能答出三问即完成本教程:其一,从写入到读回,数据经历了哪些组件的协作;其二,出现写超时你会按什么顺序排查;其三,给一个业务场景,你能完整走完「查询清单 → 建表 → 部署 → 调优」的决策链。