5.3 竞品对比与选型
5.3 竞品对比与选型
本节摘要:选型看数据契约对齐:一致性契约、操作契约、演化契约(SOURCE 7.3)。Cassandra 锚定最终一致 + 灰盒运维 + 显式 schema;与 HBase(强读+ZK)、Mongo(文档+主节点)、PostgreSQL(ACID)占据不同象限。
上手前先明确
阅读完本节,你应当能够:
- 用三维契约解释为何「功能清单选型」常失败
- 填写 Cassandra/Mongo/HBase/PG 决策表
- 列举应选 Cassandra 与应避 Cassandra 各三条
- 说明 LWT 不能替代 PostgreSQL 事务的场景
一、问题与直觉
架构评审问「Cassandra 支持 JOIN 吗?」——问错维度。该问:「业务能否接受 QUORUM 写后 100ms 内其他 DC 读不到?能否承担 weekly repair?查询是否都已列清单?」Netflix 选 Cassandra 因全球多活会话;某创业公司只有 500GB 订单且要复杂报表,PostgreSQL + 只读副本更便宜。Mongo 4.x 多文档事务覆盖部分中间地带,但分片+跨 region 运维仍重。
二、核心原理
三维契约(SOURCE 7.3):
| 契约 | Cassandra | MongoDB | HBase | PostgreSQL |
|---|---|---|---|---|
| 一致性 | 可调 CL,默认 AP | 副本集 majority | 强一致读 | ACID |
| 运维 | nodetool 灰盒 | ops 工具链 | ZK+Master | 成熟 DBA |
| 演化 | 查询驱动多表 | 灵活 schema | RowKey 难改 | 迁移友好 |
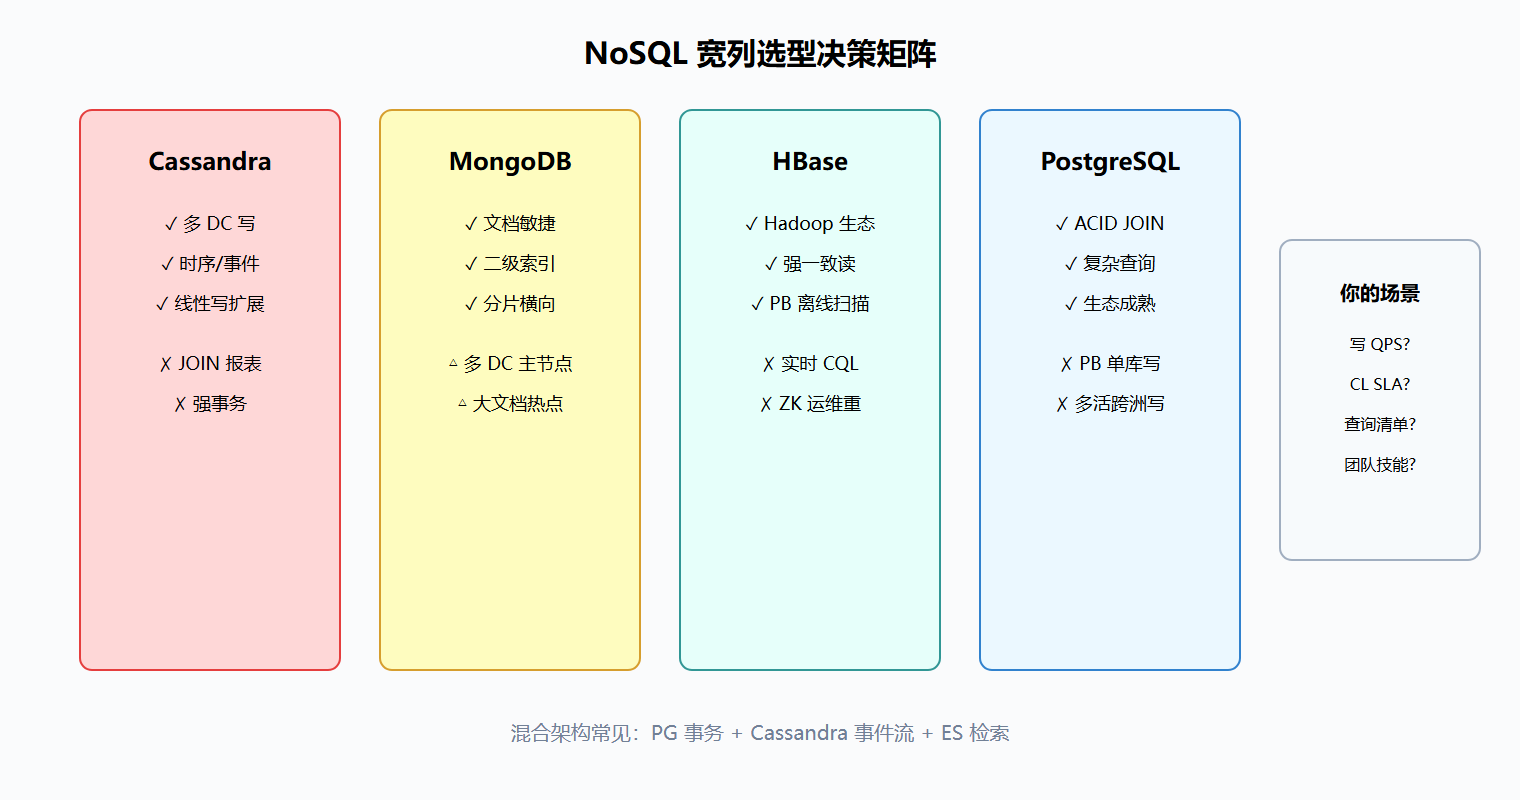
与 HBase(SOURCE 7.3):同源 Bigtable/LSM;HBase 强协调、MapReduce 亲和;Cassandra 无主、Kafka/微服务亲和。离线 ETL 选 HBase;在线多活 OLTP 宽列选 Cassandra。
与 MongoDB:文档灵活 vs 宽列固定 schema;Mongo 主节点选举窗口;Cassandra 无单点写入口。内容管理偏 Mongo;时序指标偏 Cassandra TWCS。
与 PostgreSQL:PG 作 system of record,Cassandra 作 append-only 事件/telemetry 是常见 混合栈。勿用 LWT 硬做跨行转账——应用 Saga + PG 更稳。
三、工程实践要点
选 Cassandra 信号:全球多 DC 写、查询路径稳定、可接受 repair 运维、IoT/日志/会话、每秒 10 万+ 写。
避 Cassandra 信号:频繁 ad-hoc 分析、强 FK、库存强一致且无 Saga、团队零分布式经验且数据 <1TB。
PoC 检查项:48h 压测 + 故障注入(kill 节点)+ repair 演练 + 建模评审。
⚠️ 常见坑:因「听说 Netflix 用」而选——业务是区域只读报表。
💡 关键直觉:选型 = 契约谈判;Cassandra 卖的是 AP 写扩展,不是 SQL 兼容。
本节速览
- 三维契约 优于功能 checkbox
- Cassandra = AP + 灰盒 + 查询驱动 schema
- HBase 偏离线强读;Mongo 偏文档敏捷;PG 偏事务
- 混合架构 往往比单库万能更诚实
- LWT 是补丁,不是 PG 替代品
本教程五章至此——从 CAP 到 LSM 到 CQL 到 repair 到选型,构成 Cassandra 对比驱动知识闭环。
决策:三个真实选型案例
案例 A:全球物联网平台。要求 10 万台设备每秒上报指标、多区域就近写入、查询固定(设备最近 N 条)。契约对齐:AP 可接受、查询路径固定、写入高并发——选 Cassandra(TWCS 管理 TTL)。Mongo 也能存,但写入扩展与跨区多活要手动分片,成本更高。
案例 B:订单交易系统。要求库存强一致、跨表事务、复杂报表。契约对齐:需要 ACID 与 JOIN——选 PostgreSQL,Cassandra 只能做订单历史归档与风控特征表。LWT 补不上多表事务的洞,硬上等于自掘坟墓。
案例 C:内容管理平台。文档结构频繁变化、查询条件多变、单机容量够。契约对齐:schema 灵活 > 写扩展——选 MongoDB。Cassandra 的固定 schema 会让每次字段变更变成一次迁移。
-- 案例 A 的最终 schema(对应选型落地) CREATE KEYSPACE iot WITH replication = { 'class': 'NetworkTopologyStrategy', 'ap-east-1': 3, 'eu-west-1': 3 }; CREATE TABLE telemetry ( device_id text, ts timestamp, payload text, PRIMARY KEY (device_id, ts) ) WITH CLUSTERING ORDER BY (ts DESC) AND default_time_to_live = 864000;
混合栈架构模式
写入路径: 业务 → Cassandra(写优化存储) 分析路径: Cassandra → CDC → Kafka → ClickHouse / PostgreSQL(OLAP) 强一致子集: PostgreSQL(事务源)→ 同步到 Cassandra(读副本)
| 模式 | 分工 | 数据流 |
|---|---|---|
| 主写 + 归档 | PG 事务,Cassandra 归档 | PG → CDC → Cassandra |
| 主写 + 分析 | Cassandra 写入,OLAP 分析 | Cassandra → CDC → OLAP |
| 双写 | PG 权威,Cassandra 热读 | 应用双写 + 补偿 |
# 数据同步工具选型 cdc: Debezium / Kafka Connect batch: sstableloader / Spark 导入
混合栈不是「逃避选型」,而是承认单库无法同时满足 ACID 事务与海量写扩展。Cassandra 的价值在其中被精确限定:承担「高并发、固定查询、可接受陈旧」的那一部分。边界画清楚,架构才可信。
PoC 验收清单
| 检查项 | 验收标准 |
|---|---|
| 写吞吐 | 达到目标 QPS,P99 稳定 |
| 故障注入 | kill 1 节点,写不中断(CL 合理) |
| 故障恢复 | repair 后差异归零 |
| 建模评审 | 全部查询走 PRIMARY KEY |
| 运维演练 | 备份/恢复/扩容全流程跑通 |
| 成本核算 | 与备选方案总拥有成本对比 |
# 故障注入验收的一条命令 nodetool stopdaemon # 模拟宕机,观察集群写是否中断
PoC 的终态不是「能跑」,而是「能救」:写吞吐、故障恢复、备份恢复三项全部达标,才值得签选型结论。这份清单也同时是架构评审时的提问模板——任何一项答不上来的候选方案,都不该进生产。
选型的反直觉时刻
「我们数据很大,所以选 Cassandra」是常见的伪需求。数据量大分两种:一种是单机放不下、查询固定、写入持续增长——真需求;另一种是数据大但能压缩归档、查询随意、一天只写几百万行——PostgreSQL 分区表更合适。Cassandra 的线性扩展是有成本的,规模不够大时,运维成本远高于省下的「扩展性」。
「需要多活,选 Cassandra」也要拆开看。跨 DC 多活的前提是每个 DC 的本地读写闭环(LOCAL_QUORUM),业务能容忍跨 DC 同步延迟与冲突收敛。如果业务要求「任何 DC 写、任何 DC 立刻读到同一版本」,那是 EACH_QUORUM 的领域,延迟与可用性都有限——此时反而要考虑是否为真实需求。
「Cassandra 不支持 SQL,开发难」是过时的印象。CQL 对熟悉 SQL 的团队上手门槛低,难的不是语法而是「分布式建模思维」:先列查询、接受冗余、放弃 JOIN。培训成本通常集中在前两周的建模训练,之后效率不输关系库。
-- 反直觉判据的落地:问自己三个问题 -- 1. 查询清单能在两周内写完且不再变吗? -- 2. 业务能接受 LWW 冲突收敛吗? -- 3. 团队愿意维持 repair 与备份纪律吗? -- 三个都是"是"才选 Cassandra,否则回到 PG/Mongo 更稳妥
选型不是比拼功能数量,而是对齐「运维能力 × 业务契约 × 团队纪律」三者。Cassandra 是对纪律要求最高的 NoSQL——它能给你线性写扩展,同时要求你接受固定查询、管理 repair、忍受 LWW。想清楚这个交换,再决定要不要上船。