5.1 集群架构模式
5.1 集群架构模式
本节摘要:ClickHouse 的分布式是"分片 + 副本"模型。分片把数据水平切分到多节点扩容,副本给每个分片做冗余容错。本节讲清这套架构,以及本地表与 Distributed 表的分工。
上手前先明确
阅读完本节,你应当能够:
- 区分分片与副本,说清各自解决什么问题
- 解释"写本地表、读分布式表"的分工
- 画出一个 2 分片 2 副本的集群拓扑
- 理解 ClickHouse 分布式的松散耦合特性
一、分片与副本:两个正交维度
很多人把分片和副本混为一谈,其实它们是两个正交的维度,解决不同问题:
- 分片(shard):把数据水平切分到多个节点,解决容量和写入吞吐问题。数据量太大单机放不下、写入太快单机扛不住,就加分片。
- 副本(replica):给同一份数据做冗余拷贝,解决可用性和读吞吐问题。一台挂了另一台能顶、读请求多可以分摊到副本,就加副本。
一个分片可以有多个副本,一个集群可以有多个分片。比如"2 分片,每分片 2 副本"就是 4 个节点:分片 1 有副本 A、B,分片 2 有副本 C、D。
图 5-1 分片与副本拓扑
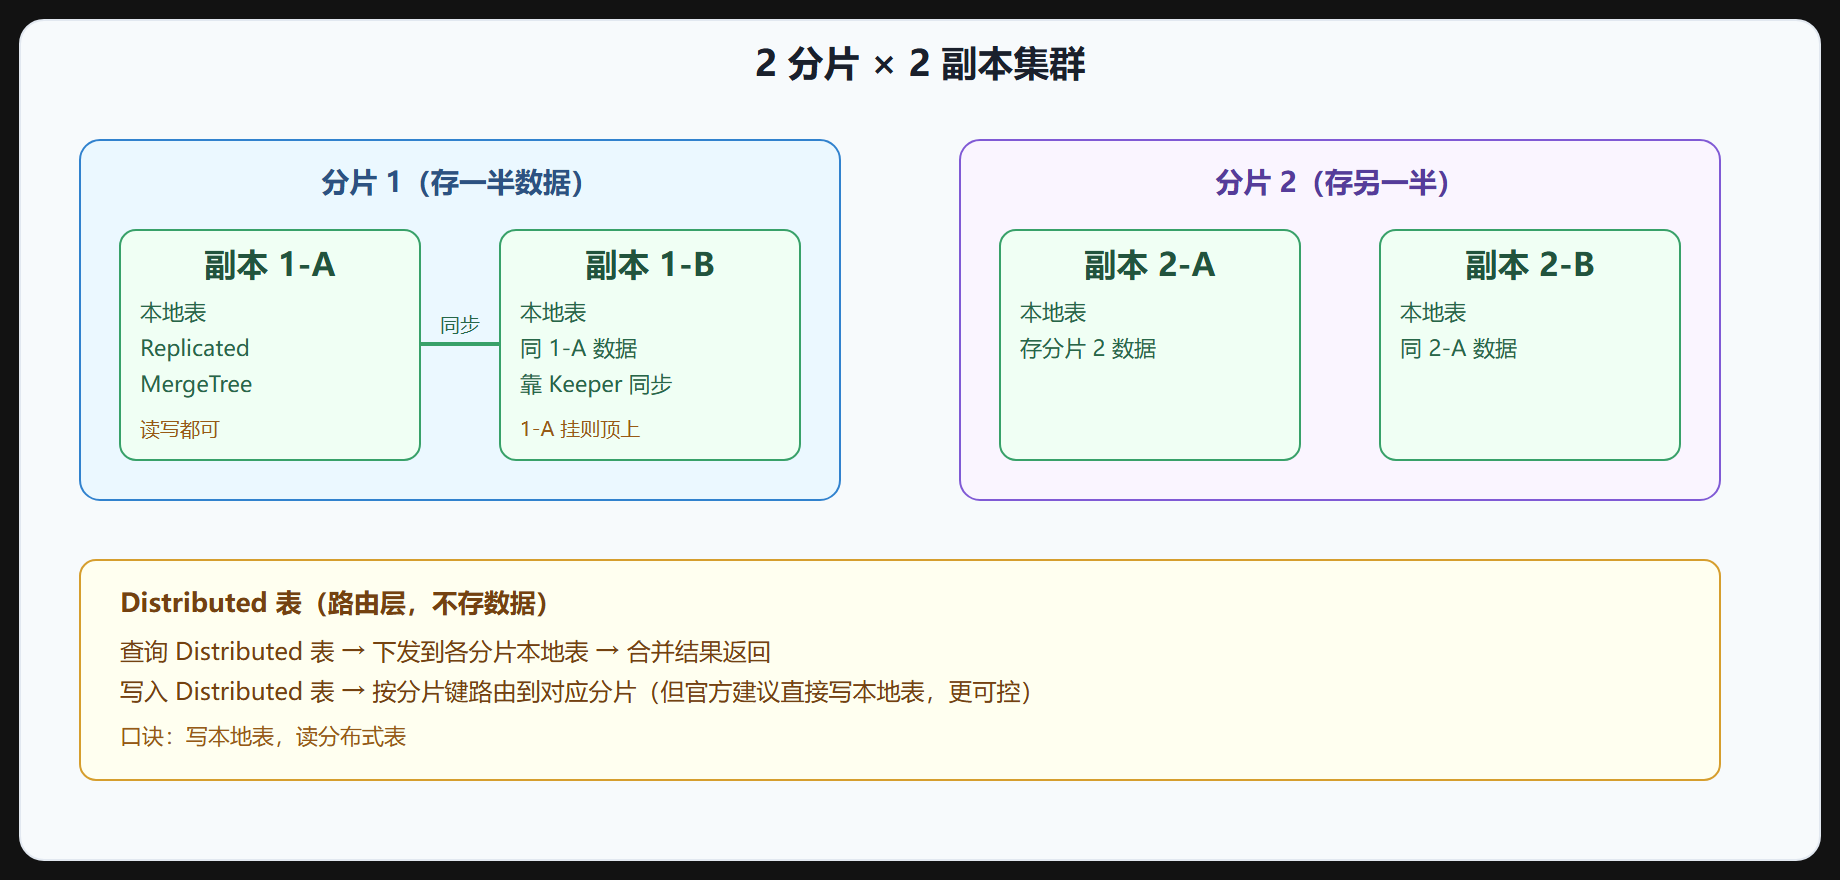
二、本地表与 Distributed 表
ClickHouse 的分布式查询靠两种表配合:
- 本地表:每个节点上真实存数据的表,用
ReplicatedMergeTree引擎。写入直接写本地表。 - Distributed 表:不存数据,是个路由层。查询它会把请求下发到各分片的本地表,合并结果返回。
-- 各节点上的本地表 CREATE TABLE events_local ON CLUSTER my_cluster ( event_time DateTime, user_id UInt64, city LowCardinality(String) ) ENGINE = ReplicatedMergeTree PARTITION BY toYYYYMMDD(event_time) ORDER BY (event_time, user_id); -- Distributed 表(建在任一节点,路由用) CREATE TABLE events AS events_local ENGINE = Distributed(my_cluster, default, events_local, rand());
Distributed 引擎的参数:集群名、库名、本地表名、分片键(决定写到哪个分片,rand() 随机分,也可按某列哈希)。
三、写本地表,读分布式表
这是 ClickHouse 分布式使用的口诀:
- 写本地表:直接写到对应分片的本地表,可控、不经过 Distributed 层的开销。要按分片键决定写哪个分片(应用层路由,或用 Distributed 表写但接受其额外开销)。
- 读 Distributed 表:查询时用 Distributed 表,它自动下发到各分片合并结果,对应用透明。
为什么不直接写 Distributed 表?因为 Distributed 表写入要把数据按分片键路由、缓冲、转发,有额外开销和出错面。生产里通常应用层直接按分片键算出写哪个本地表,读时走 Distributed 表。
四、松散耦合的特性
ClickHouse 的分布式是"松散耦合":每个分片是自治的高性能本地引擎,Distributed 表只是薄路由层。它不追求跨节点强事务,各分片独立服务。这种设计的好处是简单和性能——没有分布式事务的开销;代价是一致性偏最终,跨分片查询看到的是各分片各自的状态。
⚠️ 常见坑:有人期待 ClickHouse 像 Spanner 那样提供跨分片强一致事务,结果失望。它的分布式是为 OLAP 扫描聚合设计的,不是为 OLTP 事务。需要强一致的场景别用它做主存。
💡 关键直觉:分片解决容量/写吞吐,副本解决可用性/读吞吐,两个正交维度。Distributed 表是路由层不存数据,写本地表读分布式表是口诀。
本节速览
- 分片 vs 副本:分片切数据扩容(容量/写吞吐),副本做冗余(可用性/读吞吐),正交维度。
- 本地表:各节点真实存数据,用 ReplicatedMergeTree,写入直接写它。
- Distributed 表:路由层不存数据,查询它自动下发各分片合并结果。
- 口诀:写本地表,读分布式表。
- 松散耦合:各分片自治,无跨分片强事务,一致性偏最终。
下一节讲副本之间靠什么对齐——协调服务 ZooKeeper/Keeper。
集群的配置与验证命令
集群拓扑写在配置里,但验证它是否生效要用 SQL。先说配置侧,remote_servers 定义了分片和副本的映射,典型的 2 分片 2 副本拓扑:
<remote_servers> <my_cluster> <shard> <replica><host>ch1</host><port>9000</port></replica> <replica><host>ch2</host><port>9000</port></replica> </shard> <shard> <replica><host>ch3</host><port>9000</port></replica> <replica><host>ch4</host><port>9000</port></replica> </shard> </my_cluster> </remote_servers>
配置加载后,用 system.clusters 验证拓扑是否被正确识别:
-- 查看集群拓扑 SELECT cluster, shard_num, replica_num, host_name, port FROM system.clusters WHERE cluster = 'my_cluster' ORDER BY shard_num, replica_num; -- 一键在所有节点创建本地表 CREATE TABLE events_local ON CLUSTER my_cluster ( event_time DateTime, user_id UInt64 ) ENGINE = ReplicatedMergeTree PARTITION BY toYYYYMMDD(event_time) ORDER BY (event_time, user_id);
ON CLUSTER my_cluster 是分布式 DDL:一条语句在所有节点上执行。这比逐节点登录建表高效得多,生产里建表、改表基本都走它。注意本地表引擎必须是 ReplicatedMergeTree,否则副本之间没有同步机制。
分片键的选择也很关键。rand() 随机分片适合均匀写入,但查询要扫描全部分片;按业务键哈希(如 city)分片能让"按城市查询"只落到部分分片,配合分布式查询的 WHERE 下推减少扫描量。分片键选错,分布式表的性能可能比单机还差。