7.1 数据集成生态
7.1 数据集成生态
本节摘要:本节讲 ClickHouse 怎么和外部数据源打交道:Kafka 引擎消费消息流、S3 引擎读冷数据、MySQL/PostgreSQL 表函数做联邦查询、物化视图构建预聚合链路。
核心问题
阅读完本节,你应当能够:
- 用 Kafka 引擎把消息流接入 ClickHouse
- 用 S3 引擎读冷数据或做冷热分层
- 用 MySQL 表函数做联邦查询
- 设计物化视图链路做预聚合
一、Kafka 引擎:消费消息流
Kafka 是 ClickHouse 最常见的实时数据源。Kafka 引擎表消费 Kafka topic 的消息,配合物化视图把消息落到 MergeTree 表持久化。典型链路:
-- Kafka 引擎表(不存数据,只消费) CREATE TABLE kafka_events ( event_time DateTime, user_id UInt64, city LowCardinality(String) ) ENGINE = Kafka SETTINGS kafka_broker_list = 'broker1:9092,broker2:9092', kafka_topic_list = 'events', kafka_group_name = 'ch_consumer', kafka_format = 'JSONEachRow'; -- 持久化表 CREATE TABLE events (...) ENGINE = MergeTree ORDER BY ...; -- 物化视图:从 Kafka 表灌入持久化表 CREATE MATERIALIZED VIEW events_mv TO events AS SELECT * FROM kafka_events;
数据流:Kafka topic → kafka_events 引擎表(消费)→ 物化视图 → events 持久化表。物化视图在这里起"管道"作用,把消费的消息转写到 MergeTree 表。
⚠️ 常见坑:有人把 Kafka 引擎表当主存查,结果消息消费完就查不到了。Kafka 引擎表是消费管道,不是存储。要持久化必须配物化视图灌到 MergeTree 表。
二、S3 引擎:冷数据与分层
S3 引擎让 ClickHouse 直接读写 S3 上的数据。两种用法:
- S3 表函数:临时查 S3 上的文件,不建表。
- S3 引擎表:建表指向 S3 路径,像查本地表一样查 S3。
-- 临时查 S3 文件 SELECT count() FROM s3('https://s3.../bucket/data.parquet', 'Parquet'); -- S3 引擎表 CREATE TABLE s3_logs (...) ENGINE = S3('https://s3.../bucket/', 'Parquet');
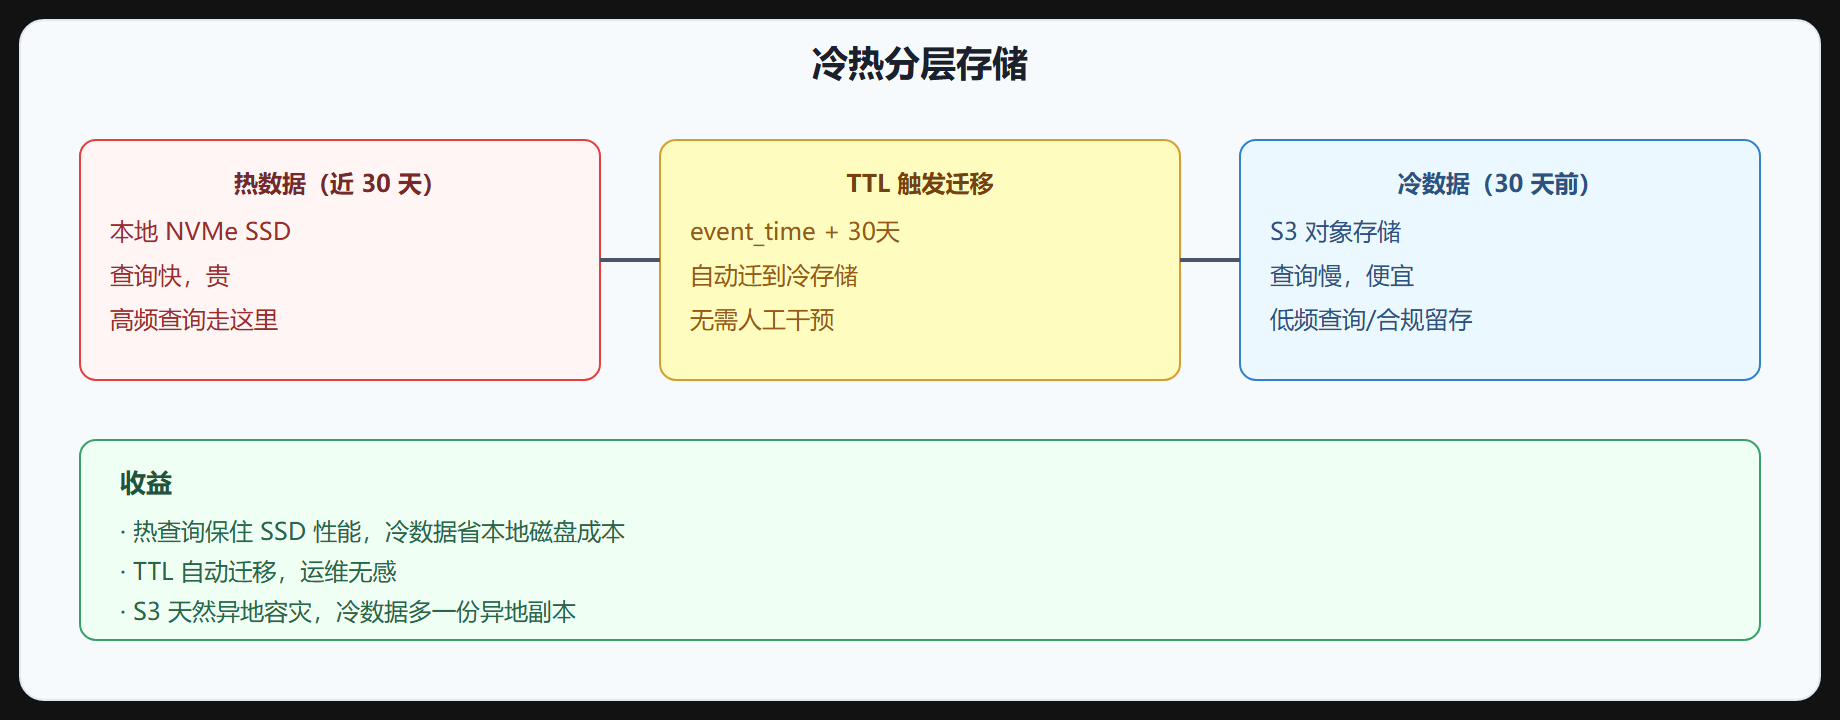
更实用的是 Tiered Storage——把热数据放本地 SSD、冷数据自动迁到 S3,用 TTL 触发迁移。既保住热查询性能,又省本地磁盘。
CREATE TABLE events (...) ENGINE = MergeTree ORDER BY ... TTL event_time + INTERVAL 30 DAY TO DISK 's3_cold'; SETTINGS storage_policy = 'hot_cold';
图 7-1 冷热分层存储
三、MySQL/PostgreSQL 联邦查询
mysql/postgresql 表函数让你在 ClickHouse 里查远端关系库的表,做联邦查询。适合"用 ClickHouse 算大聚合,关联一点 MySQL 维度数据"的场景。
-- 联邦查 MySQL 维度表 SELECT c.city_name, count() FROM events e JOIN mysql('mysql_host:3306', 'db', 'cities', 'user', 'pass') c ON e.city_id = c.city_id GROUP BY c.city_name;
注意联邦查询会把远端表拉到 ClickHouse 侧做 JOIN,远端表大就很慢。适合小维度表关联,大表关联先把维度表同步进来或宽表化。
四、物化视图链路:预聚合
第 4 章提过物化视图做预聚合。这里讲链路设计——多级物化视图,从明细逐级聚合:
-- 明细表 CREATE TABLE events_raw (...) ENGINE = MergeTree ORDER BY event_time; -- 一级聚合:按分钟 CREATE MATERIALIZED VIEW events_min ENGINE = AggregatingMergeTree ORDER BY (minute, city) AS SELECT toStartMinute(event_time) AS minute, city, sumState(amount) AS amt, countState() AS cnt FROM events_raw GROUP BY minute, city; -- 二级聚合:按天(从一级聚合来) CREATE MATERIALIZED VIEW events_day ENGINE = AggregatingMergeTree ORDER BY (day, city) AS SELECT toDate(minute) AS day, city, sumMergeState(amt) AS amt, countMergeState(cnt) AS cnt FROM events_min GROUP BY day, city;
这样查询按粒度选表——查分钟级查 events_min,查天级查 events_day,各级都快。这是 ClickHouse 处理"多粒度分析"的标准招数。
五、集成生态速查
| 需求 | 用什么 |
|---|---|
| 消费 Kafka 实时流 | Kafka 引擎 + 物化视图 → MergeTree |
| 查 S3 冷文件 | S3 表函数/引擎 |
| 冷热分层省磁盘 | Tiered Storage + TTL |
| 关联 MySQL 维度 | mysql 表函数(小表) |
| 多粒度预聚合 | 多级物化视图 |
💡 关键直觉:集成的核心是"管道 + 存储"分工——Kafka/S3/MySQL 引擎是管道(读外部数据),MergeTree 是存储(持久化)。别把管道当存储用,也别在存储里硬塞外部数据。
重点提炼
- Kafka 引擎:消费消息流的管道,配物化视图灌到 MergeTree 持久化,别当主存。
- S3 引擎:读冷数据;Tiered Storage + TTL 做冷热分层,省磁盘保性能。
- MySQL/PostgreSQL 表函数:联邦查询,适合小维度表关联,大表先同步或宽表化。
- 物化视图链路:多级物化视图做逐级预聚合,多粒度分析各级都快。
- 集成分工:管道(Kafka/S3/MySQL 引擎)负责读,存储(MergeTree)负责存,别混用。
下一节讲客户端与驱动,应用怎么连 ClickHouse。
一个完整的实时链路示例
把 Kafka 消费、落库、预聚合三段拼起来,就是一条完整的实时分析链路。下面这个例子带格式处理,比前面单独的片段更接近生产形态:
-- 1. Kafka 引擎表:消费事件流 CREATE TABLE kafka_events ( event_time DateTime, user_id UInt64, city LowCardinality(String), amount Float64, app_version String ) ENGINE = Kafka SETTINGS kafka_broker_list = 'broker1:9092', kafka_topic_list = 'user_events', kafka_group_name = 'ch_analytics', kafka_format = 'JSONEachRow', kafka_num_consumers = 4; -- 增加消费并发 -- 2. 持久化明细表 CREATE TABLE events ( event_time DateTime, user_id UInt64, city LowCardinality(String), amount Float64, app_version String ) ENGINE = MergeTree PARTITION BY toYYYYMMDD(event_time) ORDER BY (event_time, user_id); -- 3. 物化视图:消费 Kafka 并落明细 CREATE MATERIALIZED VIEW events_mv TO events AS SELECT * FROM kafka_events;
kafka_num_consumers 控制消费线程数,写入量大时调高。物化视图在 Kafka 消费链路里既是管道又是门卫——它可以在落库前做过滤、类型转换,比如只保留金额大于零的支付事件:
-- 带过滤的消费:只落有效事件 CREATE MATERIALIZED VIEW events_mv TO events AS SELECT event_time, user_id, city, amount FROM kafka_events WHERE amount > 0;
链路搭好后,验证消费是否在推进:对比 system.kafka(Kafka 表消费偏移)和 events 表的最新事件时间。如果偏移在涨而 events 表不涨,说明物化视图或落库环节有问题,按"Kafka 表 → 物化视图 → 目标表"三段定位,很快能找到断点。