7.3 架构设计最佳实践
7.3 架构设计最佳实践
本节摘要:本节把前六章串成一个端到端的 ClickHouse 架构参考,讲分层设计、典型架构、常见陷阱,给你一个能落地的整体方案。
上手前先明确
阅读完本节,你应当能够:
- 画出一个生产级 ClickHouse 数据架构
- 理解各层职责和数据流向
- 避开常见架构陷阱
- 根据业务规模做架构取舍
一、端到端架构参考
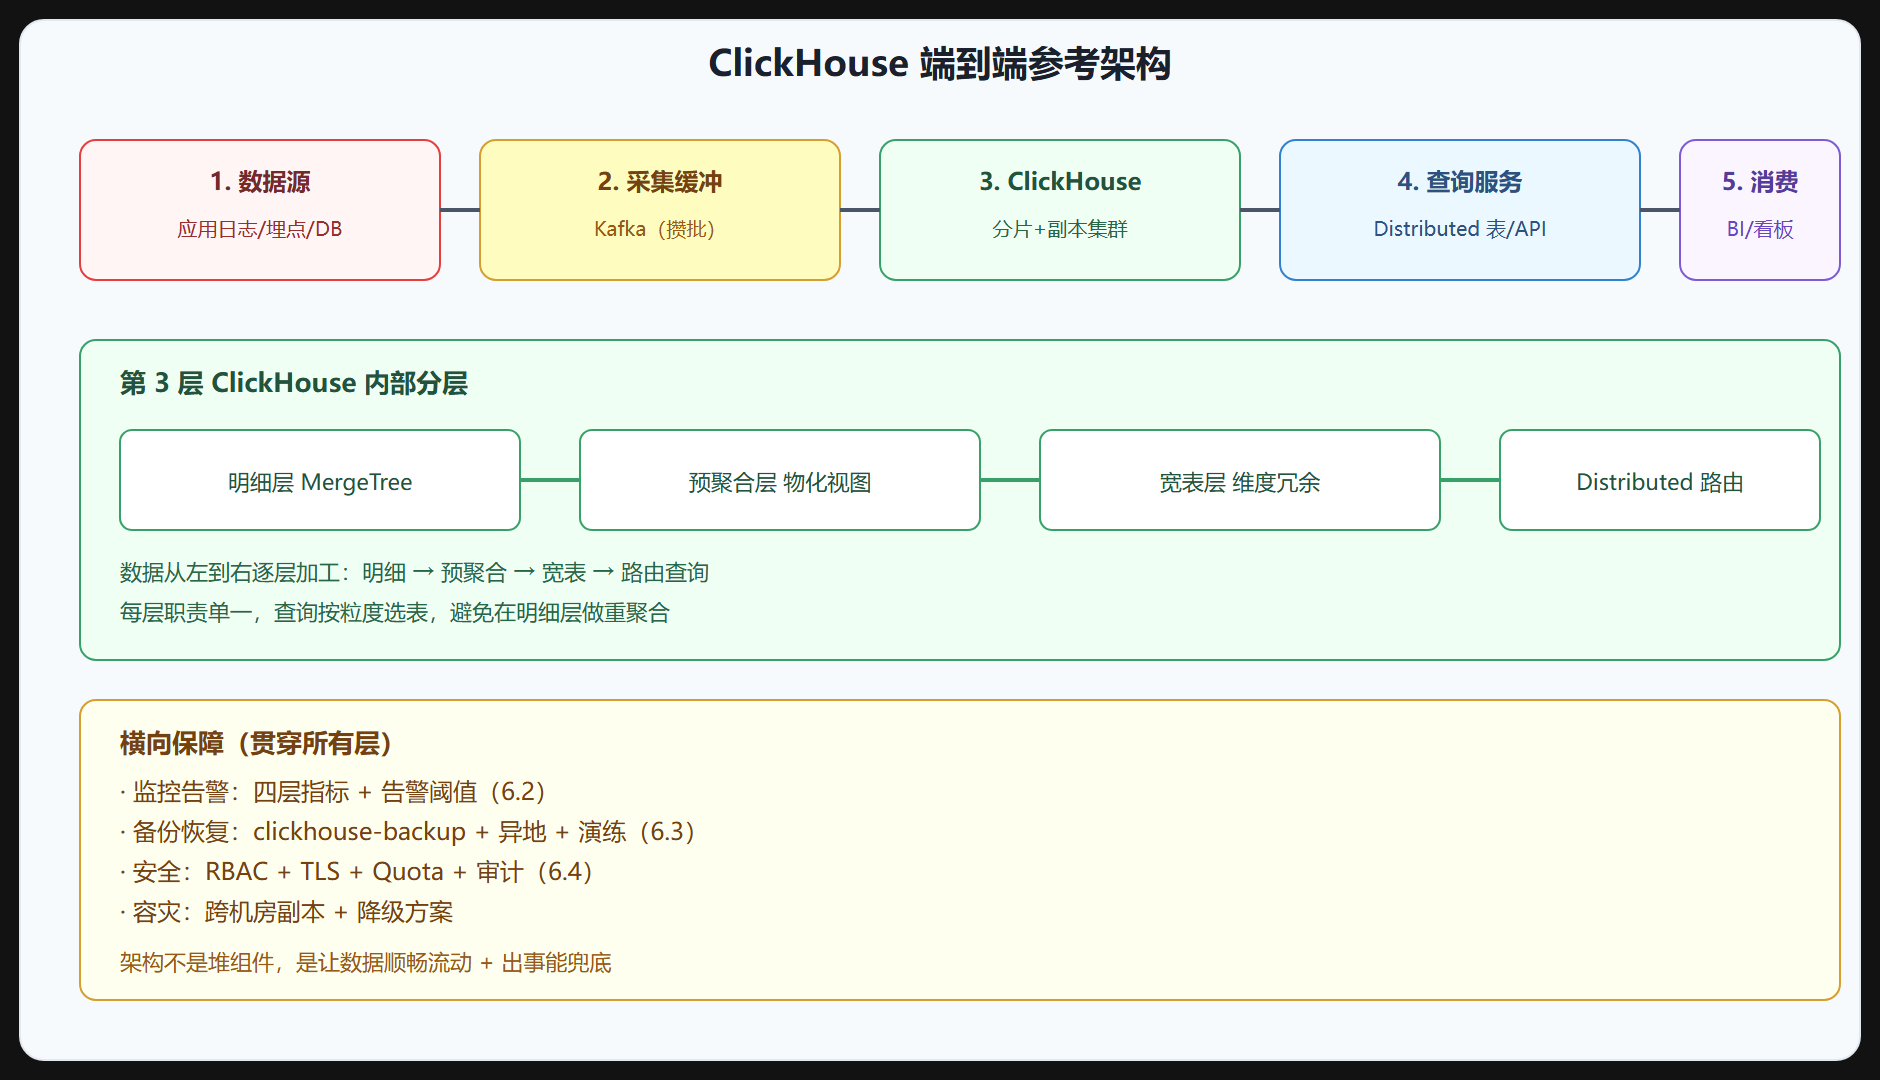
一个典型的 ClickHouse 实时分析架构,从数据产生到消费,分五层:
图 7-3 ClickHouse 参考架构总览
二、各层职责
第一层:数据源
业务应用产生日志、埋点、变更流。这层不归 ClickHouse 管,但要注意数据格式——统一成 JSON/Parquet,字段稳定,方便下游消费。
第二层:采集缓冲
Kafka 做缓冲层。它的作用是攒批——业务高频产生的数据先进 Kafka,ClickHouse 消费时批量拉,避免高频小批量写入 ClickHouse。这是"用 Kafka 缓解 ClickHouse 不擅长高频写"的标准解法。
第三层:ClickHouse 内部分层
- 明细层:MergeTree 存原始明细,按时间分区。
- 预聚合层:物化视图从明细逐级聚合,多粒度查询各级都快。
- 宽表层:把维度冗余进事实表,避免 JOIN。
- Distributed 路由:对外暴露 Distributed 表,查询透明下发。
第四层:查询服务
应用通过 Distributed 表或 API 网关查 ClickHouse。这层可加缓存(Redis)兜底高频点查,加查询排队控制并发。
第五层:消费
BI 工具(Grafana/Superset)做可视化,业务系统消费分析结果。
三、几个关键取舍
取舍一:宽表 vs 星型模型
ClickHouse 偏爱宽表——把维度冗余进事实表,查询不用 JOIN。代价是维度变更要重灌数据。星型模型(事实表 JOIN 维度表)灵活但 JOIN 慢。
| 方案 | 优点 | 缺点 | 适用 |
|---|---|---|---|
| 宽表 | 查询快、无 JOIN | 维度变更要重灌 | 维度稳定 |
| 星型 | 维度灵活 | JOIN 慢 | 维度常变 |
大多数 ClickHouse 场景选宽表,维度变更靠"重灌分区"或"维度表小可联邦查"。
取舍二:分片粒度
分片多扩容好但合并协调开销大、查询合并慢。分片少扩容受限但简单。建议按未来 1-2 年数据量规划,别过度分片。一般单分片能扛 TB 级,PB 级才考虑多分片。
取舍三:实时 vs 批量
实时(Kafka 流式灌入)延迟低但写入频繁;批量(攒批定时灌)写入少但延迟高。按业务对延迟的容忍度选。报表场景批量够,实时看板要流式。
四、常见架构陷阱
- 跳过 Kafka 直接高频写:业务直连 ClickHouse 高频小批量写,part 爆炸。必须加 Kafka 缓冲。
- 在明细层做重聚合:所有查询都打明细表做聚合,没建物化视图,慢。要分层,重聚合放预聚合层。
- 过度分片:数据量不大就分很多片,协调开销大。按需分片。
- 没有降级方案:ClickHouse 挂了业务全瘫。要有缓存兜底或只读降级。
- 备份不演练:以为备份了就安全,出事发现恢复不了。定期演练。
五、按规模选架构
| 规模 | 架构建议 |
|---|---|
| 小(GB-TB) | 单机 MergeTree,够用别上集群 |
| 中(TB 级) | 单分片 2 副本,或 2 分片 2 副本 |
| 大(PB 级) | 多分片多副本 + Kafka + 冷热分层 |
| 超大 | 多集群按业务拆分,避免单集群过大难运维 |
⚠️ 常见坑:小数据量就上分布式集群,结果协调服务、副本同步的运维成本远大于收益。集群是为规模服务的,规模不到别上集群,单机 MergeTree 性能已经很强。
💡 关键直觉:架构的本质是"让数据顺畅流动 + 出事能兜底"。数据流要分层(采集缓冲→明细→预聚合→路由→消费),保障要贯穿(监控/备份/安全/容灾)。别只盯着 ClickHouse 本身,上下游和保障同样重要。
要点串联
- 五层架构:数据源 → 采集缓冲(Kafka) → ClickHouse(明细/预聚合/宽表/路由) → 查询服务 → 消费。
- 内部分层:明细 MergeTree → 物化视图预聚合 → 宽表 → Distributed 路由,按粒度选表。
- 取舍:宽表 vs 星型(选宽表)、分片粒度(按需不过度)、实时 vs 批量(按延迟容忍)。
- 陷阱:跳过 Kafka、明细层重聚合、过度分片、无降级、备份不演练。
- 按规模选:小单机、中单分片副本、大多分片、超大拆集群,别小数据上集群。
- 架构本质:数据顺畅流动 + 出事能兜底。
全书到这里结束。从一条建表语句跑通,到内部原理、表引擎、查询优化、分布式集群、运维安全、生态架构,你已经具备用 ClickHouse 解决"海量数据 + 实时分析"问题的完整能力。剩下的就是在实战中打磨。
从一张表出发的设计清单
架构落地最终要落到具体的表设计。下面这份清单可以当"建表前的自检表",每建一张核心表都过一遍:
CREATE TABLE user_event_facts ( event_time DateTime, -- 事件时间,分区与查询主维度 event_date Date MATERIALIZED toDate(event_time), -- 物化列,避免查询时函数包裹 user_id UInt64, city LowCardinality(String), -- 低基数字典编码 channel LowCardinality(String), amount Decimal(18, 2), -- 金额用定点数 INDEX idx_channel channel TYPE set(100) GRANULARITY 4 -- 非主键高频过滤 ) ENGINE = MergeTree PARTITION BY toYYYYMMDD(event_time) ORDER BY (event_time, user_id) -- 排序键:查询最常过滤的列在前 TTL event_time + INTERVAL 365 DAY; -- 数据保留策略
自检的维度包括:分区键是否匹配最常查询的时间粒度;ORDER BY 首列是否是查询过滤的第一条件;枚举字符串是否用了 LowCardinality;金额是否用了 Decimal;高频非主键过滤有没有跳数索引;有没有 TTL 数据保留策略。六项全过,这张表的设计就比较扎实。
架构层面,前面讲了五层。这里补一个演进顺序的建议:先单机跑通 → 数据增长到单机瓶颈再上副本(解决可用性)→ 再上分片(解决容量)→ 最后才考虑多集群拆分。每一步都要有明确的触发指标,而不是一次性上全。集群规模上去了,监控、备份、安全这些保障措施的投入也要同步跟上。
EXPLAIN 是架构设计者的好朋友——上线前把核心查询的 EXPLAIN 结果截下来,上线后对比实际执行,可以及时发现数据量变化导致的计划退化。架构不是设计完就固定,它是持续演进的过程,前面六章的能力在这里合成最终答案。