2.1 通用语言是怎么失守的:一次排错实录
2.1 通用语言是怎么失守的:一次排错实录
本节摘要:通用语言(Ubiquitous Language)指业务专家与开发团队共用的同一套词汇——会上的词、文档里的词、代码里的名字必须指同一个东西。本节不先给定义,而是完整还原青柚商城一次客服口径事故的排错过程:一笔已发货的订单在客服系统里显示"未发货",追根到底,"已发货"三个字在三个系统里有三个判定时点。看完这轮排查,你会明白语言失守不是沟通不努力的锅,而是缺乏边界治理的必然结果,以及词汇表该怎么建、谁来仲裁。
先看一次真实的排错
战略设计的第一站不讲概念,先取证——上一章复盘会留下的悬案"规则理解不一致",需要一个具体切片。下面这起事故发生在青柚商城复盘会后的第十天,当时新流程还没上线,它恰好是"语言分岔"最干净的标本。
背景。用户在 App 上发起了一笔退款,理由栏写的是"明明显示未发货,其实货早就到了,我不想要了"。客服按"未发货订单"走拦截流程,结果拦截失败,货照常送达。用户二次投诉,工单升级到运营主管那里。
现象。客服系统里这张订单的状态字段赫然写着"待发货";物流系统里同一笔单号的状态是"已签收"。两个系统都没有说谎——说谎的是"发货"这个词。
排查。工程师先查交易库,下单接口写库时状态是 WAIT_DELIVERY;再查仓储系统的出库记录,出库时间比用户发起退款早两个小时。也就是说,仓储视角下货早就发出去了,交易视角下订单还没发货。问题变成:交易系统的"已发货"状态是什么时候置位的?
// 交易系统:状态置位逻辑 public class OrderStatusService { // 交易系统认为的"已发货":收到仓储回传的出库确认报文 public void onWarehouseConfirmed(String orderNo) { Order order = orderDao.load(orderNo); if (order.getStatus() == OrderStatus.WAIT_DELIVERY) { order.setStatus(OrderStatus.DELIVERED); // 交易语境的 DELIVERED orderDao.update(order); } } }
这段代码看着没毛病。继续追仓储回传报文,发现出库确认报文分两种:PICKED(拣货完成)和 SHIPPED(交接承运方完成)。交易系统订阅的回调只处理了 SHIPPED,而当晚仓库高峰期积压,SHIPPED 报文延迟了四十分钟才发出来。可物流系统的"已发货"判定完全不同:
-- 物流系统:运输单状态推进 -- 物流语境的"已发货" = 承运方揽收扫描完成 UPDATE transport_order SET status = 'IN_TRANSIT' WHERE waybill_no = ? AND scan_type = 'PICKUP_SCAN';
而客服系统是从工单模板的角度理解这个词的:
// 客服系统:拦截流程的前置判断 // 客服语境的"未发货" = 用户可以看到的商品尚未出库展示态 export function canIntercept(order: TicketOrder): boolean { // 客服系统本地缓存了交易侧状态快照,5 分钟刷新一次 return order.statusSnapshot === "WAIT_DELIVERY"; }
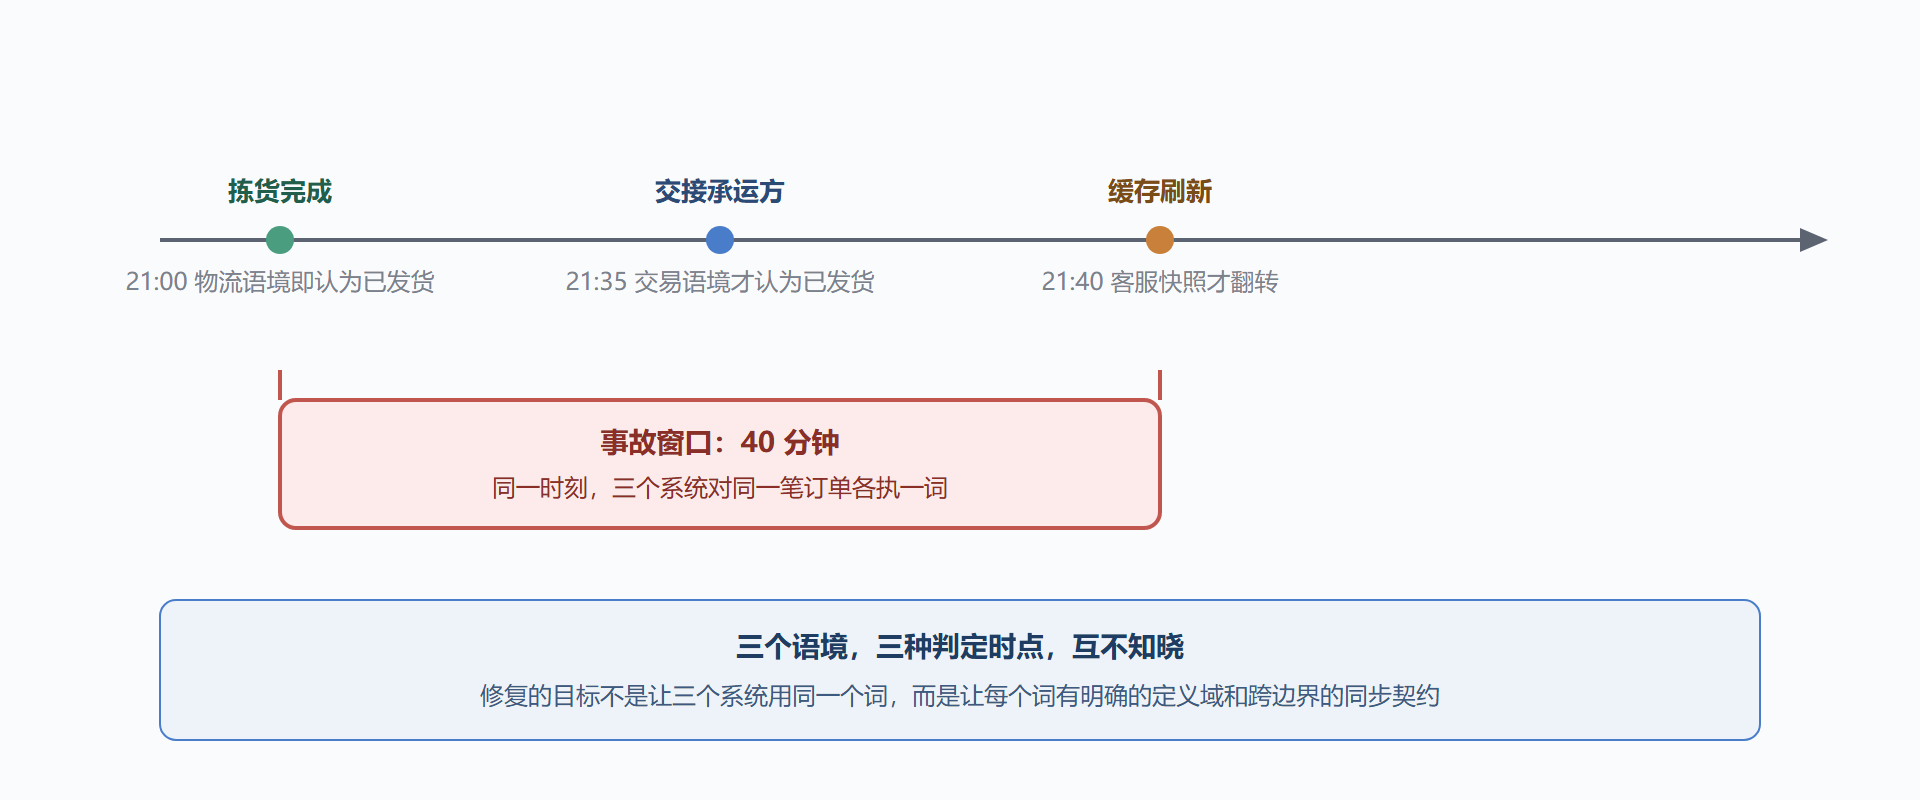
三段代码,三个"发货"。交易系统以"收到仓储确认报文"为准,物流系统以"承运方揽收扫描"为准,客服系统以"五分钟前的状态快照"为准。三个判定时点横跨四十分钟外加一次缓存刷新——在这四十分钟里,"已发货"与"未发货"同时为真。
根因。排错会开到这一步,没有人再讨论"哪个系统写错了"——三段代码各自忠于各自语境里的词。真正的根因写进事故报告只有一行:"发货"没有定义域。三个系统从未坐下来确认过这个词在各自边界的判定时点,也没有约定边界之间用什么报文、什么时效同步。 语言失守的方式从来不是一次争吵,而是四个团队各自沉默地做了"合理"的假设。
语义是怎么一步步分岔的
事故之后,团队做了一件比写修复代码更有价值的事:倒查这个词四年来的分岔史。这张表后来成了第 2 章谈判桌上的第一份物证:
| 系统 | 词形 | 判定时点 | 数据源 | 首次分岔 |
|---|---|---|---|---|
| 交易系统 | 已发货 DELIVERED | 收到仓储出库确认报文 | 交易库订单表 | v2.3 新增回调 |
| 物流系统 | 已发货 IN_TRANSIT | 承运方揽收扫描 | 运输单扫描记录 | 初版就有 |
| 客服系统 | 未发货 WAIT_DELIVERY | 交易状态快照(5 分钟延迟) | 本地缓存表 | v1.7 为性能加缓存 |
分岔史揭示了两个规律。其一,分岔几乎总是"当时合理"的局部决策:客服加缓存是为了工单列表不被慢查询拖垮,交易选报文时点是因为当时仓储只有一个确认信号。没有哪个决策在它自己的场景里是错的,错的只是这些决策从没被放到同一张桌子上对照过。其二,分岔点之后,每个系统都围绕自己的词形长出了新的依赖——客服的 SLA 统计按快照口径出数,财务的时效考核按揽收口径出数。词越用越深,回头成本越来越高。
语义分岔与事故窗口
重建语言:词汇表怎么落地
修复事故本身只花了一下午——客服拦截判断改订阅交易侧的领域事件而不是查快照。真正花时间的是随后建立的三条机制,它们让"通用语言"从口号变成可维护的资产。
第一条:词汇表带定义域建档。 团队建了一份两列词汇表:一列写词,一列写"在哪个上下文、判定时点是什么、数据源是什么"。"发货"这个词条现在长这样:交易上下文叫 DELIVERED,判定时点是收到仓储出库确认事件;物流上下文叫揽收完成,判定时点是承运方扫描。词汇表的关键设计是允许同名异义、禁止同域异义——跨上下文的重名不是问题,问题是一个上下文内部一个词两个意思。
第二条:代码里的名字忠于词汇表。 词汇表里的词必须能在代码里被找到:要么是类名、方法名,要么是枚举值。评审时的一个固定动作是问"这个词在词汇表第几条"——答不上来的词,要么补录,要么改名。反过来,词汇表里半年没被任何代码引用的词条要清理。语言是活的,账本对不上就该修账本。
第三条:改词要走仲裁。 词汇表设一名仲裁人(青柚商城是运营主管兼),任何词条变更要记录三样东西:谁提的、影响哪些上下文、迁移期限。没有仲裁人的词汇表撑不过半年——词语冲突最终会退回到嗓门大的赢。
💡 这套机制的妙处在于它把"对齐口径"从人际关系问题变成了工程问题。争执"已发货到底啥意思"永远吵不完,问"这个词在你的上下文里判定时点是什么、事件什么时候发"却有唯一答案。
带走的判断
- 通用语言的失败形态不是"没有词汇表",而是词没有定义域:每个系统都在自己的语境里正确,合在一起互相说谎。
- 分岔源于无数"局部合理"的决策,倒查分岔史比争论谁对谁错更能定位问题。
- 词汇表必须带定义域、与代码互相锚定、有仲裁与变更记录——三样缺一,语言就会重新熵增。
- 事故窗口的本质是跨边界的语义时差:边界可以各有各的词,但边界之间的同步契约必须显式设计。
下一节顺着"定义域"这个词往下走:既然语义只能在一定范围内守住,这个范围就叫限界上下文——它是语言的主权边界,也是整个战略设计的地基。