2.2 设备、上下文与交换链——运行时组件全景
2.2 设备、上下文与交换链——运行时组件全景
本节摘要:把 DirectX 运行时的核心组件摆上工作台:设备是资源出生地,上下文(11)或命令列表(12)是指令的发生方式,交换链是帧的闭环出口,DXGI 是它们与系统之间的中间层。本节逐一讲清职责边界与协作关系。
从一个画面停滞的现场说起
调试会话里画面不动了:交换链里明明有画好的帧,屏幕却纹丝不动。排查半天才定位到——Present 调用挂在了垂直同步上,而交换链建成了翻转模型却配错了缓冲计数。这个现场说明运行时组件间职责边界的价值:谁管资源、谁管提交、谁管上屏,边界清楚,故障才可能被隔离定位。本节就沿这条边界线,把核心组件一个个交代清楚。
设备:一切资源的出生地
设备对象(ID3D11Device / ID3D12Device)是 GPU 的程序化身:所有后续资源——缓冲、纹理、管线状态、描述符堆——都由它创建,可以把它理解为"资源工厂 + 能力档案"的合体。它在初始化时与具体适配器绑定,此后你创建的每一份资源都归属这个设备,也只在设备兼容的硬件上有效。
设备还有个容易被忽略的职责:错误的历史记录。D3D 11 的设备提供 GetDeviceRemovedReason,D3D 12 同样可以在设备被移除后查询原因码——第五章排错实录里,它是定位设备丢失的第一现场证人。记住:设备不只是创建器,还是状态机与故障日志的持有者。
指令的发生方式:11 的上下文与 12 的命令列表
两代 API 最大的分野在"指令如何发生"。
D3D 11 用上下文(Context):立即模式下,每次 Draw、每次状态设置都直接记录进驱动管理的命令流,驱动作弊般地替你调度——简单,但提交开销藏在黑箱里。延迟上下文提供多线程录制的口子,但录制结果仍交回立即上下文执行,自由有限。
D3D 12 把上下文拆开:命令列表(Command List/Allocator)负责录制——分配器管理底层内存,列表负责收集指令;命令队列(上节已创建)负责提交——把录制好的列表排进硬件管线。这个拆分就是第一章说的"松手":录制与执行解耦后,多个线程可以各自持有分配器并行录制,最后一次性提交,CPU 开销大幅摊薄。两代对照:
D3D 11 立即上下文 ──────────→ 驱动内部队列(黑箱) 延迟上下文(可多线程录制)─┘ 收回后由立即上下文执行 D3D 12 命令分配器 + 命令列表(自由并行录制)→ 命令队列(显式提交)→ GPU
初学者常问:那 D3D 11 的上下文在 12 里去哪了?答案:被拆成了列表与队列两半,一半管"说",一半管"送"。理解这个拆分,第六章的多线程优化才谈得上入门。
交换链:帧的闭环出口
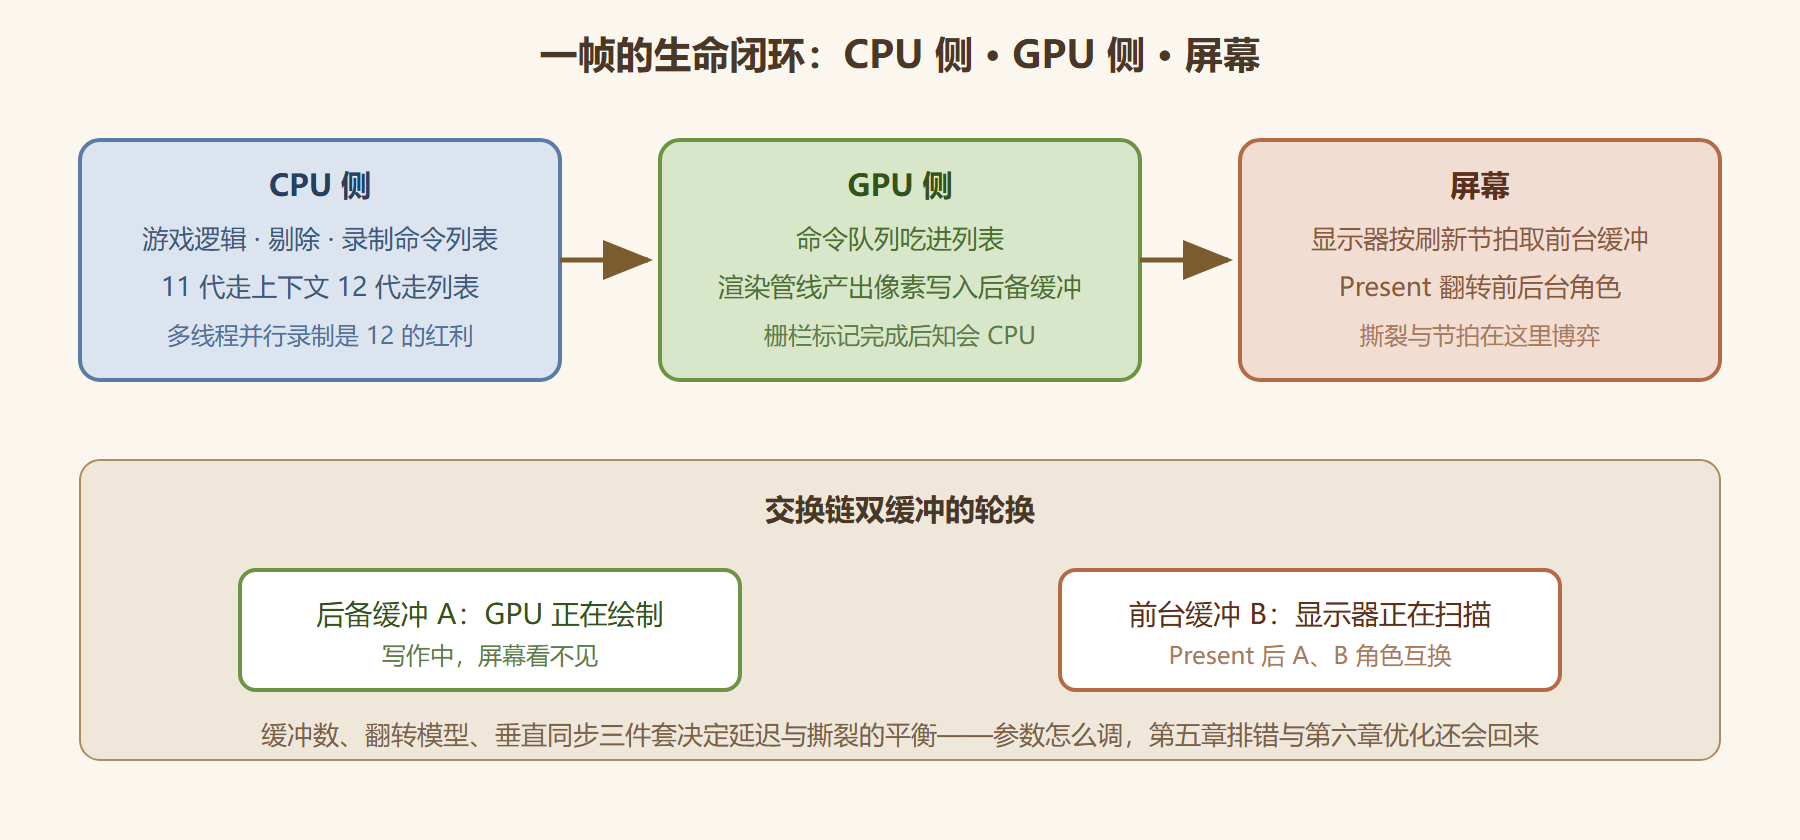
GPU 画完的帧去哪?答案是交换链(Swap Chain):一块由若干后备缓冲组成的环形队列,程序画帧写后备,显示器刷新读前台,角色轮换靠Present 翻转。为什么需要至少两块缓冲?因为显示与绘制必须并行——只有一块的话,显示器读到一半你把它改了,画面上下两半错位(撕裂)。
交换链的翻转模型值得单独强调。老式位块传输(Blt)模型会把后备缓冲拷贝到前台,多一次搬运、可能触发额外的合成步骤;现代翻转模型(Flip Presentation)让"前台/后备"只是指针角色的互换,零拷贝。新项目一律应使用翻转模型—— DXGI_SWAP_EFFECT_FLIP_DISCARD 或 FLIP_SEQUENTIAL,这是第一章提到的"DirectDraw 翻页"在当代的直系继承。
交换链的常用参数浓缩在创建描述里:
DXGI_SWAP_CHAIN_DESC1 scdesc{}; scdesc.Width = 0; scdesc.Height = 0; // 0 表示跟随窗口客户区 scdesc.Format = DXGI_FORMAT_B8G8R8A8_UNORM; // 与屏幕兼容的常用格式 scdesc.BufferCount = 2; // 双缓冲;高帧率项目常配 3 scdesc.SwapEffect = DXGI_SWAP_EFFECT_FLIP_DISCARD; // 翻转模型,新项目标配 scdesc.BufferUsage = DXGI_USAGE_RENDER_TARGET_OUTPUT; scdesc.SampleDesc.Count = 1; // 翻转模型下多重采样须走后处理 factory->CreateSwapChainForHwnd(queue.Get(), hwnd, &scdesc, nullptr, nullptr, &swapchain);
注意最后一行:交换链由 DXGI 工厂创建而不是设备——它把命令队列与窗口绑在一起,这正是 DXGI 中间层身份的体现。
图1 帧的闭环:从命令到屏幕
DXGI:被名字耽误的中间层
DXGI(DirectX Graphics Infrastructure)常被新手当成杂项,实则是图形与操作系统的边界层:适配器枚举、显示模式、全屏切换、交换链、 Gamma 校正,全归它管。它存在的理由是把"与显示硬件、窗口系统打交道的杂务"从渲染 API 里剥离——Direct3D 专注画图,DXGI 专注搬运与呈现。实际开发里你会频繁在两个命名空间之间跳:创建资源找 D3D,管窗口呈现找 DXGI。第三章画第一个三角形时,交换链的后备缓冲会被包装成渲染目标——那次"跨界联姻"正是 DXGI 与 D3D 协作的缩影。另有一条一线经验:DXGI 对象的创建常带工厂标志(是否允许遥测回调、是否限制到单线程使用等),排查呈现类悬案时先核对工厂的创建参数——"交换链行为诡异"的案例里,有一类根源正是工厂标志与后续用法的前后矛盾。
常见疑问:为什么开了垂直同步,帧率恰好锁在 60
把交换链的节拍问题讲透。显示器按固定刷新率扫描(常见 60Hz),Present 在垂直同步开启时会等扫描间隙才交换前后台,于是一帧的呈现节奏被显示器带跑:60Hz 的屏最多每秒呈现 60 帧。更微妙的是节拍不匹配的惩罚是跳跃式的——渲染一帧要 18 毫秒(不到一帧的预算),开启同步后实际帧率不是 55,而是直接掉到 30:因为错过了本次扫描间隙,就得再等整个一帧的周期。这就是"丢一档就腰斩"的经典现象,也是为什么性能优化讲究把帧时间压进预算线的"下一档"(60 帧档、120 帧档),而不是差一点也无所谓。
三重缓冲是对这道台阶的修补:前台、后台再加一块在途缓冲,GPU 错过一次间隙不用干等整帧,可以继续画下一块。代价是多一块缓冲的显存与约一帧的输入延迟。理解了这层博弈,你就明白交换链参数(缓冲数、同步间隔、翻转模型)为什么值得在第五章花整节排错篇幅——它们直接写在玩家体验上。
本节要点回顾
- 设备是资源出生地与故障档案库:所有资源由它创建,设备移除原因也在它身上查。
- 指令发生方式的两代分野:11 的上下文(立即/延迟)在 12 被拆为命令列表(说)与命令队列(送),录制与执行解耦是手动挡化的核心。
- 交换链是帧的闭环:双缓冲轮换避免撕裂,翻转模型是当代标配,Present 是每帧的终点发令枪。
- DXGI 是边界层:适配器、显示模式、交换链归它,渲染 API 与窗口系统靠它握手。
组件全景已铺开,但机器上的显卡千差万别——功能级别这层"能力契约的版本号"如何让一份代码跑遍高中低端?下一节揭晓。