3.1 管线逐站讲解——顶点如何变成像素
3.1 管线逐站讲解——顶点如何变成像素
本节摘要:渲染管线是一组以数据驱动的阶段串联:顶点进来时只是坐标,光栅化后变成带插值的片元,输出合并后成为后备缓冲里的像素。本节逐站讲解每阶段的输入输出与存在理由,为全章的动手旅程铺路。
想象一份没有管线的工作
假设没有管线,让你用 CPU 画一个旋转的三维模型:遍历每个顶点做矩阵乘法,判断每个三角形朝向屏幕还是背面,把三角形投影到平面,再逐像素判断"这个点在三角形内吗",算了颜色还要跟背景混合——每个模型、每帧重复。CPU 写这种代码不是不能活,而是吞吐量撑不起实时:它的循环是串行的。GPU 管线的答案是把每一步做成硬件化的并行车间,数据像流水一样穿过车间群。理解管线的正确姿势不是背阶段名,而是盯住一个问题:数据在每站被加工成了什么形态?
全景图与七站巡礼
图1 渲染管线全景与数据形态变迁
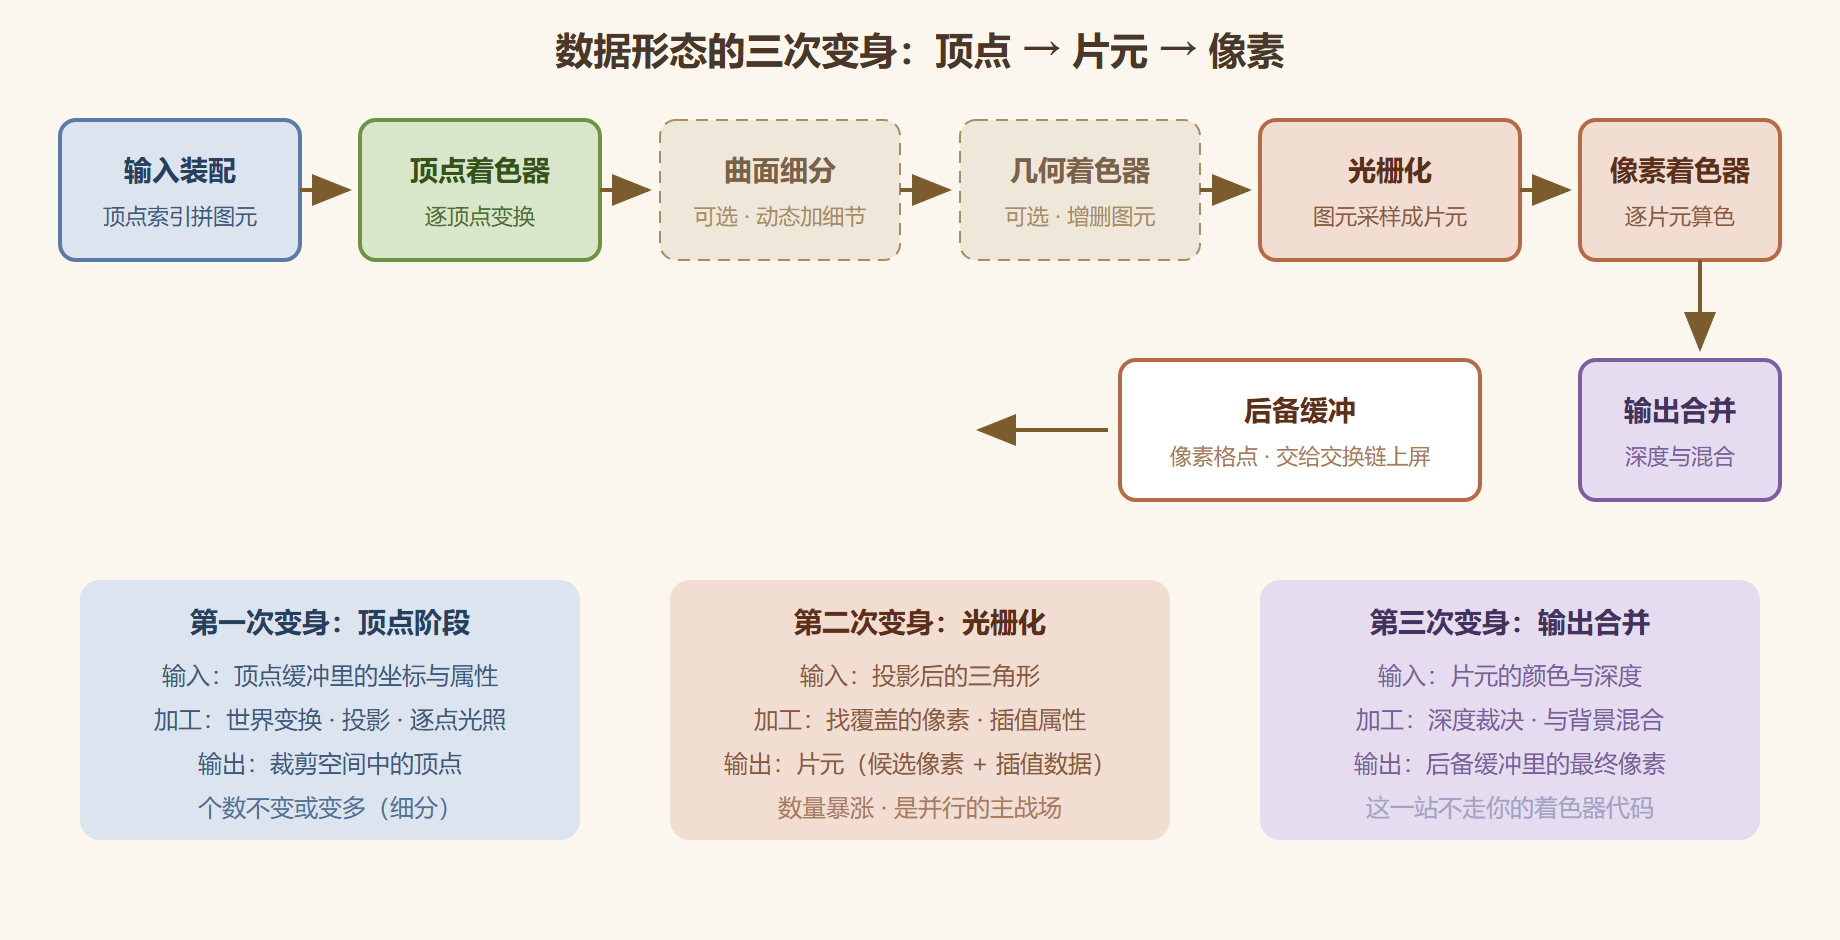
**输入装配(IA)**是质检入库:顶点缓冲与索引缓冲在此被解读成图元(三角形列表、条带等拓扑)。这站不碰数据内容,只管"按什么规则分组"。用索引缓冲可以让多个三角形共享顶点——一个立方体八个顶点就能描述,而不是逐三角形重复十二次。索引还能改善顶点缓存命中:按优化后的顺序排列索引,让刚用过的顶点尽量被复用,这是离线网格处理的标准步骤之一。
**顶点着色器(VS)**是第一次变身,可编程。每个顶点独立进入,矩阵乘法把它从模型空间搬到裁剪空间——这一步的数学在 3.2 节复盘三角形时展开。它也是逐顶点属性计算(法线变换、传给像素阶段的插值参数)的场所。
**曲面细分(HS/Tessellator/DS)与几何着色器(GS)**是两站可编程的"增料车间",虚线画出以示可选:前者按需把低模拆细(LOD 的硬件化方案),后者能以图元为单位生成或丢弃数据。实战里这两站是性能敏感区,先知道存在,用到再深究。
光栅化(RS)是第二次变身,固定功能。它把裁剪空间投影后的三角形落到像素网格上:找出被覆盖的像素,按重心坐标插值顶点属性,产出片元(fragment,候选像素 + 插值后的数据)。注意术语的分界:光栅化之前谈顶点,之后谈片元。透视正确的纹理映射、屏幕空间导数这些硬件魔法也在此发生。
**像素着色器(PS)**是第二次可编程变身:每个片元独立进入,读纹理、算光照,输出颜色。它运行次数与屏幕覆盖率成正比,常是全管线的性能大头——第六章的优化从"少跑像素着色器"与"让它跑得简单"两端下手。
**输出合并(OM)**是固定功能的终审法庭:片元的深度与深度缓冲比对,被遮挡者出局;幸存者按混合状态与已有像素合成。透明物体的次序问题、Z-fighting 闪烁,病根都在这一站,3.5 节的状态对象会给出对应的旋钮。
固定功能的旋钮:别把"不可编程"听成"不可配置"
七站里有四站不跑你的代码,但它们绝非铁板一块——每一站都留着一排配置旋钮,渲染状态的大学问就藏在这里。光栅化站可配:填充模式(实心、线框——调试线框图就是它)、面剔除方向(背面剔除省一半片元)、多重采样抗锯齿的倍率;输出合并站可配:深度测试的比较规则、是否写入深度、混合的算式(透明渲染的半成品公式全在这站);输入装配站可配:图元拓扑(三角形列表还是条带);光栅化前还有视口与裁剪矩形两把剪刀决定画到屏幕哪一块。这些旋钮在 D3D 12 里被打包进管线状态对象(PSO),3.5 节会专门讲它——此处先校准一个观念:"固定功能"固定的只是算法本身,参数仍归你定,渲染效果的一半控制力其实握在这些不可编程站的旋钮上。
深入一站:光栅化车间内部
七站巡礼里光栅化被一句话带过,但它内部值得多站一会儿,因为太多渲染现象的病根在这里。它的工作分四步:第一步视口变换,把裁剪空间的标准化坐标映射到实际像素网格;第二步三角形设置,根据三个顶点的屏幕位置算出边的方程,确定覆盖了哪些像素中心;第三步插值,按重心坐标把顶点属性(颜色、法线、纹理坐标)分摊到每个覆盖点,且做透视校正——屏幕上的线性插值不等于三维空间的线性插值,不校正的话纹理在斜面上会扭;第四步逐像素唤起像素着色器,再把结果连同深度送进输出合并。
另一个藏在光栅化阶段的机制是提前深度测试(early-Z):像素着色器跑之前,硬件可以先拿片元深度跟深度缓冲比一遍,注定被遮挡的片元直接出局,省下整套着色计算。这是"先画近、后画远"比"先画远、后画近"更快的原因——前者靠 early-Z 淘汰了大量被遮挡的片元,后者要等输出合并才发现白算了。 第六章优化策略里的"由近到远排序不透明物体",依据全在这。反过来说,画家算法时代"先画远、后画近"的次序习惯,在硬件管线里恰恰是反面模式。
跟一帧数据走完全程
用具体数字把七站串一遍。场景里一个三角形,顶点缓冲里躺着三个顶点,各带位置与纹理坐标:
输入装配 : 读 3 个顶点 + 0 个索引 → 组出 1 个三角形(拓扑:三角形列表) 顶点着色器 : 跑 3 次,每次吃 1 个顶点 → 输出裁剪空间坐标(GPU 上 3 个线程并行) 光栅化 : 1 个三角形覆盖屏幕上约 8000 个像素 → 产出约 8000 个片元(数量放大逾千倍) 像素着色器 : 跑约 8000 次,每次读纹理、算光照 → 输出 1 个颜色(GPU 数千线程并行) 输出合并 : 每个片元的深度对深度缓冲裁决 → 幸存者混入后备缓冲 交换链 : Present 把后备缓冲翻转给显示器 → 你看见这个三角形
这张流水账解释了图形优化的第一直觉从哪来:顶点阶段的开销与几何量成正比,片元阶段的开销与屏幕覆盖率成正比。同样的场景,拉远相机缩小物体,顶点数没变,片元数锐减;把低模推远再高模拉近(LOD),则是反过来在顶点侧省账。第六章的每一个优化招式,都能在这条流水账里找到它的记账位置。
并发视角:流水线不是接力赛
初学者最容易缺失的视角是并发。管线的"流水"二字是工业流水线意义上的:顶点着色器车间在处理这一帧的模型时,像素着色器车间还在消化上一批图元。GPU 的上千执行单元被按阶段切分复用,哪个阶段积压就把资源调给哪个阶段——硬件调度器在管线下方做实时平衡。这个视角解释了三个日常现象:为什么 GPU 利用率高不代表每阶段都忙;为什么管线里"倒流"的数据访问(像素着色器读回顶点阶段的结果)会造成等待;为什么第六章讲帧率稳定时强调"喂饱流水线而不是某一站"。还有一个常见误判同样源于并发视角的缺失:CPU 直觉里"这段着色器代码很贵"的推断,在 GPU 上未必成立——一段着色器的实际成本取决于数据依赖与占用率,而非指令本身的算术复杂度;判断贵不贵,终究要靠第五章的时序工具实测,纸面推算只是起点。
本节要点回顾
- 盯数据形态:顶点(裁剪空间坐标)→ 片元(候选像素 + 插值属性)→ 像素(后备缓冲格点),三次变身串起全管线。
- 可编程与固定功能的分界:VS/PS(及可选的细分、GS)归你写,光栅化与输出合并是硬件固化行为。
- 光栅化是数量爆炸点:三角形数与像素数之间隔着覆盖率与插值,像素着色器因此常是性能大头。
- 管线是并发流水线:阶段间并行、批次重叠,这是吞吐的来源,也是同步话题的伏笔。
站点认识完了,下一节发车:亲手把一个三角形从代码送进这条流水线,看它第一次出现在屏幕上。