1.1 传统观测为何总是迟到
1.1 传统观测为何总是迟到
本节摘要:传统观测把探针放在用户态或协议栈末端,看到的是已经发生完的结果。抓包丢进程语义,系统调用追踪拖垮热点路径,采样剖析错过短命尖峰。eBPF 要解决的第一件事,是把观测点从“门口的监控录像”挪到“病房里的心电监护”。
本节目标
阅读完本节,你应当能够:
- 说出抓包、系统调用追踪、采样剖析三种手段各自丢掉的证据
- 解释“工具都正常、业务仍超时”为什么经常发生
- 把一次延迟故障拆成内核路径上的若干瞬间
- 判断一个观测需求是否已经超出用户态工具的能力边界
凌晨两点,告警说 P99 从 8 毫秒跳到 120 毫秒。仪表盘上的 CPU、内存、磁盘都很平静。你打开抓包,三次握手干净,窗口也没缩小。你再上系统调用追踪,延迟数字几乎不变,整机 QPS 却掉了一截——你用来找病的药,自己先把病人放倒了。
这不是运气差。这是观测点放错了楼层。
一、你看见的是成品,不是事故现场
把 Linux 网络路径想成一条流水线:网卡 DMA 把帧送进驱动,驱动可能立刻决定丢弃或转发;过了这一关,才构造套接字缓冲区,再走协议栈、netfilter、套接字队列,最后 copy 到用户态。传统抓包多半挂在协议栈已经处理完、即将交给用户态或即将出门的位置。你拿到的是成品包裹,不是分拣车间里掉下去的那一箱。
进程语义在更早的地方就丢了。一个包属于哪个容器、由哪次 connect 发起、当时 cgroup 的 CPU 限额是多少——抓包文件里通常没有。你只能靠端口号去猜,而端口在连接池和短连接场景里会骗你。
系统调用追踪换了一个门口:它站在用户态和内核的交界处。你能看见“进门”和“出门”的时间差,却看不见内核在门后排队、锁竞争、软中断抢占。更麻烦的是,它往往用 ptrace 一类机制把目标进程按住,让每次系统调用都多一次上下文切换。热点服务上,观测本身变成最大的延迟来源。
采样剖析又换了一种迟到方式。它按固定节拍问 CPU:“你现在在哪”。节拍之间的短命尖峰——比如 200 微秒的一次锁等待——经常被跳过。你得到一张“平均很健康”的火焰图,用户感受到的却是偶发卡顿。
| 手段 | 站位 | 擅长 | 系统性缺陷 |
|---|---|---|---|
| 抓包 | 协议栈中后段 | 看包头、重传、窗口 | 丢进程/cgroup 语义;看不见 XDP 已丢的包 |
| 系统调用追踪 | 用户态与内核边界 | 看调用次数与总耗时 | 门后排队不可见;自身开销污染热点 |
| 采样剖析 | 定时打断 CPU | 找热函数 | 错过短于采样周期的尖峰 |
| 应用日志 | 业务代码里 | 看业务对错 | 内核路径完全失明 |
| Sidecar 指标 | 代理进程 | 看网格内 HTTP | 本机系统调用与内核网络仍盲 |
医院里有两种监护。一种是门口的摄像头:人倒了你才看见。一种是床旁心电:R 波变形的那一拍就已经响。传统观测更像前者。eBPF 想做的是后者——电极贴在内核路径上,而且可以只在“心率异常”时才把波形送出来。
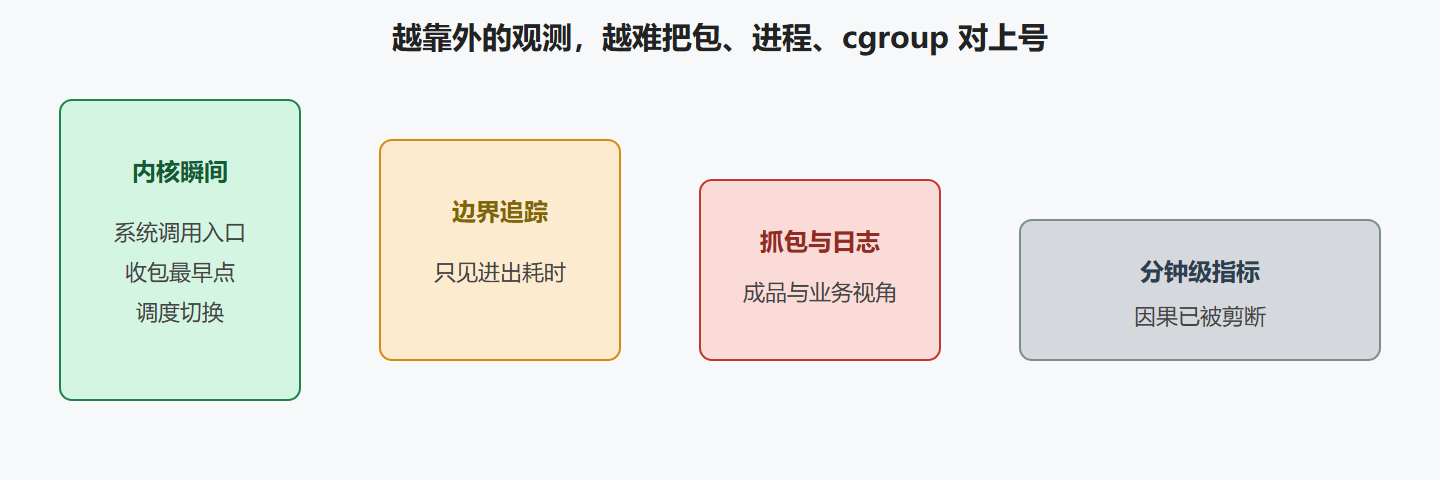
上图里虚线才是关键:事故可以发生在 B,而你的工具还在 F 等成品。
二、开销如何把证据弄脏
迟到还只是第一层。第二层是观测改变了被观测对象。
系统调用追踪若按“每次调用都记录完整参数”,等于在热路径上再跑一遍序列化和拷贝。磁盘写审计日志时,IO 队列被观测自己塞满。有人用“先全量抓、再离线筛”的办法对付偶发故障,结果高峰期网卡把镜像流量打满,故障被放大成事故。
采样剖析看起来轻,但采样频率一高,时钟中断和栈回溯会在多核上打架。你调高频率想抓住尖峰,尖峰却被你自己的采样制造出来。这不是理论:我见过把剖析器开到过密之后,P99 自己恶化,关掉剖析器故障“自动痊愈”,团队争论了半天是不是代码问题。
还有一类更隐蔽的迟到:聚合把因果剪断。Prometheus 式指标每 15 秒一个点。内核里一次 30 毫秒的软中断风暴,在点上可能只变成 CPU 多了 2%。你看到的是平滑曲线,用户看到的是超时。没有“那 30 毫秒里谁持有了哪把锁”的关联,曲线不能当证据。
概念上,一次“有用的内核观测”至少要同时满足三件事:
时机:发生的那一拍,而不是聚合后的那一分钟 关联:进程、cgroup、套接字、包,能对上号 克制:默认不拷贝全量,只在条件命中时出数据
传统工具往往只能三选二。抓包有时机(相对靠后)但关联弱、克制差;指标有克制但时机和关联都差;系统调用追踪有关联,但时机停在门口、克制很差。
⚠️ 常见坑:故障一出现就上全量抓包。全量抓包会改变缓存与中断分布,你事后看到的延迟构成,可能已经不是故障当时的构成。
💡 关键直觉:先问“我要的证据存在于哪个内核瞬间”,再选工具。瞬间不在用户态,用户态工具再熟也是在猜。
三、工程上如何判断“已经该下沉”
不是所有问题都需要内核级观测。应用把 SQL 写崩了,去看数据库慢查询即可。下面几条同时出现时,我才考虑下沉:
第一,用户态日志和指标对不上体感。P99 恶化,但应用代码路径没有变,GC、锁、线程池也看不出异常。
第二,问题与内核对象绑定:连接、文件描述符、页面回收、cgroup 限流、网卡队列。这些对象的生命周期主要在内核。
第三,你需要条件触发而不是全量。例如“只在 TCP 重传且当前进程属于某工作负载时记录一次调用栈”。用户态工具很难在不付全量代价的前提下做这种过滤。
第四,观测窗口很短。滚动升级的 90 秒里出现的抖动,容不得你先部署一个重量级代理再等它预热。
这时 eBPF 的卖点才成立:程序进内核之前被验证;挂上之后可以按 map 里的开关采样;卸掉不留模块。它并没有取消开销——kprobe 仍可能拖慢热路径——但它把开销从“全有或全无”变成“可证明、可调节”。具体架构见第 2 章,挂载点选择见第 4 章。
图:观测点越靠外,因果越难接上
问题:为什么仪表盘全绿,用户仍超时?
因为仪表盘多半是聚合后的均值或分位,采样周期远大于内核事件的寿命。超时往往是几十毫秒的排队或锁,被平均进十几秒的点里就看不见了。
问题:先上 Sidecar 是不是就能替代内核观测?
不能。Sidecar 看见的是经过代理的应用协议。本机短连接、DNS、节点上的系统调用、cgroup 限流,代理都可能看不到。网格解决服务间策略,不解决内核盲区。
四、把一次超时拆成时间轴
假设一次 RPC 超时预算是 50 毫秒。用户态日志只告诉你“这次调用失败了”。真正有用的拆法是把 50 毫秒切成内核能对上号的片段:系统调用进入到三次握手发出去花了多久,包在网卡队列里等了多久,对端应答回来之后在套接字队列里又躺了多久,copy 到用户态又花了多久。每一段对应不同的瞬间,也对应不同的工具。
如果你发现 40 毫秒耗在“connect 已进入内核、SYN 还没出门”,抓包会看起来很干净——因为包还没形成你熟悉的那条流。这时系统调用跟踪点加 TCP 状态读取才对得上。如果 40 毫秒耗在“包已经在对端,本端在 recv 上睡”,你需要的是套接字队列深度和唤醒延迟,而不是再抓一份 HTTP。如果 40 毫秒其实在用户态线程池排队,eBPF 只会证明内核很快,你该回头看应用。
把拆分写成一张会前检查单,能避免一上来就全量抓包。先用 10 秒的无条件计数看系统调用频率是否异常,再用 30 秒的阈值出栈看超预算的调用栈长什么样。两步都失败,才考虑短窗口 kprobe。这个顺序本身就是在保护现场:你没有先用最重的工具把队列形状改掉。
数字上要有心理尺度。单次 kprobe 在冷路径上可能只有几百纳秒,但每秒五十万次 read 乘上去就是可观的核。采样剖析的 99 赫兹对 2 毫秒的尖峰几乎看不见。抓包镜像若把万兆网卡的流量再复制一份,镜像口先成为瓶颈。这些数量级不需要背公式,但要在开口要工具之前问一句:我要的片段大概多长、发生有多频繁。
和业务同事对齐语言也很重要。他们说“接口慢了”,你要翻译成“哪一段内核对象的等待”。翻译失败时,两边会对着同一张全绿仪表盘吵架。把时间轴画在复盘文档里,比再上一个平台更便宜。
问题:时间轴必须用 eBPF 才能画吗?
不一定。应用已有的分段计时如果覆盖了用户态队列,先用它。eBPF 出场的条件是分段计时在进入内核之后就断了。断点明确,才值得下沉。
现场笔记:镜像口先成为瓶颈的那一次
有一次故障被判断成偶发重传。团队打开全量镜像,把万兆流量再送一份到分析机。分析机自己先丢包,结论变成网络在丢。关掉镜像后,业务重传下降。真正原因是应用线程在锁上排队,内核重传只是结果。全量镜像把结果放大,把原因盖住。
若当时先画时间轴:应用日志里排队已经到了 80 毫秒,内核侧只需用系统调用出口抽样确认拷贝很快,根本不必镜像。工具的重量必须小于问题的寿命。问题只存在 10 分钟,你却用 20 分钟铺镜像,窗口已经关上,留下的只是被改变过的现场。
把这条写成纪律:先轻后重,先短后长,先抽样后全量。任何全量动作都要有自动超时卸载。超时仍在,按事故处理,而不是按还在看。看本身可以成为事故。这和禁止无指征的有创检查是同一类克制。值班经理有权叫停镜像,不必等专家到场。叫停比多一张图更值钱。
核心回顾
- 迟到的本质:工具停在协议栈末端或用户态,事故却发生在驱动、调度和系统调用入口。
- 三种经典手段:抓包丢语义,系统调用追踪污染热点,采样剖析错过短峰。
- 开销会伪造现场:全量抓包和过密剖析会改变你正在测量的延迟。
- 有用观测的三条件:时机、关联、克制;传统工具很难同时满足。
- 下沉的判断:用户态对不上体感、问题绑着内核对象、需要条件触发、窗口很短。
- eBPF 的位置:不是零开销神话,而是把观测点推进内核并加上可验证、可卸载的开关。
下一节看另一条看起来更“彻底”的路:直接加载内核模块。它能看见现场,却把整台机器当成抵押品。