3.1 Map是内核里唯一允许的状态
3.1 Map 是内核里唯一允许的状态
本节摘要:eBPF 栈小且每次钩子触发都是一次新调用,跨事件状态不能指望局部变量。Map 是内核允许的共享内存:给计数、连接跟踪、策略下发、事件外送。类型选错会表现为锁竞争、驱逐误杀、或者验证器因无界遍历直接拒绝。
本节导读
阅读完本节,你应当能够:
- 说明为什么“用全局变量记连接”在 eBPF 里不成立
- 对比 ARRAY、HASH、LRU_HASH、PERCPU、RINGBUF 的适用场景
- 根据并发与容量预估选择 Map,而不是默认哈希表
- 设计用户态更新策略、内核只读执行的数据流
第 1.3 节连接泄漏那道题,本质是状态机:看见 close,还要等内核真正释放。用户态程序会用一块堆内存扛着。eBPF 程序没有这种堆。栈只有有限字节,下一次 kprobe 进来,上次的局部变量已经没了。你要记忆,就只剩 Map。
一、火花与仓库
每次钩子触发,程序像电火花:亮一下,必须结束。验证器要求可终止,也要求你别把未证明的缓冲区当长期存储。Map 是预先声明容量和键值形状的仓库,验证器因此知道一次查找返回的指针能走多远。
这很像变电站里的调度台账。调度员不能在操作台上堆私人文档,只能在固定格子里填数。格子满了要有淘汰规则,格子按 CPU 分开放能减少抢笔。你讨厌这种死板,它却让“不会写到格子外面”可以被证明。
用户态与内核通过同一张表对话。常见分工:
- 内核:热路径上 lookup / increment / 提交事件
- 用户态:定时全表扫描做指标、下发白名单、处理环形缓冲区
不要把复杂决策塞进火花里。火花里做 O(1) 查找和整数加减;把“这个 Pod 该不该限流”的策略计算放用户态,结果写成 Map 项。
/* 概念性:内核只做查找与计数,策略项由用户态写入 */ SEC("tracepoint/syscalls/sys_enter_connect") int on_connect(void *ctx) { u32 key = current_cgroup_id_truncated(); u64 *cfg = bpf_map_lookup_elem(&policy, &key); if (!cfg) return 0; if (*cfg & FLAG_COUNT) increment_percpu_counter(key); return 0; }
二、类型不是口味,是并发与寿命
ARRAY 用整数下标,查找最快,容量固定。适合 CPU 号、系统调用号、小规模桶。不能当连接表:连接 ID 不是密集整数。
HASH 用任意键。适合 sock cookie、PID、cgroup id。并发下要付哈希与可能的锁/原子开销。键设计很关键:用 PID 当长期键会在 PID 复用后串台。
LRU_HASH 在满员时淘汰。适合“只关心最近活跃连接”。代价是你以为还在的项可能被挤掉,状态机会断。泄漏追踪若依赖“项还在表示未释放”,LRU 会制造假释放。
PERCPU 变体把值按 CPU 拆开,避免多核抢同一计数器。读的时候用户态要汇总。适合纯计数,不适合必须全局一致的状态机——各 CPU 上的副本对不齐。
RINGBUF / PERF EVENT 不是查询表,是单向管道。适合出事件。满了就丢,所以要有丢失计数。不要用哈希表当日志库往里塞字符串。
| 类型 | 查找 | 并发 | 淘汰 | 典型用途 | 选错时的症状 |
|---|---|---|---|---|---|
| ARRAY | 下标 O(1) | 好 | 无 | 桶计数、CPU 维指标 | 键不是整数时硬塞,浪费或冲突 |
| HASH | 键查找 | 中 | 无,满则插入失败 | 连接跟踪、策略 | 高基数打满;PID 复用串台 |
| LRU_HASH | 键查找 | 中 | 有 | 热点缓存、近期事件 | 状态机丢项,误判已结束 |
| PERCPU_ARRAY | 下标 | 很好 | 无 | 热路径计数 | 用户态忘了跨 CPU 求和 |
| RINGBUF | 追加 | 好 | 满则丢 | 事件外送 | 静默丢事件,故障像没发生 |
⚠️ 常见坑:默认开一张巨大 HASH “先用着”。验证器、内存记账、TLB 都会疼;更糟的是满员后插入失败,热路径上的错误处理你往往没写。
💡 关键直觉:先决定“满了怎么办”。不能丢,就要限基数并告警;能丢,才配 LRU 或环形缓冲区。
三、工程要点:基数、键、所有权
基数要有预算。 每连接一项乘以节点连接上限,再乘副本数,很快超过你在变更单里写的“几兆内存”。eBPF 内存受 memlock 与 cgroup 记账约束,详见第 5 章。超了不是变慢,是加载失败或运行中插入失败。
键要选不会复用或能容忍复用的。 PID 会复用。sock cookie、inode、生成号更稳。必须用 PID 时,配上启动时间戳。
更新方向要单向清晰。 策略表用户态写、内核读。计数表内核写、用户态读。双向随意写,会出现你刚清零、内核又加回的抖动,排障像闹鬼。
不要在 eBPF 里遍历整张哈希表做业务。 迭代器存在,但是给排障和导出用的。热路径遍历会让验证器与延迟一起爆炸。需要聚合,就在写入时增量聚合。
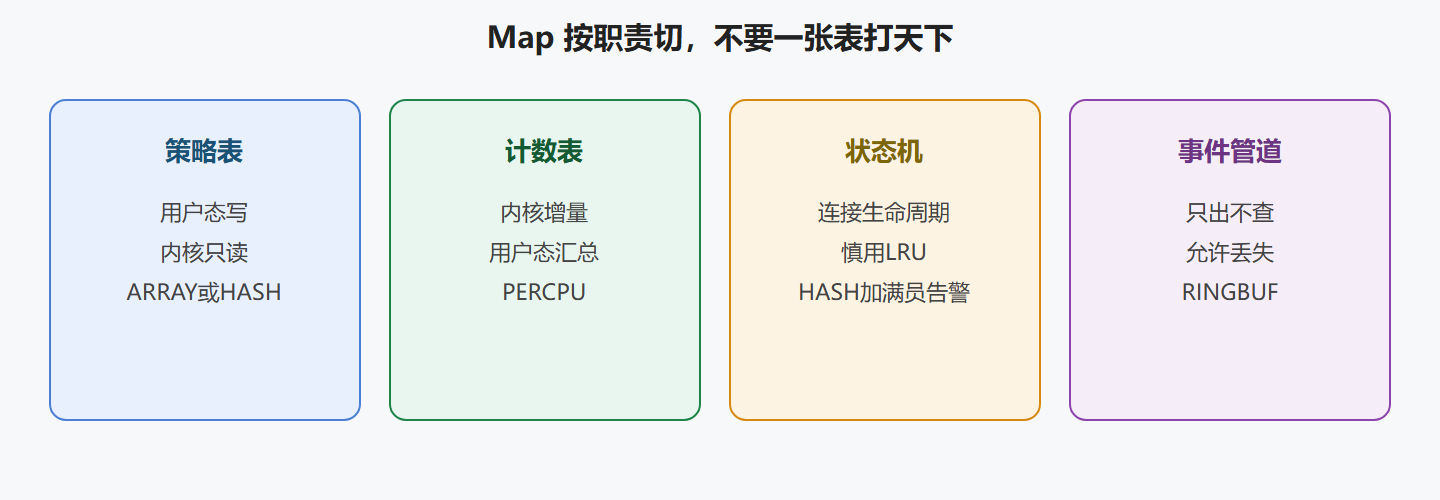
图:四类 Map 的职责切分
问题:能不能用一张 HASH 同时放策略、计数和日志?
能凑合,不该。值结构会膨胀,验证器更难证明访问,用户态扫描会拖住热键。按写入方向和寿命拆表,比省一次 lookup 更值。
问题:Map 满了程序会不会把内核打崩?
插入失败应返回错误码,程序继续。你如果忽略返回值,表现为“怎么计数停了”。崩核不该发生;静默停更常见,所以满员必须可观测。
四、连接表设计的一场具体讨论
假设你要跟踪本机所有 TCP 连接的创建到释放。第一反应是 HASH,键用五元组。五元组在 NAT 和端口复用下会碰撞,短连接高频时插入删除很热。改用 sock cookie 做键通常更稳,因为内核为套接字提供了在其寿命内唯一的标记。值里放创建时间、最后状态、所属 cgroup。容量按节点历史峰值的 1.5 倍,而不是按“理论最大端口数”。
满员策略禁止用 LRU 冒充释放。连接还活着就被挤掉,泄漏检测会假阴性,业务侧会以为问题已修好。满员时插入失败,失败桶加一,告警,必要时在用户态做一次慢速全表扫描(通过迭代器或辅助工具)找出是否有僵尸键。慢速扫描不走热钩子。
并发上,创建和关闭可能落在不同 CPU。值更新用原子字段,避免“读改写”丢失关闭标记。不要把整张连接表当日志往环形缓冲里塞每一次状态变化;只在异常迁移时出事件,例如从已关闭又看到发送。正常生命周期用计数器汇总即可。
用户态消费要定义清除。节点重启后内核 Map 没了,这很正常。若 pin 了,重启加载器会看见旧表,必须有版本号,防止新程序读旧布局。键值结构一变,旧 pin 要销毁重建,不要靠“差不多能读”。这是和数据库迁移一样的纪律,只是表在内核里。
内存数字要公开。把每张表的预算写进平台目录:名字、条目、估计字节、所有者。没有目录的 Map 就是幽灵内存。内核不会因为你忘了记账就不占页。定期对账能发现测试程序忘了卸。
现场笔记:PID 复用把安全规则串台
策略表用 PID 当键。短生命周期进程退出后,内核很快把 PID 给了另一个容器。旧策略还在,新容器被按旧规则限连,表现为随机故障。改成 cgroup id 加启动世代号后消失。PID 适合几秒内的追踪窗口,不适合跨分钟的策略。键的寿命必须短于标识符可能复用的时间,或改用不复用的标识。
满员告警也曾被当成噪音关掉。关掉之后泄漏检测假阴性,过了两天才发现表早满了,新连接根本没被跟踪。告警不是装饰。满员等于仪器盲区,盲区要按故障处理,不能按“表挺大的应该够”。容量规划错了就加容量或改基数,而不是关告警。
用户态有一次清零和内核增量打架,指标呈锯齿。后来规定计数表只由内核写,用户态只读差值。清零改成版本号切换:新版本新表,旧表丢掉。和数据库切换读写职责一样土,一样有效。土的规矩往往比聪明的双向写入更适合热路径。
延伸讨论:表目录比表聪明更重要
每张表登记名字、键、条目、估计字节、满员策略、写入方向、所有者。没有目录的表视为幽灵内存。内核不会因为你忘了记账就不占页。目录还能防止第四套临时表再来两百万条目。临时必须有到期。到期巡检卸不掉即事故。键的寿命短于标识复用周期,PID 尤其危险。计数表单向写。清零用换版本换表,不用双向撕扯。这些规矩土,热路径喜欢土规矩。聪明的双向写入会在指标上画出闹鬼的锯齿。锯齿会消耗一轮排障,排障时间足够写完目录。目录写完之后,锯齿通常自己消失,因为没有人再随手开表。随手开表是资源事故的幼体。幼体不可爱,该在加载门禁里被掐掉:不在目录里的 Map 名,CI 拒绝。
对照清单
- 跨事件记忆只能进 Map,栈上变量在下一次钩子里已经消失。
- 不能丢的状态机禁止 LRU,挤掉活连接会造成泄漏检测假阴性。
- PID 会复用,策略键用 cgroup 或 cookie,必须用 PID 时配启动世代。
- PERCPU 换锁不换全局一致,状态机不要拆到各 CPU 对不齐的副本上。
- 环形缓冲当查询表用会既查不到又丢数据,管道只出不查。
- 热路径禁止整表遍历,聚合在写入时做,迭代器留给巡检。
- 满员插入失败要告警,关掉告警等于仪器进入盲区。
- 策略表用户态写内核读,计数表相反,双向写会锯齿闹鬼。
- 结构一变必须销毁旧 pin 重建,差不多能读会把布局当命运赌。
- 每张表进目录:容量、字节、所有者,不在目录的 Map 名 CI 拒绝。
- 临时表必须到期,今晚的两百万条目会变成永久水位。
- 连接表键优先 sock cookie,五元组在 NAT 和端口复用下会碰撞。
课堂里我常让人先回答满了怎么办,再允许画表结构。答不出满了怎么办的表,会在某个周五晚上把插入失败当成业务量下降。业务量下降会引来错误的扩容。扩容解决不了盲区。盲区要用满员告警和基数上限来照亮。照亮之后,要么加容量并写进目录,要么改键减少条目。两条路都比沉默健康。沉默的表是最贵的表,因为它收了内存却不提供证据,还让人以为证据还在。
一节小结
- 火花无记忆:跨事件状态只能进 Map。
- 类型跟满员策略走:不能丢用 HASH 并限基数,能丢用 LRU 或环形缓冲。
- PERCPU 换的是锁,不是全局一致。
- 键避开 PID 复用;策略与计数分表、分方向。
- 热路径禁止整表遍历;聚合在写入时做。
- 满员是一等故障:要告警,不要指望内核替你崩溃提醒。
下一节看火花被允许按下去的那些按钮:Helper 的契约与边界。