4.1 追踪类:kprobe与tracepoint取舍
4.1 追踪类:kprobe 与 tracepoint 取舍
本节摘要:追踪类挂载点让你在函数入口、出口或内核埋点上醒来。kprobe 几乎能贴任何符号,信息全但符号一变就断;tracepoint 更稳,字段受限。uprobe 把同一思路用到用户态函数。延迟与逃逸类问题,多数先在这里找瞬间 T。
学习目标
阅读完本节,你应当能够:
- 对比 kprobe、kretprobe、tracepoint、uprobe 的稳定性与开销
- 说明生产为何优先 tracepoint,实验再下探 kprobe
- 设计“阈值才出栈”,避免把追踪变成新的负载
- 把延迟与逃逸场景映射到钩子方向
抓包看不见 connect 在内核里等什么,模块又太危险。追踪类钩子夹在中间:事件发生的那一拍,你拿到寄存器或预先定义的字段,记下就走。
一、四种听诊器
kprobe 贴在内核函数入口。参数在寄存器里,当时传入的指针你能看见。代价是函数名和内联。发行版一开优化,符号可能消失或被拆。贴在热路径上,等于每次调用多付一次跳转。
kretprobe 贴出口,拿返回值。实现上往往要在入口占坑,开销通常大于入口探针。看 connect 失败码很合适,扫每一个分配函数返回则很重。
tracepoint 是内核作者埋的点,字段相对稳定。信息量小于“我正好能看见那个结构体”,换来的是升级后还在。调度切换、系统调用进出,是生产首选。
uprobe 贴用户态函数。看运行时、解释器、特定库延迟,不必改应用。符号剥离、地址随机化、即时编译,会让它同样发脆。
交通卡口有两种。一种是交警随时站到任意路口,灵活,路口一改人就消失。一种是埋好的线圈,位置固定,车型信息少一点,雨天还在。生产路网用线圈,疑案再临时加岗。
| 种类 | 瞬间 | 稳定性 | 开销特征 | 适合 |
|---|---|---|---|---|
| kprobe | 任意内核函数入口 | 差,跟符号走 | 热路径上明显 | 实验、定位未知函数 |
| kretprobe | 函数返回 | 差 | 通常更重 | 看错误码与耗时 |
| tracepoint | 预埋点 | 较好 | 相对可控 | 生产常驻 |
| uprobe | 用户态函数 | 跟二进制走 | 看调用频率 | 应用内延迟,不改代码 |
二、延迟与逃逸分别该贴哪
支付接口 P99 跳升那类问题,系统调用进出的 tracepoint 通常够用:记下时间戳,出口减入口,超过阈值再送栈。不必一上来贴协议栈内部函数。内部函数能告诉你“卡在哪”,但版本一变,你的生产探针全军覆没。
逃逸演练更关心:谁在什么凭证下调用了 unshare、mount、ptrace。系统调用类跟踪点能给出参数轮廓;要文件路径等深层对象,再谨慎加 kprobe 或 LSM。LSM 见 4.3,这里只强调:追踪类默认是观察,不是拦截。你看见危险调用,不等于你拦住了它。
/* 概念性:出口看耗时,超阈值才送事件 */ SEC("tracepoint/syscalls/sys_exit_connect") int on_connect_exit(void *ctx) { u64 dt = now_ns() - lookup_enter_ts(); if (dt < THRESHOLD_NS) return 0; submit_event_with_pid_and_dt(dt); return 0; }
⚠️ 常见坑:在
clone、read这类极热调用上无条件送完整栈。节点会用观测把自己打满,故障现场被你污染。
💡 关键直觉:先证明频率,再决定要不要栈。计数几乎免费,栈很贵。
三、工程取舍:稳定点不够时怎么下探
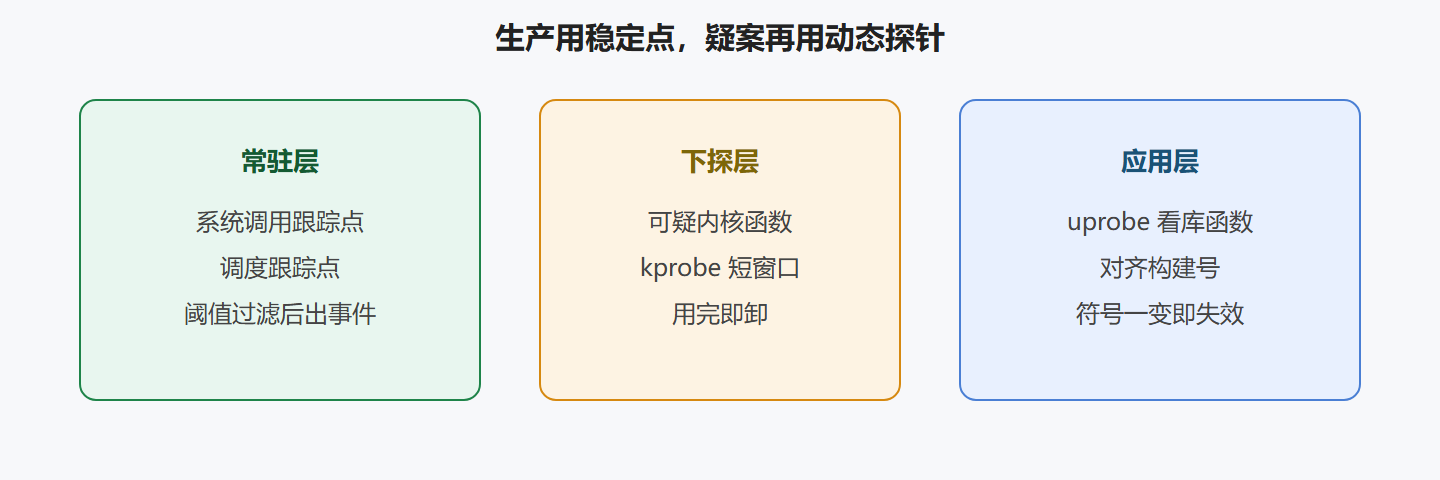
生产探针清单应写成“跟踪点名 + 字段”,而不是“内核源码行号”。下探 kprobe 时:
- 用 BTF 确认符号还在,CO-RE 读字段,避免写死偏移。
- 限制 PID、cgroup、时间窗,实验结束立刻卸。
- 同一功能尽量挂一条,不要入口出口各来一套还加定时采样。
- 内核模块符号和静态内联函数经常贴不上,贴不上就回到跟踪点或换问题问法,不要为了贴上而关优化。
uprobe 要对齐二进制构建 ID。发布一次前端,用户态符号表变了,探针静默失效,计数归零。看起来像“故障好了”,其实是听诊器掉了。
图:从稳定点下探到动态探针
问题:tracepoint 没有我想要的字段怎么办?
先看能否用已有字段加 Map 关联补全。还不够,实验机 kprobe 验证假设,再决定是否值得常驻。向内核提交新跟踪点是正路,但解决不了今晚的故障。
问题:fentry/fexit 相对 kprobe 是什么关系?
它们是更新的函数边界挂钩,依赖 BTF,开销通常更小、类型信息更好。能用时优先于传统 kprobe。仍属于“跟函数符号走”的一类,稳定性和 tracepoint 不是同一档。
四、符号消失之后你该怎么证明不是“故障好了”
生产上最阴的一种假象,是探针静默失效。内核升级、函数被内联、用户态二进制更换,计数归零。值班同事会写:“延迟恢复正常”。其实是听诊器掉了。防御办法是为每个常驻探针配心跳:用一个已知高频、极轻的跟踪点做对照计数,例如时钟节拍或一个必定发生的系统调用。对照还在、业务探针为零,才是“没事件”;对照也零,才是“挂钩层坏了”。
符号管理要进发布。内核升级清单里加一项:本节点 eBPF 程序是否仍能挂上关键跟踪点。自动化在升级后先跑加载自检,失败则告警并保持旧探针——如果旧内核模块包还在的话。对 eBPF 来说旧探针往往随新内核一起重新加载,自检失败就不要宣称升级完成。
kprobe 的实验记录应包含:符号名、BTF 确认时间、窗口开始结束、卸没卸干净。没卸干净的实验探针会在下周的性能复盘里变成谜。平台巡检把“无所有者的 kprobe”当成漏洞。能用跟踪点完成的实验,不要因为“我想看看内部函数好不好看”就长期留下动态探针。
uprobe 要对构建号。持续集成在产出应用二进制时记下 build id,探针配置引用这个 id,对不上就拒绝挂载。拒绝比静默零数据更安全。运行时语言的 JIT 区域通常不适合当长期挂钩点,那是一次性实验。
和性能团队共用剖析器时,约定互斥窗口。两套栈采样叠在一起,会改变你们都想测量的东西。追踪类工具看起来轻,叠起来就不轻。清单再一次成为法律。
现场笔记:升级后延迟“自愈”
内核小版本升级后,延迟指标恢复正常。庆贺了半天,发现是 kprobe 符号被内联,探针没了。心跳跟踪点还在涨,业务探针为零,这才露馅。若没有心跳,这次假自愈会写进月报。从此常驻只用跟踪点,kprobe 必须带窗口和所有者,升级检查包含挂钩自检。
实验 kprobe 也曾被留到下一周。性能复盘里多出来的 CPU 找不到主人。巡检加上无主动态探针告警之后,这类税消失了。动态探针的默认寿命应是小时,不是永远。要永远,就去申请跟踪点或改成生产规格走发布。
uprobe 在一次前端发布后静默。构建号没对齐,挂载仍返回成功但打在旧偏移上,数据像乱码。后来挂载前核对 build id,对不上就失败。失败可见,乱码不可见。可见的失败能进发布门禁,不可见的乱码会进错误的产品决策。
延伸讨论:心跳探针是假自愈的天敌
每个常驻追踪程序配一个已知高频的轻量心跳。心跳在、业务计数为零,才是没事件。心跳也零,才是挂钩层坏了。没有心跳,符号消失会被写成故障自愈并登上月报。升级检查包含挂钩自检,自检失败不得宣称升级完成。动态探针默认寿命按小时计,要永远就走发布改成跟踪点。uprobe 核对 build id,对不上就失败,不要带着旧偏移产生乱码。乱码会进错误产品决策。失败能进门禁,乱码不能。和剖析器约定互斥窗口,两套栈采样会一起改变想测的东西。清单是法律。法律不管你是不是只想看一眼。看一眼也要登记,登记才能在下周找到税从哪来。税从无主 kprobe 来的次数,足够让人相信巡检。
对照清单
- 生产常驻优先跟踪点,动态探针只给有窗口的实验,窗口结束必须卸干净。
- 心跳探针区分没事件和挂钩消失,没有心跳的归零可能被写成自愈。
- 热系统调用禁止无条件完整栈,先频率后出栈,否则观测自己成为负载。
- kretprobe 通常更重,只为返回值和耗时服务,不要扫每一个分配函数。
- uprobe 对齐构建号,对不上就失败,旧偏移乱码会进错误的产品决策。
- fentry 能用时优先于传统 kprobe,但仍跟符号走,稳定性和跟踪点不是一档。
- 追踪默认旁观,看见危险调用不等于拦住,拦截走 LSM 并走双开关。
- 升级后挂钩自检失败不得宣称升级完成,自检是升级的一部分。
- 无主 kprobe 当漏洞巡检,动态探针默认寿命按小时而不是永远。
- 和剖析器互斥窗口,两套栈采样会一起改变你们都想测的东西。
- 内部函数能告诉卡在哪,但版本一变生产探针全军覆没,先用稳的点。
- 实验记录包含符号、BTF 确认时间、窗口、是否卸净,没卸净会进下周复盘。
我见过最贵的 kprobe 不是写错的那条,是留下忘了卸的那条。它不出现在发布记录里,只出现在 CPU 账单里。账单不会写符号名。于是复盘会变成猜。猜的成本高于当初申请一个跟踪点。所以动态探针必须像危险品:有窗口、有主人、有归还。归还不了的,升级成常驻规格走发布,或者删除。删除是归还的一种。归还比继续看一眼更专业。看一眼的人已经下班,探针还在班。
\n\n## 课堂补充\n\n跟踪点像埋好的线圈,雨天还在;kprobe像临时岗,路口一改人就没。心跳在业务零才是真没事件。动态探针按小时计寿命。构建号对不上就失败。完整栈很贵,频率先说话。旁观不是拦截。升级自检失败升级就没完。无主探针当漏洞。剖析器叠采样会改现场。内部函数好看但不稳。实验记录必须写清卸没卸。\n\n\n\n## 生产验收条\n\n1. 围绕「追踪类kprobe与tracepoint取舍」,生产验收只认能关掉、能计数、能对账,不认口头保证。\n2. 围绕「追踪类kprobe与tracepoint取舍」,把所有者、版本、卸载方式写成清单三件套,缺一视为幽灵。\n3. 围绕「追踪类kprobe与tracepoint取舍」,对照实验必须能回答开关前后业务指标动了没有。\n4. 围绕「追踪类kprobe与tracepoint取舍」,失败要分类到验证、额度、挂载、未触发、丢失,禁止只丢一句笼统错误。\n5. 围绕「追踪类kprobe与tracepoint取舍」,热路径默认克制,阈值之后才出栈,出栈之前先证明钩子活着。\n6. 围绕「追踪类kprobe与tracepoint取舍」,和平台已有挂钩点冲突时先登记再加载,禁止手工抢挂。\n7. 围绕「追踪类kprobe与tracepoint取舍」,内核版本矩阵没跑绿就不能把功能写成必成功路径。\n8. 围绕「追踪类kprobe与tracepoint取舍」,回滚必须碰到内核对象,心跳停止才算撤回成功。\n\n## 重点提炼
- kprobe 全而脆,tracepoint 稳而窄;生产优先后者。
- kretprobe 更重,只为返回值和耗时服务。
- 追踪默认观察不是拦截;拦截看 LSM 与网络钩子。
- 先计数后出栈,热系统调用禁止无条件完整栈。
- uprobe 跟二进制走,发布后要核对构建号。
- 下探有窗口:贴上、验证、卸掉,不要把实验探针留到下周。
下一节把听诊器挪到网卡到协议栈的路上:XDP 与 TC 差的不只是快一点。