6.2 生态工具:bpftrace Cilium与观测栈
6.2 生态工具:bpftrace、Cilium 与观测栈
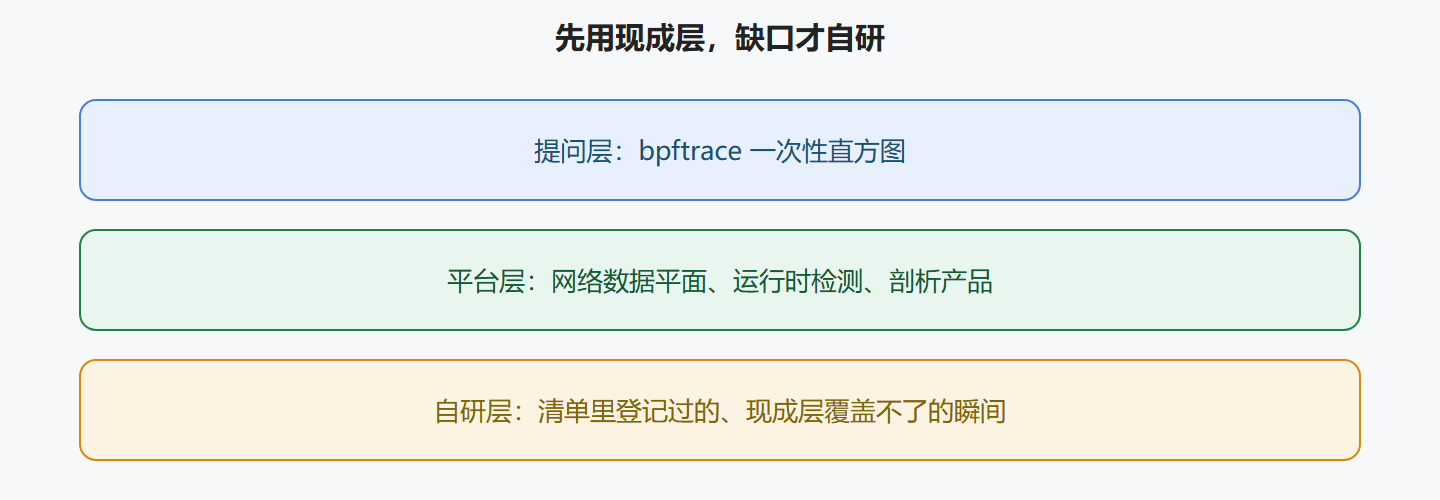
本节摘要:bpftrace 适合对内核问一句就走;Cilium 一类把 eBPF 做成集群数据平面;Falco、Pixie、剖析器则把钩子封装成产品。自己写程序前,先问节点上是否已经有人挂了同类钩子。生态工具解决的是分工,不是让你再叠一层探针。
本节导读
阅读完本节,你应当能够:
- 说出 bpftrace 与常驻守护的边界
- 解释为什么不要在 Cilium 节点上手动抢 XDP
- 把指标、追踪、日志接到 Map 和环形缓冲时注意丢失
- 用一张表做“买现成还是自己写”的决策
第 6.1 节假设你要写。很多时候你不该写。写错挂钩点,会和已经在生产里干活的数据平面互踩。
一、bpftrace:把问题写成一句
bpftrace 把跟踪点、聚合、打印收成脚本语言。适合:“这个系统调用现在有多热?”“这个函数返回值分布是什么?”几分钟得到直方图,问题结束就退出。
不适合:复杂状态机、跨版本产品、需要精细权限模型和制品签名的常驻策略。脚本能写很长,但你不会想在半年后的故障里读它。活过一周的逻辑,迁到 libbpf。
急诊问诊:“哪里痛?”bpftrace 就是那句问。病程管理要病历系统,不是反复问同一句。
二、Cilium 与平台:数据平面是主权
Cilium 用 eBPF 替换大量 iptables 路径,做网络策略、负载均衡、可观测。节点上的挂钩点、Map、甚至 XDP 归属平台。你在同一张网卡上再挂一条“临时 XDP”,可能把策略打瞎,也可能被下一次平台调和冲掉。
规则:集群网络问题先看平台能力。平台没有的观测,用追踪类挂自己的程序,并在平台文档允许的挂钩点注册。安全团队的 LSM 程序同样要进统一清单,避免两个产品对同一系统调用各挂各的、开销翻倍。
Falco 一类把系统调用规则做成检测产品。Pixie 一类强调应用观测。剖析器把栈采样做成持续剖析。它们内部都是 eBPF,但对你是产品。重复实现它们已经提供的直方图,是在用更差的工程换熟悉感。
| 需求 | 优先现成 | 自己写的理由 |
|---|---|---|
| 临时问一句内核 | bpftrace | 无 |
| 东西向网络策略 | Cilium 等 CNI | 平台无法表达的特殊设备路径 |
| 运行时检测 | Falco 等 | 规则引擎覆盖不了的内部协议 |
| 持续剖析 | 剖析产品 | 需要与内部调度器字段对齐 |
| 连接状态机排障 | 可能自己写 | 现成工具没有你的业务键 |
| 线速丢特定攻击特征 | 可能自己写或 WAF | 特征必须在 XDP 且平台未提供 |
三、接到观测栈时,丢失是一等公民
Map 计数很适合做成指标:用户态定时读、求和、暴露。注意 per-CPU 汇总和清除语义,避免重复计数或抖动。
环形缓冲接到日志或追踪后端时,要暴露丢失计数。后端慢,内核不会无限等你。丢失时,告警应说“证据不全”,而不是假装 P99 真实。
不要把每个系统调用变成一条追踪跨度。采样、阈值、示例(exemplar)三件套,和第 4.1 节同一纪律。观测栈再完善,也救不了你在热钩子上无条件出栈。
⚠️ 常见坑:同一节点装三套“eBPF 可观测”产品,各挂各的系统调用探针。CPU 账单会告诉你它们很勤奋,故障证据却更碎。
💡 关键直觉:先做挂钩点清单。谁挂了什么、频率、Map 内存,比再引入一个产品更重要。
图:提问、平台、自研三层不要叠成一座山
问题:bpftrace 能代替 libbpf 产品吗?
短期能冒充。长期在版本、权限、测试、签名上会裂。把它当 REPL,不当服务。
问题:没有 Kubernetes 还有没有这些生态?
有。单机一样能用 bpftrace 和 libbpf。Cilium 的价值在集群身份与策略,单机不必硬上。不要为了“云原生”把单机问题复杂化。
四、指标、日志、追踪如何从 Map 里长出来
Map 计数最适合做成瞬时值或速率。用户态每 10 到 15 秒读一次,做差,暴露给指标系统。读取间隔不要短到变成新的热路径,也不要长到把 8 秒的故障平均没。直方图桶在内核里加好,用户态不要再把事件重放一遍来画桶,那会把环形缓冲变成慢速数据库。
事件适合做成日志或追踪的示例。默认采样,例如百分之一,命中慢调用则必采样。后端要能接受丢失:高峰丢事件时,仪表盘应显示“证据覆盖率下降”,而不是用剩余事件画一条看起来平静的线。覆盖率本身是一等指标。
和网格追踪对齐时,用一个双方都认识的键,例如 Trace 上下文里的某 id,或至少用 sock cookie 在两边各记一笔。强行在内核里解析全部 HTTP 头来取追踪码,会把 XDP/TC 拖进七层。能在用户态 sidecar 取的,就不要在内核取。内核负责“这个瞬间发生了”,用户态负责“它属于哪次请求”。
产品重叠时做减法。若剖析产品已经在采栈,你的延迟探针就不要默认出栈,只出耗时桶。若 Cilium Hubble 已经给出连接级观测,你的连接表就不要再复制一份五元组日志。减法比加法难,因为每个团队都想要自己的面板。平台用挂钩预算强制减法:新挂钩必须证明旧挂钩覆盖不了。
把生态工具的版本和 eBPF 程序版本一起记。平台升级可能挪走你依赖的挂钩点。升级说明里若写“数据平面更换挂钩”,你的自研程序要重新登记。忽略升级说明,是幽灵探针和静默零数据的常见来源。
现场笔记:三套可观测产品叠在同一系统调用上
节点 CPU 不明上涨。清单显示三套产品各挂了系统调用探针,各出各的栈。合成之后,业务 P99 自己变差。减法之后只留剖析产品出栈,另外两套只保留计数。面板变少,节点变稳。挂钩预算强制减法:新挂钩必须证明旧挂钩覆盖不了。证明不了就买面板融合,不买第四套探针。
bpftrace 一次性脚本被做成常驻服务,缺签名、缺矩阵、缺丢失计数。活过一个月后没人敢改。最终重写成 libbpf 守护。提问工具当服务,利息是技术债。债总会以故障形式催收。
平台升级挪了 XDP 挂钩,自研程序没登记,升级后静默失效。从此平台升级说明必须列挂钩变更,自研必须重新登记。忽略升级说明,是零数据的常见来源,排在符号内联之后。
延伸讨论:挂钩预算是减法的牙齿
新挂钩必须证明旧挂钩覆盖不了。证明不了就融合面板,不买第四套探针。三套产品叠在同一系统调用上,P99 会自己变差。bpftrace 常驻化缺少签名矩阵和丢失计数,活过一个月就没人敢改,最终仍要写成守护。提问工具当服务,利息是债。平台升级若挪挂钩,自研必须重新登记。忽略升级说明是零数据的常见原因。指标来自 Map 差值,直方图在内核加好。事件默认采样,高峰丢事件时显示覆盖率下降,不许用剩余事件画假平静。覆盖率是一等指标。内核负责瞬间发生了,用户态负责属于哪次请求。在内核解析全部 HTTP 头取追踪码,是把七层抢进最贵的渡口。贵的渡口留给垃圾包。请求身份留给更靠后、更有对象的地方。地方选错,生态再好也是叠床。
对照清单
- bpftrace 是提问不是服务,活过一周的逻辑迁到 libbpf。
- 数据平面挂钩点是主权,不要在 Cilium 节点上手动抢 XDP。
- 先做挂钩清单再引入产品,三套系统调用探针会让 P99 自己变差。
- 新挂钩必须证明旧挂钩覆盖不了,证明不了就融合面板。
- Map 计数做指标要注意 per-CPU 汇总和清除语义。
- 环形缓冲接到后端必须暴露丢失,覆盖率下降要显示出来。
- 热钩子不要每个系统调用都变成追踪跨度,用采样阈值和示例。
- 内核负责瞬间发生了,用户态负责属于哪次请求,不要在 XDP 解析全部 HTTP 头。
- 平台升级若挪挂钩,自研必须重新登记,忽略说明是零数据常见原因。
- 单机不必硬上集群数据平面,不要为了云原生把单机问题复杂化。
- Falco 剖析器 Pixie 内部都是 eBPF,重复实现它们已有的直方图是浪费挂钩预算。
- 减法比加法难,用挂钩预算强制减法,预算数字在第 5 章和第 8 章。
生态工具会让人误以为自己理解了挂钩点。理解挂钩点的标志是能画出节点上已经挂了谁,而不是能列出五个产品名。列得出产品名、画不出清单,下一步通常是再买第六个。第六个仍会挂在同一系统调用上。同一系统调用不因为品牌不同而变成两条路径。路径就那么几条。几条路径的预算是有限的。有限的预算要留给缺口表里还空着的那一拍。空着的那一拍可能根本不需要新产品,需要的是把旧产品的出栈关掉。关掉也是生态治理。治理比采购难,但 CPU 只认治理。
\n\n## 课堂补充\n\n提问工具不当服务。数据平面勿手抢。清单先于产品。旧挂钩覆盖了就做减法。per-CPU要汇总。丢失要显示。热调用别全变跨度。七层身份留给用户态。升级说明要登记。单机别硬上网格。重复直方图浪费预算。CPU只认治理不认品牌。\n\n\n\n## 生产验收条\n\n1. 围绕「生态工具bpftrace Cilium与观测栈」,生产验收只认能关掉、能计数、能对账,不认口头保证。\n2. 围绕「生态工具bpftrace Cilium与观测栈」,把所有者、版本、卸载方式写成清单三件套,缺一视为幽灵。\n3. 围绕「生态工具bpftrace Cilium与观测栈」,对照实验必须能回答开关前后业务指标动了没有。\n4. 围绕「生态工具bpftrace Cilium与观测栈」,失败要分类到验证、额度、挂载、未触发、丢失,禁止只丢一句笼统错误。\n5. 围绕「生态工具bpftrace Cilium与观测栈」,热路径默认克制,阈值之后才出栈,出栈之前先证明钩子活着。\n6. 围绕「生态工具bpftrace Cilium与观测栈」,和平台已有挂钩点冲突时先登记再加载,禁止手工抢挂。\n7. 围绕「生态工具bpftrace Cilium与观测栈」,内核版本矩阵没跑绿就不能把功能写成必成功路径。\n8. 围绕「生态工具bpftrace Cilium与观测栈」,回滚必须碰到内核对象,心跳停止才算撤回成功。\n\n## 重点提炼
- bpftrace 是提问,不是服务。
- 数据平面挂钩点是主权,勿手工抢 XDP。
- 先查现成产品,再写自己的状态机。
- 多产品叠加前先做挂钩清单。
- 指标来自 Map,事件来自环形缓冲,丢失必须可见。
- 热钩子采样,观测栈不能当借口打满 CPU。
下一章处理跨内核生存:BTF、CO-RE,以及在验证器上限内组合复杂程序。