8.1 性能开销从哪来怎么砍
8.1 性能开销从哪来怎么砍
本节摘要:eBPF 不是零开销。开销 ≈ 触发频率 × 每次指令与 Map 访问 × 拷贝到用户态的字节。kprobe 贴在热函数上,比 XDP 丢包还容易把 P99 打穿。优化先降频率,再减每次工作,最后才谈 JIT 和硬件。没有对照实验的“感觉变快”,不算砍掉了。
阅读收获
阅读完本节,你应当能够:
- 写出一段探针的开销公式并指出最大项
- 用对照实验证明是探针而不是业务变更导致恶化
- 在降采样、移挂载点、减出栈之间选择
- 识别 Map 缓存失效与环形缓冲竞争这类间接开销
第 1.1 节已经警告:观测会污染现场。生产上这句话变成预算。
一、公式比口号有用
把一次挂钩想成:
额外延迟 ≈ 命中次数 × 每次执行时间 + 事件字节 × 拷贝与中断 每次执行时间 ≈ 指令路径 + Map 查找次数 × 查找延迟
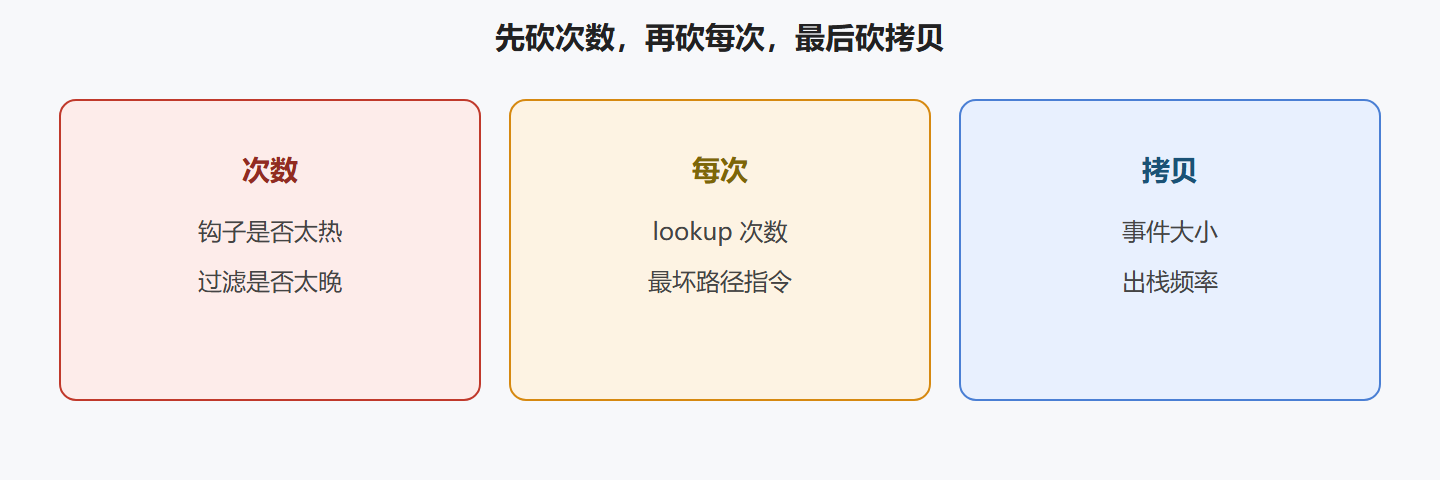
命中次数由挂载点决定。read 系统调用的跟踪点,次数可以是每秒百万。同一个逻辑挂在“只在 connect”上,次数掉几个数量级。所以第一刀永远是:换更稀的瞬间,或在瞬间里先过滤。
每次执行时间由你塞进火花里的活决定。三次哈希、一次内核字符串拷贝、一次无界味道的循环,比 JIT 开没开影响更大。第 5.2 节的最坏路径,就是攻击者和高峰流量会走的路。
拷贝项被忽视得最多。你把每次调用的整张栈送进环形缓冲,用户态再解析,CPU 花在观测管道上,不花在业务上。阈值和直方图把拷贝项打下去,往往比“换更快的 Map 类型”有效。
二、间接开销:看起来不在你的程序里
缓存。 高频 HASH 查找打在大表上,会挤掉业务的缓存。微基准里程序只要 80 纳秒,线上却和业务抢 L3。
锁与伪共享。 非 per-CPU 的计数在多核上打架。改 PERCPU 后“程序没变慢、节点却好了”,是这类。
缓冲竞争。 多程序共用事件管道,一个爱说话的探针让别人丢事件,排障会怪错对象。
多团队叠加。 十条“很轻”的系统调用探针,等于一条很重的。平台没有清单,优化单条没有意义。
医院若每个科室给病人加一台 24 小时心电,病房插座和护士巡视都会崩。不是某台仪器不合格,是叠加。
| 杠杆 | 做法 | 预期收益 | 代价 |
|---|---|---|---|
| 降频率 | 换跟踪点、PID/cgroup 过滤、时间采样 | 通常最大 | 可能漏短事件 |
| 减每次工作 | 少 lookup、固定头、有界循环 | 中到大 | 信息变少 |
| 减拷贝 | 阈值才出栈、小事件结构 | 大 | 现场细节变少 |
| per-CPU | 计数改每 CPU | 中 | 用户态要汇总 |
| 换挂载点 | 热 kprobe 改为稀 tracepoint 或 XDP | 视场景 | 对象可能变少 |
| 硬件卸载 | 过滤上卡 | 极大 | 语义子集、绑定网卡 |
⚠️ 常见坑:用平均 CPU 判断探针无害。eBPF 伤害经常在尾延迟和缓存,平均值可以纹丝不动。
💡 关键直觉:先做开关对照。不能关的探针,不是生产探针。第 8.3 节把“能停”做成发布条件。
三、怎么证明你砍到了真凶
不要只看探针自己的计数。跑三组:全关、只开计数、开完整出栈。若只开计数就已经伤 P99,是频率问题,减字段没用。若计数无害、出栈有害,砍拷贝。若两者都无害但大表一开就伤,查 Map 大小与查找。
对照要在同一流量特征下。高峰才伤、低峰看不出,是典型缓存与队列问题。用生产流量的录制或镜像,比用微基准说服自己更重要。
XDP 丢包程序的开销故事相反:正确的 XDP 会让 CPU 下降,因为垃圾不再进栈。若你加了 XDP CPU 反而上升,多半走了通用路径,或程序在做复杂解析。回到 4.2 看你到底在哪一拍。
/* 概念性:热路径只计数,冷路径才出事件 */ if (dt < THRESHOLD) increment_hist_bucket(dt); else submit_sample(dt);
图:三刀切在不同层
问题:JIT 之后还要优化吗?
要。JIT 只是把已证明的指令变成本地码,不减少你设计的查找和拷贝。它不是折扣券。
问题:怎样给领导一个“开销上限”?
用最热钩子的频率上限 × 每次预算纳秒,换算成核数百分比,再加内存预算。超了就不准上。没有数字的“影响很小”过不了第 1 章那种故障夜。
四、一次真实对照该怎么排期
对照实验在生产上要像变更。选一个流量与错误率稳定的小池,先记录至少一天的 P99、CPU 尾延迟、丢失计数基线。然后只打开无条件计数,再记录一个高峰时段。若基线已被破坏,停。若可接受,打开直方图。再可接受,打开抽样出栈。每一步写进变更单,每一步都有回滚点。不要在同一次变更里同时改挂钩点和出栈大小。
业务方要知情。他们可能把 P99 波动当成自己的发布问题。提前说“这小时我们在校准探针”,能减少误复盘。校准结束无论成败,都发对照数字:基线、只计数、完整模式。数字比“感觉还行”更能成为以后砍功能的依据。
低峰校准不够。有些开销只在连接数高、表变大时出现。校准窗口必须包含你担心的那种高峰,或用流量镜像把高峰打到校准池。没有高峰样本的“无害结论”,到了大促会破产。大促前只允许减探针,不允许加未校准的出栈。
砍开销时优先关别人也能提供的能力。若剖析产品已出栈,你的栈就关。若指标已有耗时桶,事件就降采样。自己的面板会变丑,节点会变稳。面板丑可以再讨论,节点不稳要在故障夜还债。
把对照脚本化,不要靠人手记。加载器提供模式旗标:off、count、hist、sample。旗标在 Map 里,热切换。脚本切模式、拉指标、切回去。下一次换内核,再跑一遍脚本。开销是版本的函数,不是一次测量管三年。
现场笔记:平均值很健康,P99 在哭
探针上线后平均 CPU 不动,业务 P99 从 8 毫秒到 30 毫秒。当时有人说观测无害。对照开关一关,P99 回去。伤害在缓存和尾延迟,不在平均值。从此验收禁止只看平均 CPU,必须看业务 P99 和 CPU 尾延迟。没有对照,不许宣称无害。
三组实验揭开真凶:只计数几乎无害,出栈一开就伤。砍的是拷贝不是挂钩点。若先去换 Map 类型,会浪费一周。实验顺序比优化灵感重要。先关拷贝,再谈别的杠杆。
大促前有人想加抽样率。拿出上次灰度数字:百分之一可接受,百分之十没测过。没有成功基线就保持旧抽样。大促只减不增。增的欲望永远有,数字才能挡。挡不住的团队会在大促后写一份“观测也有责任”的复盘,那种复盘读起来很痛,因为本来可防。
延伸讨论:对照脚本化,大促只减不增
模式旗标放 Map:关、计数、直方图、抽样。脚本切模式、拉业务 P99、切回。换内核再跑。开销是版本的函数。验收禁止只看平均 CPU。三组实验先定位是频率还是拷贝。大促前不提高未测过的抽样率,只减。成功灰度的数字当预算上限留下。别人已提供的出栈能力,自己关。面板丑,节点稳。节点稳比面板全重要。不能关的探针不是生产探针。这句话要能在评审里把方案打回去。打不回去的团队,会在大促后写观测也有责任的复盘。那种复盘的读者是未来的自己。自己会问为什么当时不加对照。所以现在加。现在加对照,比未来写复盘便宜。便宜的选择要靠脚本,不靠记性。记性在高峰会丢。脚本不会丢,除非你没把脚本当制品发布。脚本也要进制品库。制品库里的对照,才是真对照。
对照清单
- 开销约等于频率乘每次加拷贝,第一刀永远砍频率。
- 看尾延迟和缓存,不要只看平均 CPU,平均值可以纹丝不动。
- 三组对照:全关、只计数、完整出栈,才能定位真凶。
- 间接开销包括大表挤缓存、非 per-CPU 争用、多程序抢管道。
- 能关才是生产探针,不能关就还不是产品。
- 正确 XDP 应让 CPU 下降,上升则挂错层或解析过重。
- 大促只减不增,未测过的抽样率不许临时提高。
- 成功灰度数字当上限留下,下次有人想加十倍拿数字挡。
- 模式旗标热切换并脚本化,开销是版本的函数要复测。
- JIT 不是折扣券,不减少你设计的查找和拷贝。
- 给领导的上限用最热钩子频率乘每次预算换算核百分比。
- 校准必须包含高峰或镜像高峰,低峰无害结论到大促会破产。
优化讨论如果从 JIT 开始,多半会结束于没有对照数字。对照数字会告诉你该砍的是次数还是拷贝。砍错杠杆会浪费一个迭代。迭代里程序还在生产上出栈。出栈还在伤 P99。P99 还在被业务方当成自己的锅。锅要先从对照开关拿回来。拿回来之后再谈 Map 类型。Map 类型很少是第一真凶。第一真凶通常是太勤快的出栈和太热的钩子。勤快看起来敬业。敬业的仪器可以杀死病人。病人是业务。业务比敬业贵。所以敬业要有开关。开关要在高峰前演练过。演练过才敢说我们能砍。能砍的团队才配加功能。加功能是奖励,不是默认。
\n\n## 课堂补充\n\n公式先写再砍。平均值不当证据。三组对照定位真凶。间接开销在缓存和管道。不能关就还不是产品。XDP正确应降CPU。大促只减。数字挡抽样欲望。脚本化复测。JIT不是优惠券。上限要换算成核。低峰结论禁止直接上大促。\n\n\n\n## 生产验收条\n\n1. 围绕「性能开销从哪来怎么砍」,生产验收只认能关掉、能计数、能对账,不认口头保证。\n2. 围绕「性能开销从哪来怎么砍」,把所有者、版本、卸载方式写成清单三件套,缺一视为幽灵。\n3. 围绕「性能开销从哪来怎么砍」,对照实验必须能回答开关前后业务指标动了没有。\n4. 围绕「性能开销从哪来怎么砍」,失败要分类到验证、额度、挂载、未触发、丢失,禁止只丢一句笼统错误。\n5. 围绕「性能开销从哪来怎么砍」,热路径默认克制,阈值之后才出栈,出栈之前先证明钩子活着。\n6. 围绕「性能开销从哪来怎么砍」,和平台已有挂钩点冲突时先登记再加载,禁止手工抢挂。\n7. 围绕「性能开销从哪来怎么砍」,内核版本矩阵没跑绿就不能把功能写成必成功路径。\n8. 围绕「性能开销从哪来怎么砍」,回滚必须碰到内核对象,心跳停止才算撤回成功。\n\n## 核心回顾
- 开销公式:频率 × 每次 + 拷贝。第一刀砍频率。
- 看尾延迟和缓存,不要只看平均 CPU。
- 间接开销:大表、非 per-CPU、多程序抢管道。
- 三组对照:全关、只计数、完整出栈。
- 能关才是生产探针。
- XDP 正确时 CPU 应下降;上升则挂错层或解析过重。
下一节按固定顺序拆现场:没数据、变慢、验证失败,分别卡在哪一闸。