1.1 核心定义与内涵
1.1 核心定义与内涵
本节摘要:元编程(Metaprogramming)是"以代码为操作对象的编程"——普通程序加工数据,元程序加工程序本身。本节给出可操作的定义与判定标准,拆解"程序即数据"的同像性思想,并用对照实验厘清元编程与封装、复用的边界,为全书的讨论立好标尺。
先把术语放上台面
日常交流里,"元编程"常被说玄了:有人把它等同于"很难懂的代码",有人以为它是某种语言的专属特性。这两个印象都不对。要把它放上台面,最好的办法是找一面镜子——普通编程。
普通编程解决的问题是:给定输入数据,如何产出正确结果。你写一个排序函数,操作的是数字列表;写一个订单处理器,操作的是订单对象。数据是被动的,代码是主动的,两者界限分明。
元编程把这条界限打破了:代码本身成了被操作的数据。一段元代码的输入或输出,是另一段代码——它可能生成一个类、改写一个函数、查询某个类型的字段清单,甚至在自己运行的过程中修改自己的结构。判定一条技术是不是元编程,就看它是否满足这个测试:代码在这个机制里是"原料"还是"产品"。
用这个测试过一遍常见手段,归属立刻清晰:
| 手段 | 代码是原料还是产品 | 是否元编程 |
|---|---|---|
| 普通函数封装重复逻辑 | 代码只是行为定义 | 否 |
| Python 装饰器接收函数并返回新函数 | 被装饰的函数是参数 | 是 |
| C++ 模板根据类型实例化出新代码 | 类型参数驱动代码生成 | 是 |
| 序列化库按字段名逐个手写转换 | 代码写死,不操作代码 | 否 |
| 库在启动时扫描注解并注册处理器 | 注解描述代码结构供程序读取 | 是 |
注意表格最后一行的微妙之处:注解本身只是"贴在代码上的标签",但读取这些标签并据此改变行为的逻辑是元编程。元编程是一种关系,不是一个孤立特性。
一、从两段代码看抽象的两种高度
光有定义还不够直观。我们做一个最小对照实验:同一个需求——"给所有对外函数加上耗时统计"——分别用普通抽象和元编程实现,看代码形态差在哪里。
背景是一个正在做性能排查的服务,十几个对外函数都需要记录执行耗时。第一反应是普通抽象:把计时逻辑封装成公共函数。
import time def timed_call(func, *args, **kwargs): start = time.perf_counter() result = func(*args, **kwargs) cost = time.perf_counter() - start print(f"{func.__name__} 耗时 {cost:.4f} 秒") return result def query_user(user_id): time.sleep(0.1) # 模拟查询 return {"id": user_id} # 调用点必须改写:从直接调用变成包一层 data = timed_call(query_user, 42)
这个方案能跑,但每个调用点都得手动包一层 timed_call。漏包一处,统计就缺一角——计时逻辑的正确性依赖人的自觉。
元编程的做法是反过来:不改变任何调用点,让函数在被定义的那一刻自动完成包装。
import time import functools def timed(func): @functools.wraps(func) # 保留原函数的名字与文档 def wrapper(*args, **kwargs): start = time.perf_counter() result = func(*args, **kwargs) cost = time.perf_counter() - start print(f"{func.__name__} 耗时 {cost:.4f} 秒") return result return wrapper @timed # 定义即改写:query_user 在创建时被替换 def query_user(user_id): time.sleep(0.1) return {"id": user_id} data = query_user(42) # 调用点零改动,统计已生效
结果:两个版本的运行行为完全一致,但元编程版本把"哪些函数要计时"从调用点的纪律问题变成了定义点的声明问题。加一个新函数,忘记计时的概率趋近于零,因为不写 @timed 这行声明反而需要理由。
解读这个案例的关键在于视角:@timed 语法在 Python 里只是 query_user = timed(query_user) 的缩写,但正是这层缩写改变了责任边界——普通抽象要求调用方记住规则,元编程让规则在代码成形时就已执行。代价同样藏在里面:被装饰后的 query_user 不再是源码里那个函数,调试时堆栈会多出一层 wrapper,后人阅读代码必须理解装饰器机制才能推断真实行为。能力换责任,这笔交换在每种元设施上都会重演,只是形式不同。
变式思考:如果计时需求扩展到"只统计慢于阈值的调用",普通抽象要改所有调用点的判断逻辑,装饰器只需要在 wrapper 内部加一个条件——元编程把变化收敛到了一个位置。但如果需求变成"统计逻辑要按业务线不同",装饰器里就会长出 if-else 丛林,那是第六章要拆的滥用信号。
二、"程序即数据":同像性这一激进路线
定义里还有一层更深的内涵值得单独说:有少数语言里,代码和数据的界限不是被打破,而是从一开始就不存在。
Lisp 是代表。它的源代码写成 S 表达式——带括号的嵌套列表:
;; 一段普通的加法调用 (+ 1 2) ;; 用 quote 把它变成"数据":一个包含符号和数字的列表 '( + 1 2 ) ;; 用 eval 把"数据"变回代码执行 (eval '( + 1 2 )) ; 结果 3
同一个结构,加上引号就是数据(一个三个元素的列表),去掉引号就是代码(一次加法调用)。这种代码与数据共用同一种表示的性质叫同像性(homoiconicity)。它带来的直接后果是:操纵代码不需要任何专门工具——操纵列表你会吧?那操纵代码你也会。Lisp 的宏之所以能安全地"重写语言",根基就在这里。
多数主流语言没有同像性,它们选择了另一条务实的路:让开发者在编译或运行的某个环节间接接触代码的结构化表示。C++ 模板接触的是类型系统里的符号,Java 反射接触的是运行时里的类元数据,Rust 过程宏接触的是词法解析后的语法树。表示形式各异,思想同源——都是把代码从"只可远观的文本"变成"可以下手的数据结构"。理解了这一层,第三章拆解四大机制时你会发现它们只是同一种思想在不同时机、不同表示上的实现。
三、边界辨析:它不是封装,也不是复用
初学者最常见的混淆是把元编程当成"高级封装"。三个判据可以划清边界:
判据一:操作对象。 封装操作的是数据与行为,元编程操作的是"描述行为的那段文本或结构"。封装是把重复逻辑收进函数;元编程是改变"函数如何被定义"这件事本身。
判据二:执行时机。 封装逻辑在程序运行时按需执行;元代码很多在你以为程序还没开始的地方就跑完了——编译期展开的宏、实例化时推导的模板、类定义时执行的元类。第六章讲性能时会看到,这个时机差异既是优化空间,也是排错盲区。
判据三:产物。 封装的产物是运行结果;元编程的产物常常是新的代码构件——类、函数、方法、类型。你交付的不再是行为,而是"生成行为的规则"。
图:普通代码与元代码的认知层次
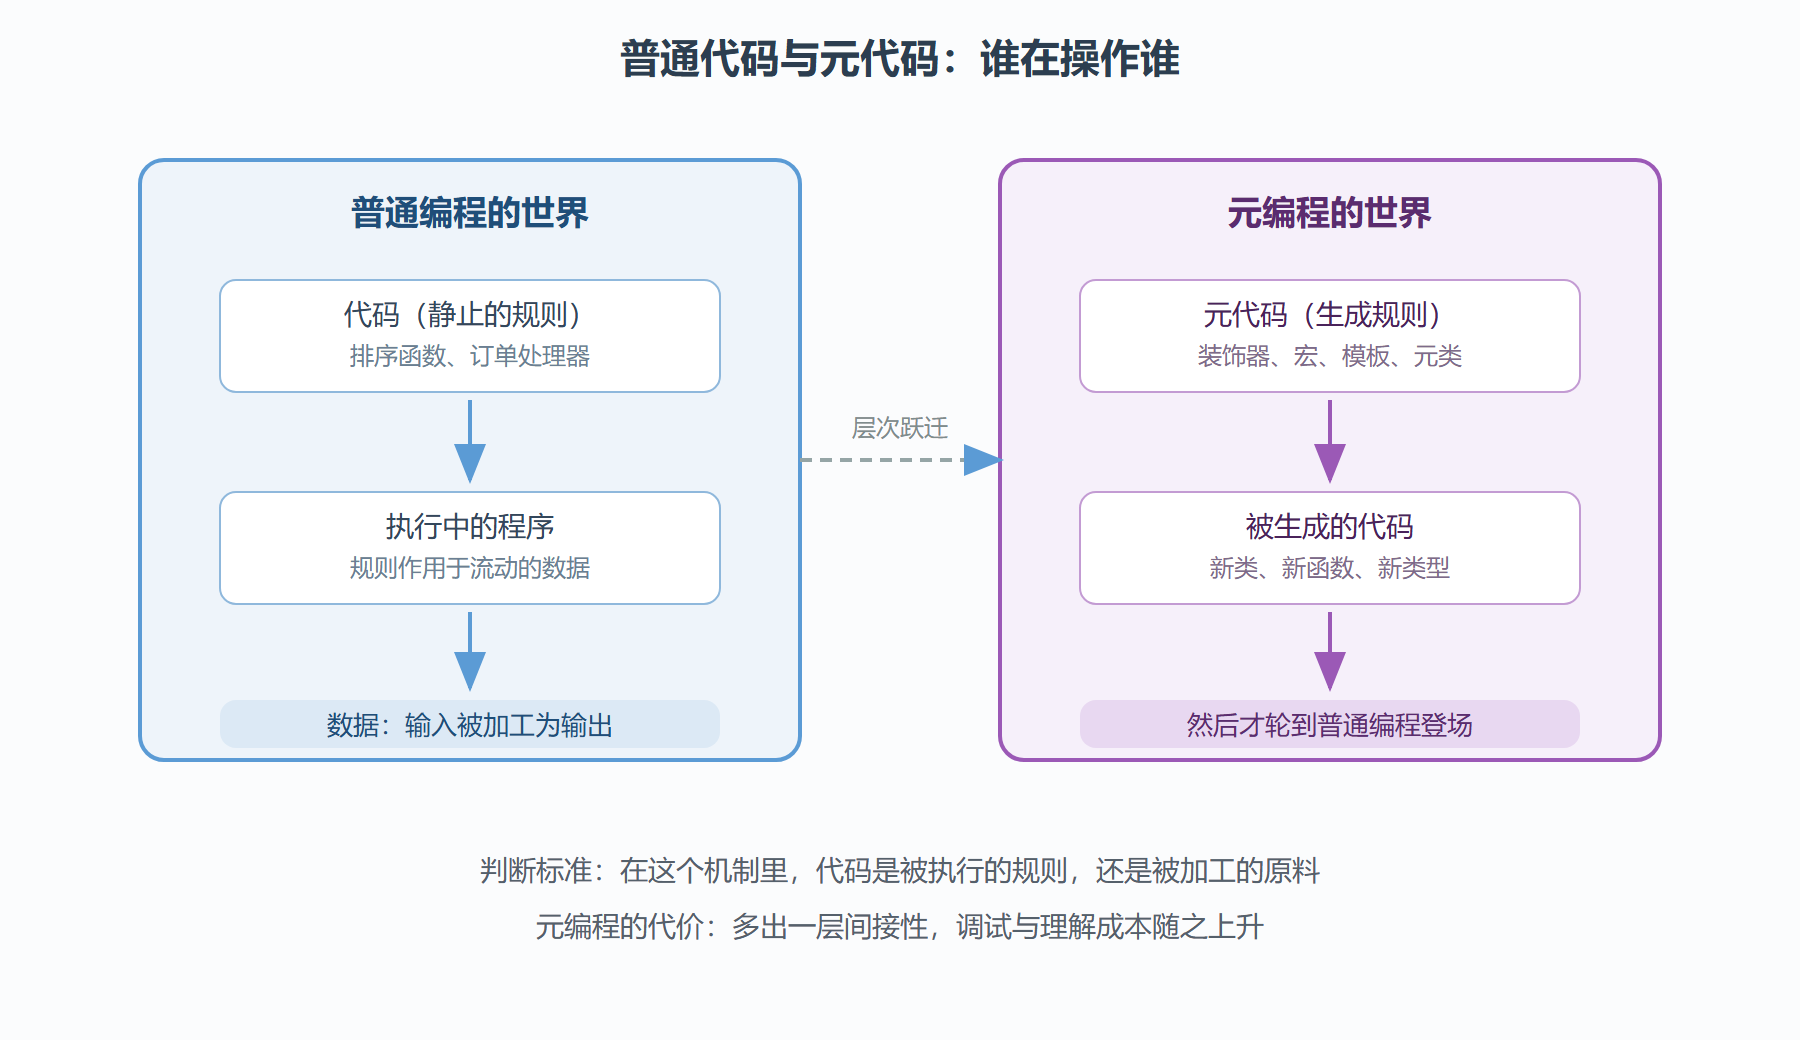
把三判据记牢,回看本章开头的计时案例就彻底通了:装饰器操作的是函数对象(判据一),包装发生在函数定义时而非调用时(判据二),产物是一个行为被增强的新函数(判据三)。三条全中,如假包换的元编程。
本节要点回顾
- 核心定义:元编程是以代码为操作对象的编程,判定测试是"代码在这个机制里是原料还是产品"。
- 两段代码的对照:普通抽象把规则交给调用点纪律,元编程把规则提前到定义时刻执行——能力与调试责任同时增加。
- 同像性:Lisp 里代码与数据共用 S 表达式表示,操纵代码因此不需要专门机制;主流语言用"间接接触结构化表示"实现同一思想。
- 三判据辨析:操作对象、执行时机、产物,三者齐备才算元编程,缺一则只是封装或复用。
- 代价意识:每一层元间接都会抬高理解与调试成本,这笔账从第一节课就要开始记。
下一节沿着时间轴走一遍元编程的演化史,你会发现上述每一对"收益与代价",都是七十年里一代代语言设计者反复讨价还价的同一个议题。