2.2 能力维度分类
2.2 能力维度分类
本节摘要:元能力按强度分为两级——内省(introspection)指只读地查询代码结构,干预(intercession)指动手改写结构与行为。本节用 Python 作解剖标本演示两级能力的具体形态,论证"干预必须站在内省的肩膀上"这一依赖关系,并给出能力强度与工程风险的换算表。
把能力拆成两级
时间轴回答"何时动手",能力轴回答"动到什么程度"。这两问组合起来才是完整定位,缺一不可——同样是运行期技术,能查类结构但不能改的反射系统,和能现场造出新类的元类系统,工程风险天差地别。
内省:程序在运行中观察自身或其他程序的结构——这个对象是什么类型、有哪些字段、方法签名长什么样、函数参数默认值是什么。特点是只读,不动任何东西。
干预:程序在运行中改变结构——给类增删方法、替换函数实现、动态构造新类型、拦截并改写属性访问。特点是写入,结构从此与源码不再一一对应。
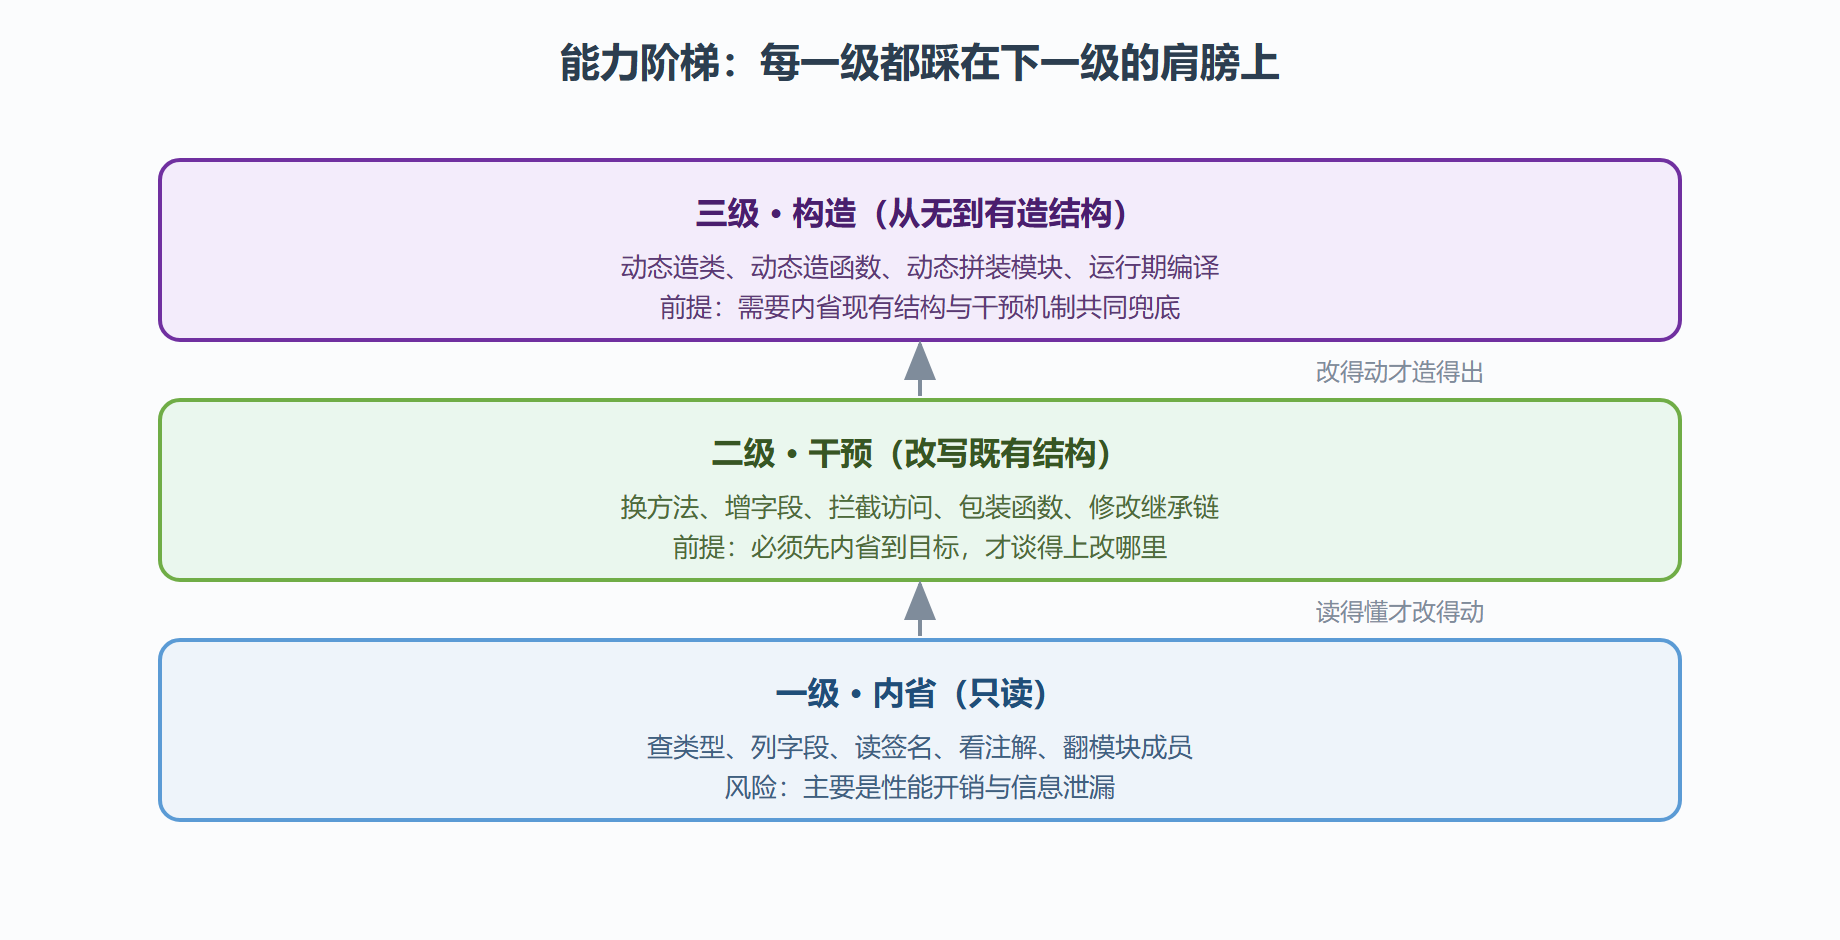
图:内省与干预的能力阶梯
一、内省:元认知的观察模式
Python 的标准检查模块是内省能力的最佳教具。看一段真实的排查现场:接手了一个陌生库,文档缺失,只知道一个函数对象,需要弄清它怎么用。
import inspect def transfer(amount, target_account, *, currency="CNY", note=""): """转账:金额、目标账户,支持币种与备注""" # 在交互环境里对函数对象逐项查询 print(type(transfer)) # 函数类型 print(inspect.signature(transfer)) # 剩下 amount 与 target_account,关键字参数带默认值 print(transfer.__defaults__) # 位置参数默认值:无 print(transfer.__kwdefaults__) # 关键字参数默认值:currency 与 note print(inspect.getdoc(transfer)) # 文档字符串
操作→结果:inspect.signature 返回的签名对象精确描述了参数名、种类与默认值——不用读源码就知道怎么调用。解读:内省的价值在程序读程序。上面这套路数正是智能提示、测试框架参数校验、序列化库字段发现的底层原理:框架并不"认识"你的类,它只是在内省你交上来的对象。
内省的风险面较窄,主要是两条:查询本身有开销(热点路径反复反射查询会被性能账单追上,见第六章);以及信息泄漏面——把任意对象的成员清单暴露给外部输入驱动的逻辑,可能连带暴露出不该被触碰的内部成员。防护思路是白名单过滤,而不是禁用内省。
二、干预:结构从此与源码分家
干预能力把问题从"它是什么"变成"让它变成什么"。继续用 Python 演示,这次对类动手:
class PaymentService: def charge(self, amount): return f"已扣款 {amount}" # 干预一:从外部给类追加方法(猴子补丁) def refund(self, amount): return f"已退款 {amount}" PaymentService.refund = refund print(PaymentService().refund(50)) # 服务类当场"长"出了退款能力 # 干预二:包装既有方法,注入审计逻辑 original_charge = PaymentService.charge def audited_charge(self, amount): print(f"审计:charge 被调用,金额 {amount}") return original_charge(self, amount) PaymentService.charge = audited_charge
操作→结果:类在运行期获得了源码里不存在的方法,既有方法的行为也被替换。解读:干预改变了"源码即真相"的假设——排查这段代码的人,单看类定义完全推断不出 refund 与审计日志的存在。这正是干预能力的第一张风险标签:行为的真相散落到多个位置。
治理经验值得直接给出:猴子补丁这类干预在测试桩替换、热修复场景有正当用途,但必须有注册中心——所有补丁集中在一处声明、带注释说明补丁理由与移除条件,禁止散落在业务代码各处"顺手改一下"。散落的补丁是第六章翻车案例的常客。
三、两级之间的依赖关系:先看见,才动手
内省与干预不是并列选项,而是上下游工序。回看上面的补丁代码:PaymentService.refund = refund 这句写入之前,程序必须先拿到 PaymentService 这个类对象——这一步就是内省。任何干预操作都隐含一次内省:找到目标、确认结构、再动手。
这个依赖关系反过来不成立:大量正当的内省场景完全不涉及干预。只读检查意味着源码之外的行为零增量,因此工程上有一条清晰的审批阶梯:能用内省解决的不上干预,能改既有结构的不动态造新结构。能力每上一级,评审严格度就该上一个档位。
顺带一提,Python 之外的语言在这条轴上分布很有意思:Java 反射默认只给一级能力,改结构要借助加载期字节码工具;C++ 模板能做编译期"构造",运行期内省却几乎为零;Lisp 两级全开且门槛一致。这些差异的全貌,留到 2.3 的坐标系里一次性铺开。
常见疑问
问:内省只是"看一眼",也会有安全风险吗? 看什么、给谁看,本身就是权限问题。内省会向调用方暴露对象的成员结构,若调用逻辑被外部输入驱动(比如按请求里的字段名做反射查询),结构信息就成了探测面。所以治理线不止性能一条:对外部输入驱动的内省,同样适用白名单。
问:团队有人用元类实现"子类必须实现某方法"的约束,值得跟进吗? 先做降档检查:这个需求用抽象基类加实例化检查同样能实现,报错更友好、工具支持更好。元类的价值只在"需要拦截类创建本身"的场景(比如要改写字段定义)。能用低档能力就不用高档,这条审批阶梯对个人学习同样适用——先精通内省,再学干预,最后才碰构造,跳级省下的时间都会在排错时加倍还回去。
本节要点回顾
- 两级定义:内省是只读查询结构,干预是改写结构与行为,构造是从无到有造新结构。
- 依赖方向:干预以内省为前提——先找到目标才谈得上改写;反之不成立。
- 内省风险:性能开销与信息泄漏,防护靠缓存查询结果与白名单过滤。
- 干预风险:行为真相散落、源码不再是唯一事实源,治理靠集中注册与移除条件声明。
- 审批阶梯:能内省不干预、能改旧不造新,能力每上一级评审加一档。
两根轴都已立起。下一节把它们交叉成一张完整的定位地图,给主流元技术逐一发放坐标身份证。