3.1 反射机制
3.1 反射机制
本节摘要:反射(Reflection)是程序在运行期查询并操作自身结构的机制,是"运行期 × 内省"坐标的旗舰技术。本节拆解反射的三步基本流程——查类型、列成员、动态调用,用插件发现案例走完整闭环,并给出缓存查询结果与白名单过滤两条治理线。
从一个运行时的追问开始
设想一个通用数据导出服务:业务方把任意对象丢进来,服务负责把它转成键值对的表格输出。服务上线时根本不知道业务方会传什么类——这就是反射存在的理由:在类型完全未知的运行现场,程序需要向对象本身提问。你是什么类型?你有哪些字段?这个方法我能调吗?反射就是这套问答协议的官方接口。
一、三步基本流程:查类型、列成员、动态调用
以 Java 为解剖标本(Python 的思路完全一致,API 名不同),三步流程如下:
import java.lang.reflect.Field; import java.util.LinkedHashMap; import java.util.Map; public class Exporter { public static Map<String, Object> toMap(Object obj) throws Exception { Map<String, Object> row = new LinkedHashMap<>(); // 第一步:查类型——拿到描述对象结构的 Class 元数据 Class<?> clazz = obj.getClass(); row.put("_type", clazz.getSimpleName()); // 第二步:列成员——遍历字段清单 for (Field field : clazz.getDeclaredFields()) { field.setAccessible(true); // 打开私有字段的访问许可 row.put(field.getName(), field.get(obj)); } return row; } }
动态调用是第三步:按名字找到方法并执行,调用者在写代码时并不知道方法名。
// 方法名来自外部输入(例如配置里的 "normalize") Object cleaned = clazz .getMethod("normalize", String.class) // 按名查方法 + 参数类型 .invoke(obj, " raw value "); // 等价于 obj.normalize(" raw value ")
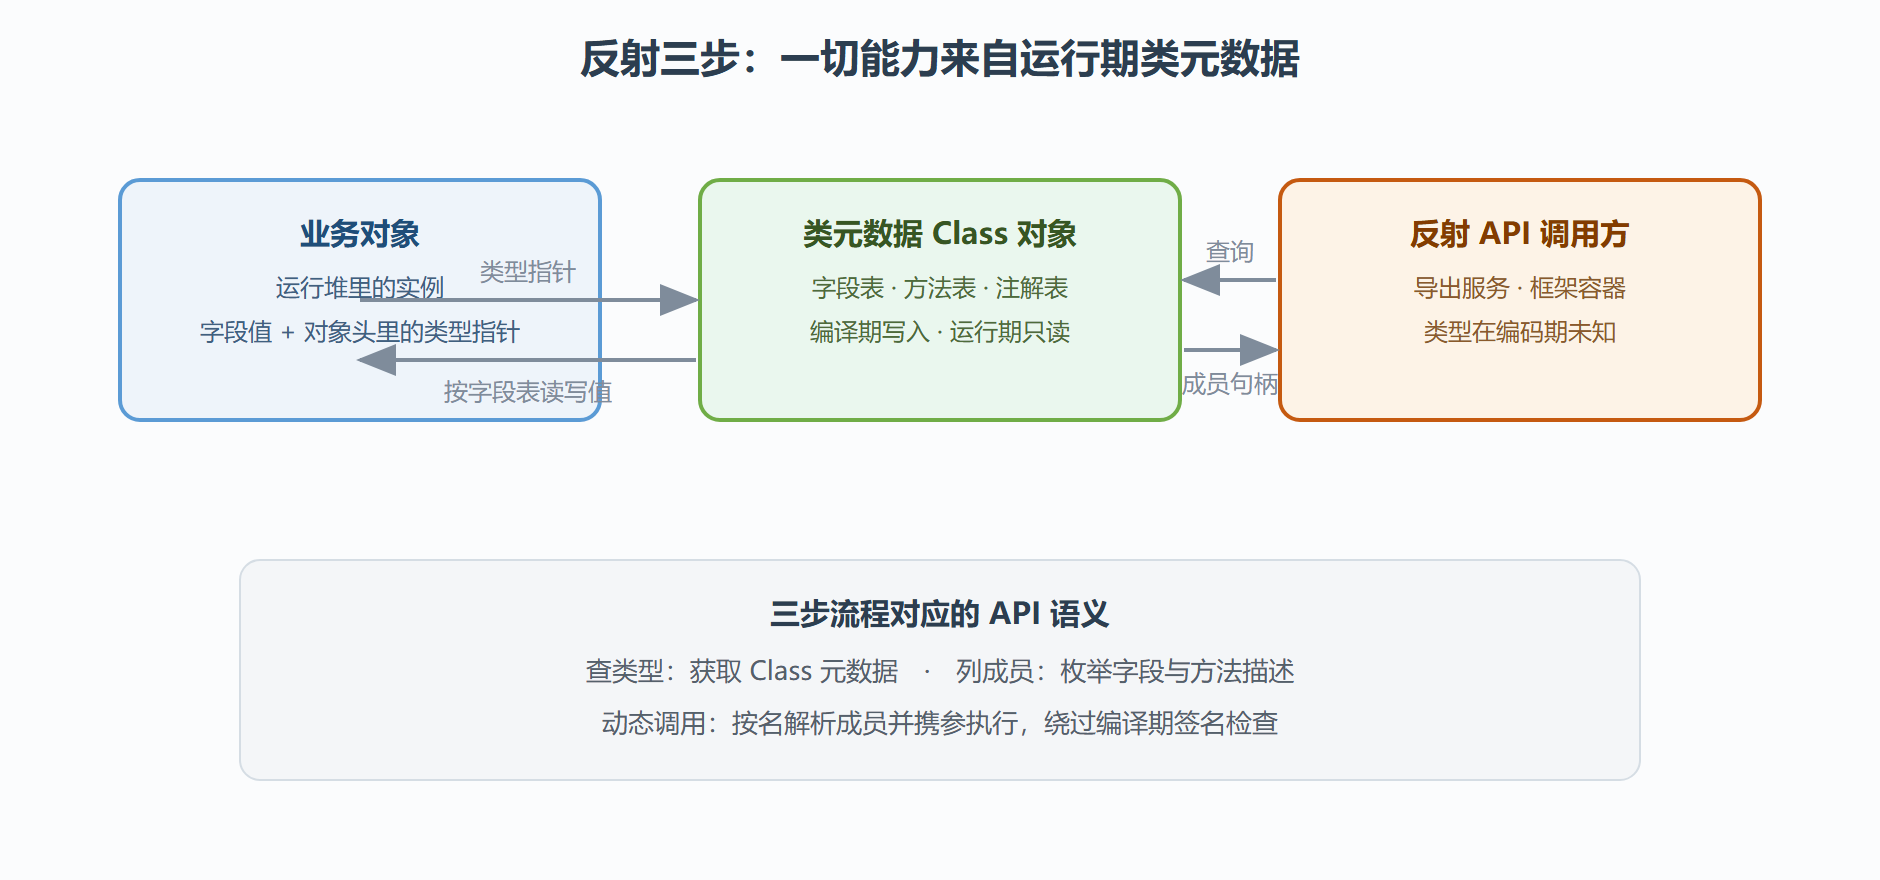
三步的内在逻辑值得点破:Class 对象是一份运行期类元数据——编译器在编译时把类的结构信息写进产物,运行时环境加载后把它暴露成可编程对象。反射的一切能力都源于这份元数据的存在。这也解释了反射的能力边界:元数据里没有的信息(比如 C++ 编译后丢弃的类型信息),反射就无从谈起——这正好呼应 2.1 的时机规则。
图:反射调用的内部通道
二、完整案例:插件发现与注册
背景:一个批处理平台要支持第三方扩展——开发者实现约定的处理器接口、打上标记注解,平台启动时自动发现并注册所有处理器,不允许修改平台代码。
操作分三步。第一步,扫描:启动时遍历扩展目录里的构件包,用类加载器枚举其中类型。第二步,过滤:对每个类型做内省——是否实现了处理器接口、是否标了 @Processor 注解、能否无参构造。第三步,注册:符合条件的类型反射实例化,按注解里声明的任务类型放入注册表。
for (Class<?> candidate : scannedClasses) { if (!Processor.class.isAssignableFrom(candidate)) continue; // 接口校验 ProcessorMeta meta = candidate.getAnnotation(ProcessorMeta.class); if (meta == null) continue; // 注解校验 Processor instance = (Processor) candidate.getDeclaredConstructor().newInstance(); registry.put(meta.taskType(), instance); // 按声明注册 }
结果:平台零改动接入了一批新处理器,第三方包即插即用。解读:这个流程里内省负责"把关"(接口与注解校验),动态构造负责"接入"(newInstance),两者配合正是"先看见、再动手"的 2.2 阶梯在工程里的样子。变式:注册动作若改为按注解里声明的优先级排序,或按构造参数注入依赖,代码骨架不变——反射流程的可复用性正是框架普遍采用它的原因。
这个案例也埋着两个坑:扫描全部类型的启动耗时随扩展包数量线性增长;newInstance 抛出的受检异常会把构造失败延迟到运行期。前者靠启动时缓存元数据解决,后者没有编译期解法——这正是 2.1 说的运行期代价。
三、治理线:缓存与白名单
反射的两个高频病灶各有成熟处方。性能病灶:方法查找、可访问性检查、参数装箱的固定开销,在循环里被放大。处方是把"查询"与"调用"分离——Method/Field 句柄查一次、缓存复用,甚至升级为字节码级的方法句柄; hotter 路径干脆预生成调用代码(这条变式在 3.4 展开)。经验数值上,未缓存的反射调用比直接调用慢一个数量级,缓存后差距可缩到两三倍以内,具体取决于运行时的内联优化。
安全病灶:setAccessible(true) 撕开封装、注解驱动的自动调用放大了"不可信输入变成代码路径"的风险。处方是白名单:允许反射操作的类型与成员必须显式登记,登记之外的请求一律拒绝并留审计日志。序列化框架历史上多次反序列化漏洞,根因几乎都是"反射入口直接暴露给不可信数据"——白名单不是可选项,是底线。
⚠️ 常见坑:把反射查询写进热点循环。正确做法是查询一次存入静态缓存,循环里只用缓存句柄;或者干脆在加载期把反射改写为直调。
本节要点回顾
- 能力来源:反射的一切能力来自编译期写入、运行期暴露的类元数据——元数据没有的信息查不到。
- 三步流程:查类型、列成员、动态调用,对应"先看见、再动手"的能力阶梯。
- 插件案例:扫描、过滤、注册的闭环展示了内省与动态构造的协作,也暴露启动开销与异常延迟两个运行期代价。
- 性能治理:查询与调用分离,句柄缓存复用,热点路径预生成直调代码。
- 安全治理:白名单登记反射入口,拒绝未登记操作并留审计。
反射解决的是"运行期看见与调用"。下一节转到编译期:宏如何在代码成形之前就完成改写,以及文本宏为什么注定被语法宏取代。