1.1 从λ演算到多核时代:函数式的历史坐标
1.1 从λ演算到多核时代:函数式的历史坐标
本节摘要:函数式编程不是近年发明的时髦范式,它的数学地基——λ演算——比第一台电子计算机还早诞生。理解这条从邱奇、Lisp、ML 到 Haskell、再到多核时代全面回潮的演化线,你会明白函数式的每个核心特性都不是凭空设计,而是对某个真实工程困境的历史回应。
先把一个行话说清楚
工程师圈子里流传一句行话:"函数式是学院派的玩具。"这句行话错得离谱,却值得拆一拆,因为它恰好标出了本节的入口。λ 演算诞生于二十世纪三十年代,图灵机的论文和它同源同岁,今天所有编程语言的函数调用、参数传递、作用域规则,几乎都能在 λ 演算里找到原型。一门"玩具"能当整个学科的地基用九十年,说明问题不出在技术上,而出在传播上——本节的任务,就是把这条被误传的历史捋直:函数式不是空想出来的范式,它是被一代代真实的工程困境逼出来的解决方案。
一、前史:在没有计算机的年代定义"可计算"
故事从阿隆佐·邱奇讲起。这位逻辑学家给自己定了一个看似纯数学的问题:什么叫"可以被计算出来的函数"?他的答案是构造一个极简的形式系统——λ演算。整个系统只有三样东西:变量、抽象(相当于定义匿名函数)、应用(相当于调用函数)。没有数字、没有循环、没有赋值,甚至没有"先做这个再做那个"的顺序概念,仅靠一条 β-归约规则,它表达出的计算能力就与图灵机等价。
用一个例子感受它的味道。下面的伪代码演示"平方"与"加一"在 λ 演算风格下的复合——先定义函数,再做函数复合,全程没有一条赋值语句:
-- Haskell 是 λ演算最直系的后代之一 -- 定义:square x = x * x square :: Int -> Int square x = x * x -- 定义:inc x = x + 1 inc :: Int -> Int inc x = x + 1 -- 复合:先平方再加一,数学记法 inc . square result = (inc . square) 5 -- 结果:26 -- 整个"计算过程"就是不断把表达式化简为更简的表达式, -- 与 β-归约 (λx. M) N -> M[x:=N] 完全同构
这段代码里没有"变量被改变"这回事:x 绑定了值就不再变,计算就是表达式替换表达式。这就是函数式的原始基因——计算的本质是符号变换,不是状态迁移。记住这句话,它是后面一切内容的种子。
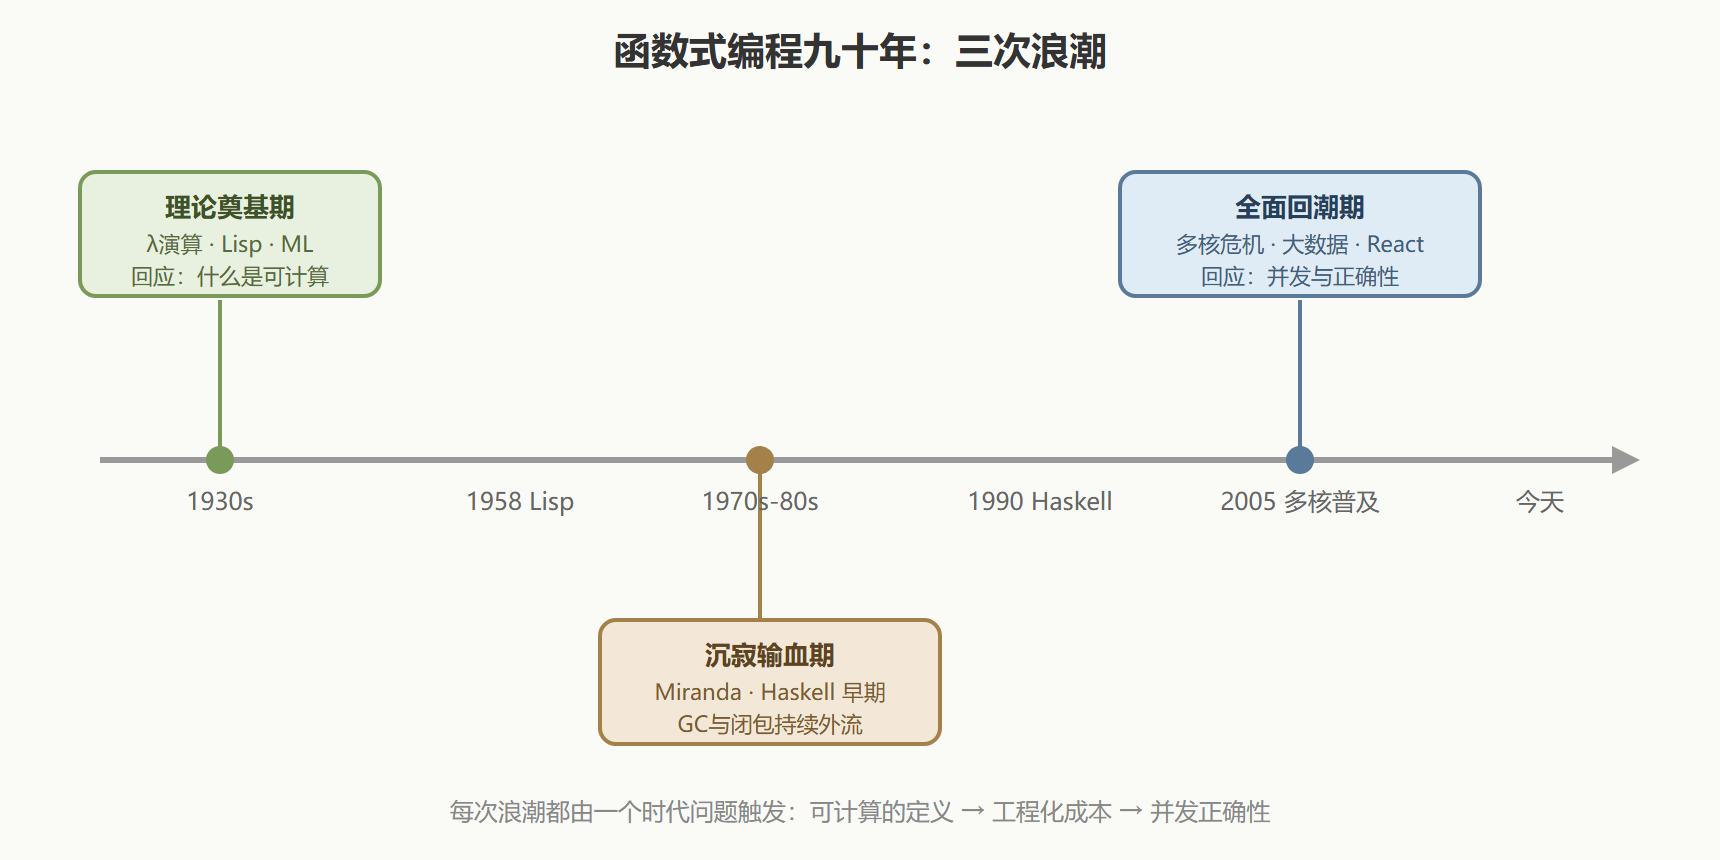
Lisp 在 1958 年把 λ 演算搬上了真实硬件。麦卡锡的设计有两个影响深远的选择:代码和数据统一用 S 表达式表示(于是程序可以像操作数据一样操作程序,宏系统由此而来);以递归为基本控制结构,而不是循环。此后十余年,函数式路线在学术界继续演化:ML 在七十年代带来自动类型推导和代数数据类型,Miranda 在八十年代确立了惰性求值的完整范式,1990 年问世的 Haskell 集大成——纯函数、惰性求值、类型类、Monad 四件套齐备,成为此后三十年函数式研究的标准载体。
二、沉寂的四十年:为什么工业界不买账
从 Lisp 商用受挫到上世纪末,函数式在工业界长期边缘化。原因不难列:机器内存以 K 计算的年代,不可变数据意味着大量拷贝,性能账单没人付得起;函数式语言的知识封存在学术会议论文里,缺教材、缺社区、缺现成轮子;更关键的是,当时的软件问题域——单机、单核、批处理——命令式范式应付得足够好。范式没有绝对优劣,只有与问题域的匹配度。
这段沉寂期里有一件事值得记住:函数式的思想没有死守在自家的语言里,而是持续向"敌营"输血。垃圾回收最早来自 Lisp 实现;泛型、闭包、匿名函数陆续被 C#、Java 吸收;ML 的类型推导启发了 Swift 和 Rust。工业界嘴上说不,身体很诚实。
三、翻红节点:多核危机与不可变性的二次登场
转折点出现在处理器架构层面。单核频率撞上物理墙之后,厂商转向多核并行,软件世界突然发现:命令式范式赖以简洁的"一段时刻只有一个东西在改状态",在并行世界里不成立了。锁能保住单块数据的正确性,却保不住锁组合起来的活性——死锁、竞态、优先级反转,成了多核时代的慢性病。
而函数式手里正好握着解药。不可变数据天生线程安全:数据不会被任何人修改,就无所谓"谁先谁后";纯函数天生可并行:没有共享状态,拆开算再合并结果,结果必然一致。Erlang 在电信交换机上数十年不掉线的运行记录、Clojure 把软件事务内存做成标准库、Scala 在大数据框架里的统治地位,都是这条路线的实证。与此同时,浏览器端 JavaScript 被 React 用"UI 是状态的纯函数"重新发明了一次,前端工程师在不知不觉中集体接受了函数式训练。
图:函数式演化时间线与三次浪潮
四、读史的三个推论
回看这条时间线,有三个推论直接服务后面的学习。推论一:函数式的每个特性都有明确的"敌情"背景——不可变是对竞态的回应,纯函数是对不可复现 bug 的回应,Monad 是对"副作用到处渗漏"的回应;学特性时先问它防的是什么,理解成本立刻减半。推论二:范式之间是吸收关系而非替代关系,今天的主流语言都在朝"多范式"演化,所以第 5 章的多语言对照才成为可能。推论三:历史还在继续,第 8 章讨论的效应系统、依赖类型,就是这条线的延伸段。
五、亲手做一次:用三个版本写"词频统计"
历史读完了,用一个所有人都写过的需求——统计一段文本里每个单词出现的次数——对比三种范式在代码形态上的差异。命令式版本:
# 命令式:显式维护一个可变字典,逐步累积 def word_count_imperative(text): counts = {} for word in text.split(): word = word.lower().strip(",.!?") if word: counts[word] = counts.get(word, 0) + 1 # 状态原地修改 return counts # 输入 "to be or not to be" # 输出 {'to': 2, 'be': 2, 'or': 1, 'not': 1}
函数式版本把"累积"换成"映射加折叠",全程没有一条赋值:
import qualified Data.Map as Map import Data.Char (toLower, isAlpha) wordCount :: String -> Map.Map String Int wordCount = foldr (Map.insertWith (+) <*> id) Map.empty . map (map toLower . filter isAlpha) . words main :: IO () main = print (wordCount "to be or not to be") -- 输出:fromList [("be",2),("not",1),("or",1),("to",2)]
两段代码行为一致,但组织方式不同:命令式版本的时间轴是"逐词处理、字典渐长",你要在脑内模拟循环每一轮的状态;函数式版本是一个固定的变换管道——分词、归一化、折叠——每一级都是独立可测的纯函数。现在先不必深究 foldr 与 insertWith 的细节(第 3 章会亲手实现它们),这里只需要获得一个体感:函数式代码的形状,就是数据流动的形状。
变式练习:把命令式版本改成线程安全(加一把锁),再把函数式版本并行化(分片统计再合并两个 Map)。你会发现前者的正确性论证需要写满半页纸,后者只需要一句话——"分片之间无共享状态"。这个体感,就是第 6 章并发主题的预告。
常见误读澄清
误读一:"函数式语言没有状态。"错。函数式程序一样有"状态"概念,区别在于状态变化被建模为"一系列不可变快照的序列",而不是"一块被反复涂改的内存"。误读二:"函数式是 Haskell 专属。"λ演算属于所有语言,Java 的 Stream、Python 的推导式、JavaScript 的数组方法都是它的远房子孙。误读三:"学函数式必须先学范畴论。"历史顺序恰好相反——先有工程实践,后有理论总结,本教程也按这个顺序走。
本节要点回顾
- λ演算先于计算机存在:函数式编程的地基是可计算性理论,"计算即表达式化简"是它的原始定义。
- 沉寂期不是死亡期:GC、闭包、泛型持续向主流语言输血,函数式思想从未离开工业现场。
- 多核危机是复兴的引爆点:共享可变状态在并行环境下的代价,把不可变性和纯函数推回舞台中央。
- 每个特性都有历史针对的"敌情":学特性先问它防什么 bug,理解成本立刻减半。
- 范式对比的落点是代码形状:命令式代码的时间轴是状态演化,函数式代码的形状是数据流经的管道。
下一节我们把"纯"这个被用滥的词钉死成可操作的工程定义——为什么一个函数不改入参、不碰全局还不够纯,引用透明又在其中扮演什么角色。