3.1 三大件手写实现:map、filter、reduce 到底是什么
3.1 三大件手写实现:map、filter、reduce 到底是什么
本节摘要:map、filter、reduce 是函数式编程使用频率最高的三个高阶函数,但多数人只会调用不会构造。本节用 Python 与 Haskell 双语从零实现三大件,给出各自的类型签名与不变式,建立"看循环识意图"的判别法,并说明三大件组合如何覆盖绝大多数循环场景。
为什么要亲手造一遍轮子
调用内建的 map 与 filter 毫无难度,难的是回答两个追问:第一,它们与普通循环的边界在哪里——哪些循环能用三大件改写,哪些不能?第二,它们凭什么成为函数式的"通用货币",从 Haskell 到 Java Stream 到 SQL 都长着同一副面孔?这两个问题,只有亲手实现一遍、亲手违反一遍它的约定,才能真正回答。造轮子在这里不是练习题,是理解抽象边界的最短路径。
一、map:逐元素变换的形状保持
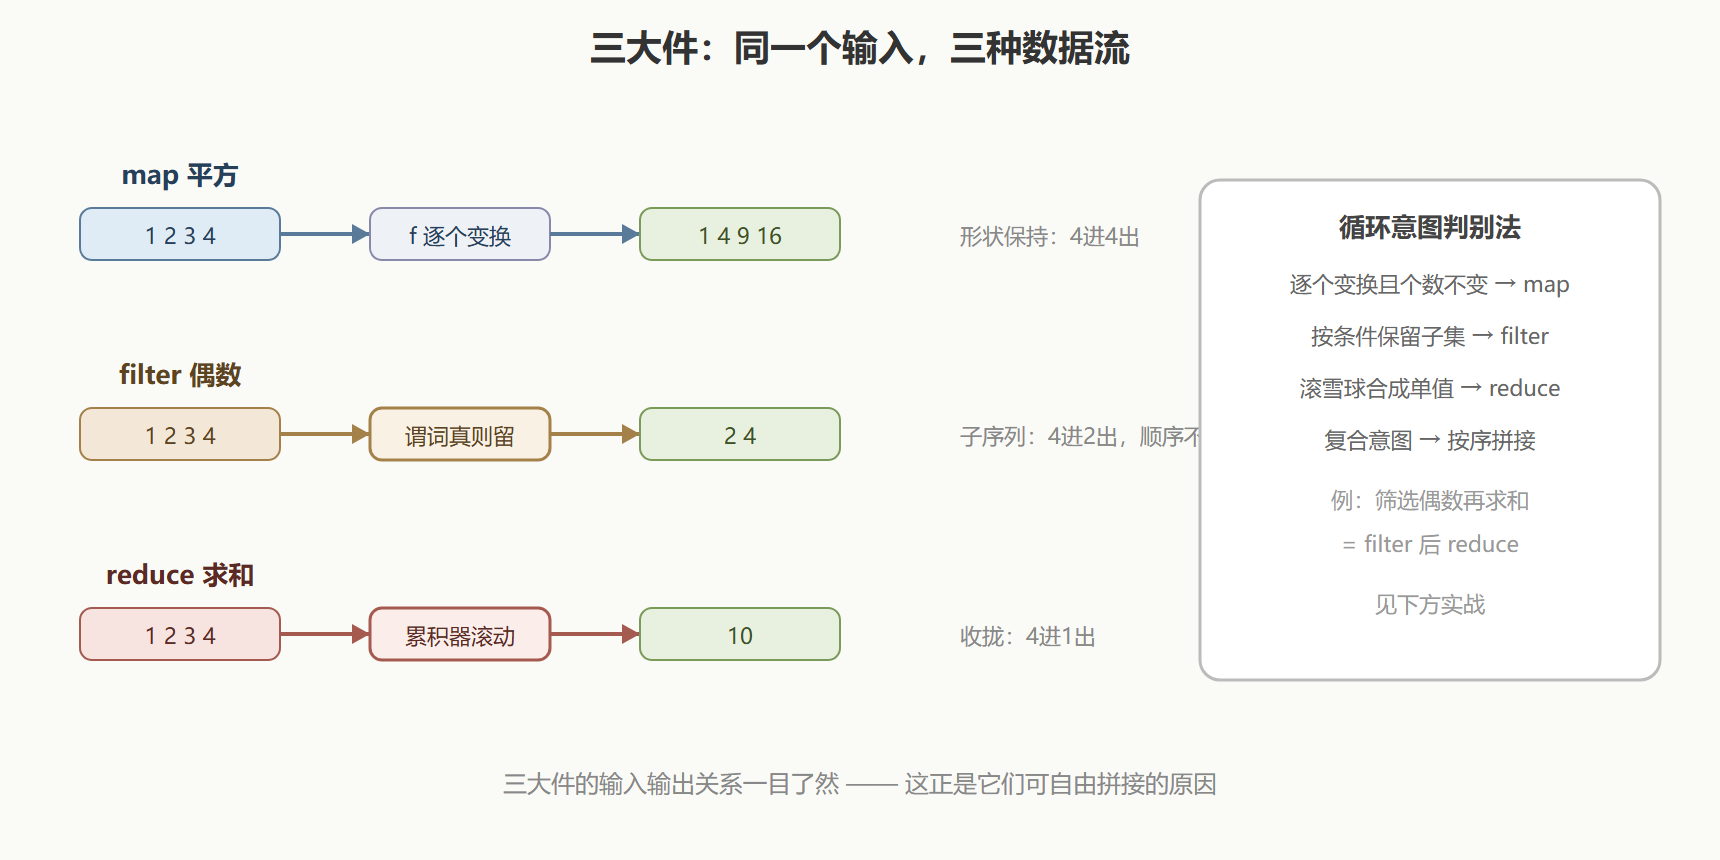
map 的事一句话可以说尽:对容器里的每个元素施加同一个函数,得到一个同形状的新容器。输入 n 个元素,输出 n 个元素,位置一一对应——"形状保持"是它最重要的不变式。
先写最朴素的实现,再给出 Haskell 里的标准定义:
# Python 手写实现:只依赖最基础的语法 def my_map(fn, items): result = [] for x in items: result.append(fn(x)) return result print(my_map(lambda s: s.upper(), ["ab", "cd"])) # ['AB', 'CD'] —— 逐个变换,个数不变
-- Haskell 手写实现:递归定义,模式匹配 myMap :: (a -> b) -> [a] -> [b] myMap _ [] = [] -- 空表映射为空表 myMap f (x:xs) = f x : myMap f xs -- 头部变换,尾部递归处理 -- 标准库里 map 就是这个定义,一行不多
两个版本描述的是同一个数学对象:(a -> b) -> [a] -> [b]——接收一个"从 a 到 b 的函数"和一个 a 的列表,产出 b 的列表。这个签名里没有任何具体业务,所以它能装下"给每个元素求平方""把每个名字转大写""把每个 JSON 串解析成对象"等无穷多件事。通用性不是靠 if-else 堆出来的,是靠类型签名里留出来的洞(类型变量)让出来的——这个观察在第 4 章会被推向极致。
二、filter:按谓词筛子的个数变化
filter 的契约:对每个元素施加一个返回真假的谓词函数,保留判定为真的元素。与 map 不同,filter 不保持元素个数——只保证"输出是输入的子序列,相对顺序不变"。
# Python 手写实现 def my_filter(pred, items): result = [] for x in items: if pred(x): result.append(x) return result nums = [3, 8, 1, 6, 9, 2] print(my_filter(lambda n: n % 2 == 0, nums)) # [8, 6, 2] —— 只留偶数,顺序不变
判别时最常见的问题是"谓词有副作用怎么办"。答案很直接:带副作用的谓词让 filter 的行为依赖执行细节(短路实现与全量实现结果不同),违背引用透明,属于自找麻烦。规范是——谓词必须是纯函数。第 2 章的纯度判据在这里直接落地成 API 约定。
三、reduce:把序列收拢成一个值
reduce(Haskell 里叫 fold)是三大件里最抽象、也最强大的一个:持一个累积器从左到右扫过序列,每步用二元函数更新累积器,序列扫完,累积器就是结果。map 和 filter 其实都能用 reduce 表达——聚合与变换在"逐步更新累积器"的框架下统一了。
# Python 手写实现:带初始值版本 def my_reduce(fn, items, init): acc = init for x in items: acc = fn(acc, x) return acc nums = [1, 2, 3, 4] print(my_reduce(lambda acc, x: acc + x, nums, 0)) # 求和:10 print(my_reduce(lambda acc, x: acc * x, nums, 1)) # 求积:24 print(my_reduce(lambda acc, x: max(acc, x), nums, float("-inf"))) # 最大值:4 # 用 reduce 表达 map 与 filter —— 三大件归一 def my_map_via_reduce(fn, items): return my_reduce(lambda acc, x: acc + [fn(x)], items, []) def my_filter_via_reduce(pred, items): return my_reduce(lambda acc, x: acc + [x] if pred(x) else acc, items, []) print(my_map_via_reduce(lambda n: n * 10, nums)) # [10, 20, 30, 40] print(my_filter_via_reduce(lambda n: n % 2 == 0, nums)) # [2, 4]
Haskell 侧给出 foldr 的定义,并展示它如何"天生"定义出列表的其他操作——这是 reduce 地位的最好注脚:
myFoldr :: (a -> b -> b) -> b -> [a] -> b myFoldr _ z [] = z myFoldr f z (x:xs) = f x (myFoldr f z xs) -- 用 foldr 定义 map:变换函数被"塞进"列表的构造过程 myMapViaFoldr :: (a -> b) -> [a] -> [b] myMapViaFoldr f = myFoldr (\x acc -> f x : acc) [] -- 用 foldr 定义 filter myFilterViaFoldr :: (a -> Bool) -> [a] -> [a] myFilterViaFoldr p = myFoldr (\x acc -> if p x then x : acc else acc) [] main = print (myMapViaFoldr (* 10) [1, 2, 3, 4]) -- [10,20,30,40]
foldr 能定义 map、filter、length、append……这意味着 fold 不是与 map 并列的一个操作,而是列表这一结构的"通用消解器":任何"把列表变成单个东西"的计算,原则上都是某种 fold。第 3.3 节会把这个观点展开成递归与折叠的互译公式。
图:三大件的数据流与形状变化
四、实战:一个循环的三种意图
用一段真实风格的业务代码演示"看循环识意图"。需求:从订单列表里找出金额超过一百的已完成订单,算总金额。命令式写法把三种意图揉在一个循环里:
total = 0.0 # 累积器(意图三:聚合) for order in orders: if order.status != "paid": # 意图二:筛选 continue if order.amount <= 100: continue total += order.amount # 意图三:聚合
读懂它需要人肉模拟循环执行。三大件把意图拆开、按数据流顺序排布:
total = reduce( lambda acc, o: acc + o.amount, # 聚合 filter(lambda o: o.status == "paid" and o.amount > 100, orders), 0.0, )
或者用 Python 的推导式风格(本质同样是过滤加映射的语法糖):
total = sum(o.amount for o in orders if o.status == "paid" and o.amount > 100)
三种写法结果一致,但可读性分层明显:揉合版要读者执行代码才能确认意图;三大件版是"名词加动词"的声明——筛选已支付大额订单,求和金额。代码从"怎么算的剧本"变成了"是什么的陈述",这正是第 1 章说的范式转换在微观代码上的样子。变式练习:给上面的需求加一个"订单去重后再聚合"的意图,分别改揉合版与管道版,体会哪一边的改动是局部的。
💡 关键直觉:遇到超过十行的循环先别急着读懂它,先数它含几种意图。三种意图以内的循环几乎总能被三大件管道替换,替换后测试点从"循环路径覆盖"变成"每个环节的输入输出",用例数量立减。
本节要点回顾
- map 形状保持:n 进 n 出,逐元素变换;类型签名
(a -> b) -> [a] -> [b]中的类型变量是通用性的来源。 - filter 输出子序列:谓词必须是纯函数,否则短路实现与全量实现行为不一致。
- reduce 是通用消解器:map 与 filter 都能用 reduce 表达,任何"列表变单值"都是某种折叠。
- 看循环识意图:变换、筛选、聚合三种意图的排列组合覆盖绝大多数循环,拆开即得管道。
- 声明式读法:三大件把代码从执行剧本变成数据流陈述,评审与测试的成本同步下降。
三大件解决了"用现成的高阶函数",下一节解决"自己造高阶积木":柯里化如何拆装参数、组合子如何把函数焊成管道。