3.3 递归、尾递归与折叠:从栈帧到 fold
3.3 递归、尾递归与折叠:从栈帧到 fold
本节摘要:没有循环语句的函数式语言里,递归就是循环;而尾递归与折叠是保证递归不爆栈的两大工程手段。本节先拆解普通递归的栈帧堆积过程,再讲清尾递归为何能被优化成循环,最后给出"递归与 fold 互译"的机械公式,并用互译公式改写两个真实算法。读完你应当能在"会不会爆栈"这个问题上,对任意一段递归给出有依据的判断。
从一个算错的阶乘说起
递归是多数工程师的老熟人,但"栈会不会爆"通常靠模糊的直觉。先看一对对比实验(Python 会真实爆栈,适合当教具):
import sys def fact(n): if n <= 1: return 1 return n * fact(n - 1) # 普通递归:乘法在递归返回之后 def fact_tail(n, acc=1): if n <= 1: return acc return fact_tail(n - 1, acc * n) # 尾递归:递归调用是最后一步 print(fact(10)) # 3628800,一切正常 print(fact_tail(10)) # 3628800,结果一致 sys.setrecursionlimit(100000) print(fact_tail(50000)) # 看你的运行环境:CPython 不做尾调用优化,仍会爆栈
最后一行暴露了本节的核心事实:"写成尾递归"与"被优化成循环"是两件事。尾递归是代码形态(递归调用是函数的最后一个动作,返回后无需任何后续计算),尾调用优化是运行时能力(把尾调用复用当前栈帧,等效于跳转)。OCaml、Scheme、Haskell(GHC 对自递归函数)具备优化;CPython、JVM 老版本没有。代码要写成尾递归形态(这是可移植的好习惯),但爆不爆栈由运行时说了算——工程判断必须区分这两层。
一、栈帧视图:普通递归为什么会堆积
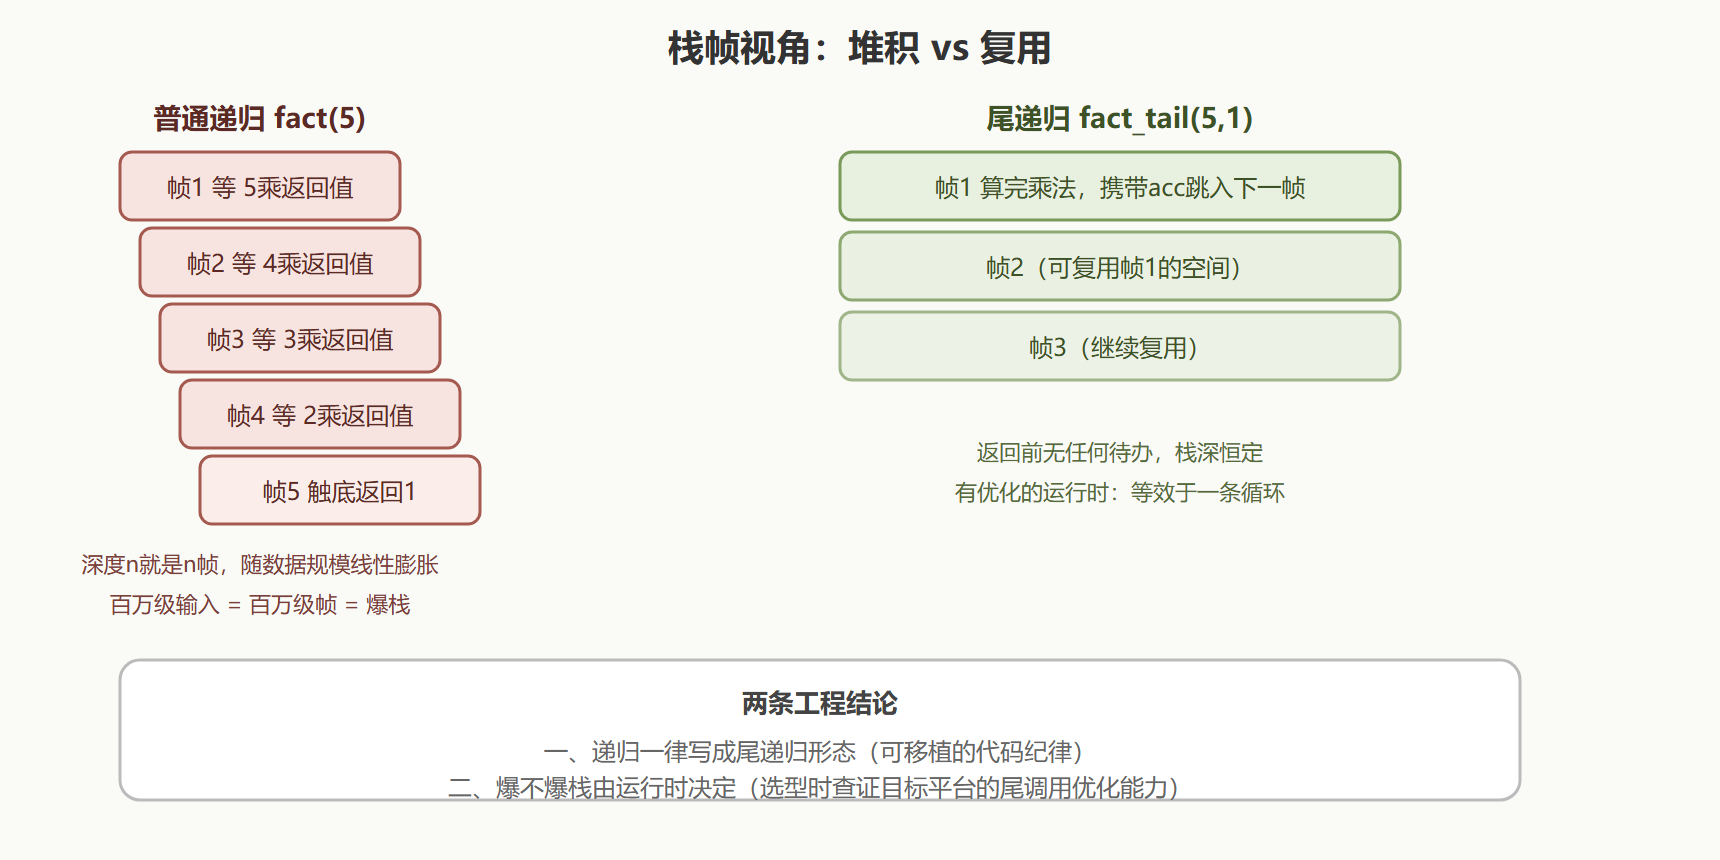
把 fact(5) 的求值过程画成栈帧时间线,堆积的机制一目了然:
fact(5) = 5 * fact(4) ← 第1帧挂起,等待 fact(4) 的值 = 4 * fact(3) ← 第2帧挂起 = 3 * fact(2) ← 第3帧挂起 = 2 * fact(1) = 1 ← 触底 ← 2*1=2 ← 逐层回卷,乘法此刻才发生 ← 3*2=6 ← 4*6=24 ← 5*24=120
五层挂起帧,每层都记住"等会儿要拿返回值乘上几"。递归深度 n,栈空间就是 n 帧的量级——百万级数据直接爆栈。而尾递归版本把"乘"这个动作提前塞进了参数 acc:每一帧返回前不再有任何待办,理论上当前帧可被下一帧复用。对比时间线:
fact_tail(5, 1) → fact_tail(4, 5) ← 乘法已在本帧完成,直接进入下一帧 → fact_tail(3, 20) → fact_tail(2, 60) → fact_tail(1, 120) → 120 ← 无回卷,无挂起
图:普通递归的栈堆积与尾递归的帧复用
二、折叠:递归的成品形态
把尾递归模式再抽象一步就得到 fold:累积器、终止条件、逐元素推进——三大要素与尾递归一一对应。fold 就是"递归遍历列表"这件事的成品封装:写尾递归是在手工组装 fold 的内部零件,写 fold 是直接调用成品。既然 3.1 节已经证明 map、filter 都能用 fold 定义,那么一个推论成立:纯函数式语言里的一切列表循环,最终都归结为 fold 的某种特化。
Haskell 侧用严格 fold 实现"统计及格率"与"分组计数"两个真实聚合:
import qualified Data.Map as Map import Data.List (foldl') -- 聚合一:及格率。累加器是元组(过,总),扫完一算 passRate :: [Int] -> Double passRate scores = let (passed, total) = foldl' step (0, 0) scores step (p, t) s = (if s >= 60 then p + 1 else p, t + 1) in fromIntegral passed / fromIntegral total -- 聚合二:按首字母分组计数 groupCount :: [String] -> Map.Map Char Int groupCount = foldl' step Map.empty where step acc s = Map.insertWith (+) (head s) 1 acc main = do print (passRate [85, 42, 60, 91, 58]) -- 0.6 print (groupCount ["apple", "avocado", "banana"]) -- fromList [('a',2),('b',1)]
注意 foldl'(严格版)登场了——第 2.3 节的空间泄漏军规在这里兑现:累加器每轮强制求值,这是数据聚合的默认选择。
三、互译公式:递归与 fold 的机械转换
给一套可背的转换公式,任何"结构良好的列表递归"都能双向互译。
递归转 fold 三步:识别终止时返回的常量(fold 的初始值);识别"头部元素与递归结果如何合成"(fold 的二元函数);剩余全是机械翻译。示范,求列表最大值:
-- 递归原始版 myMax1 :: [Int] -> Maybe Int myMax1 [] = Nothing myMax1 [x] = Just x myMax1 (x:xs) = Just (max x (unwrap (myMax1 xs))) where unwrap (Just v) = v -- 互译三步:终止常量是"空表无最大值",合成规则是 max, -- 把"从空表开始"改为 Maybe 包裹初值: myMax2 :: [Int] -> Maybe Int myMax2 = foldl' step Nothing where step Nothing x = Just x step (Just acc) x = Just (max acc x) main = print (myMax2 [3, 9, 2]) -- Just 9
fold 转递归反向同理:fold 的初始值是递归的终止返回,二元函数展开成"头部处理加尾部递归"。互译的价值不在炫技,而在审阅:拿到一段看不懂的递归,翻成 fold 后意图(初始值、合成规则)直接显形;拿到一段过深的 fold 链,翻回递归可以看出哪里能合并。变式练习:把二分查找的递归实现翻成"fold 形态"(提示:fold 遍历的"列表"是砍半路径上的中点序列),体会互译对非列表结构同样可用、但可读性有边界——树形递归与回溯类算法不适合强行 fold 化,互译公式只对线性结构机械有效。
四、工程实践:尾递归与 fold 的选型与陷阱
三条实战准则。其一,性能关键路径选 fold 加严格累加器:语言内建的 fold 经历过优化(融合、展开),手写尾递归很难打赢,且 fold 的意图更可读。其二,树形与互递归结构保持普通递归,深度可控(树高)时无须尾递归化,强行改造反而引入显式栈,丢掉递归的表达力。其三,警惕"假尾递归":递归调用后面还跟着一次计算的都不是尾递归,常见的伪装是 1 + fact(n-1)(加法在递归之后)与模式匹配后再计算的类型构造。判别口诀一句话:把递归调用那行删掉,剩下的函数体若无任何未完成的计算,才是真尾递归。
⚠️ 常见坑:JVM 平台的 Scala 标注
@tailrec可让编译器在无法尾调用优化时直接报错,是防"假尾递归"混入生产的好工具; Clojure 则提供loop/recur语法强制尾位递归。选型时把目标平台的等价机制查清楚,再决定递归深度预算。
本节要点回顾
- 递归即循环:无循环语句的函数式语言以递归表达重复,栈安全是第一工程约束。
- 尾递归形态与运行时优化是两回事:代码纪律要求尾位调用,平台能力决定是否真的省栈。
- fold 是递归的成品封装:累积器、终止、推进三要素对应,列表循环最终归结为 fold 特化。
- 互译公式可背可用:终止常量对初始值、合成规则对二元函数;线性结构机械有效,树形不强求。
- 性能路径默认 fold 加严格累加器:
foldl'一类严格折叠是第 2 章军规的落地形态。
线性世界的工具集齐了。下一节把本章全部技术投入一场实战:一次真实的纯函数重构,从提纯、拆意图、组管道到收边界的完整过程。