5.1 Haskell 纯函数世界:与编译器共事的一天
5.1 Haskell 纯函数世界:与编译器共事的一天
本节摘要:Haskell 是默认纯、默认惰性的函数式"普通话",也是把第 4 章类型系统发挥到极致的语言。本节跟着一个真实小任务——"从请求日志统计各接口的失败率并输出报表"——走完 Haskell 工程的一天:类型先行、 REPL 试算、编译器挑错、重构收尾。读完你会对"写 Haskell 是什么体验"有一手体感,而不是二手传说。
先澄清两件被传歪的事
动手前清两块路障。传说一:"Haskell 优雅但做不了实事。"事实是:它有成熟包仓库、有大型金融系统与编译器项目的生产记录;真实短板在别处——招聘池小、生态垂直领域覆盖薄、团队维持成本高。传说二:"Haskell 学了用不上,白学。"这句把"用"理解窄了:Haskell 的类型思维、Monad 直觉、纯度纪律会迁移——大量 Rust、Scala、TypeScript 的资深工程师反馈,这些语言的难点在 Haskell 语境里是常识。本节带你走的一天,目标不是速成 Haskell,是校准你对这门语言的一手预期。
一、开工:类型先行
Haskell 工程的典型起点不是写实现,是写类型。任务拆成三段:解析日志行、聚合统计、渲染报表。类型设计先行:
{-# LANGUAGE OverloadedStrings #-} module Report where import qualified Data.Map as Map import Data.Text (Text) -- 数据形态:第4章的代数数据类型直接上岗 data Entry = Entry { path :: Text , ok :: Bool } deriving (Show, Eq) -- 三段管道的类型规格:先签字后施工 parseLine :: Text -> Maybe Entry -- 解析可能失败 aggregate :: [Entry] -> Map.Map Text (Int, Int) -- 按路径累计 总数与失败数 render :: Map.Map Text (Int, Int) -> [Text] -- 渲染成报表行 -- 主管道:类型一拼,程序骨架已现 report :: [Text] -> [Text] report = render . aggregate . foldr step [] . mapMaybe parseLine where step e acc = e : acc
看这段签名,不写一行实现,能读出的信息已经很多:解析可能失败(Maybe)、失败行会被丢弃(mapMaybe)、聚合的键是路径值是二元计数、最终产物是文本行。类型签名是团队沟通的界面——评审签名十分钟,胜过评审实现两小时。这是 Haskell 日常体验的第一支柱。
二、REPL:边写边算的工作台
第二支柱是交互环境。在 REPL 里逐段验证,像在实验台上试试剂:
ghci> :load Report ghci> let line = "GET /api/orders 500" ghci> parseLine line Just (Entry {path = "/api/orders", ok = False}) ghci> let entries = [Entry "/a" True, Entry "/a" False, Entry "/b" True] ghci> aggregate entries fromList [("/a",(2,1)),("/b",(1,0))] ghci> render (aggregate entries) ["/a 总数2 失败1", "/b 总数1 失败0"]
每一段逻辑独立试算通过,主管道基本一次拼成。与"写完一整个文件再跑"的循环相比,REPL 把反馈周期压到秒级——这份流畅感是多数静态语言环境的短板,也是 Haskell 开发效率传说的一半真相(另一半是编译期等待)。
现在补上实现。聚合用第 3.3 节的严格折叠,渲染用纯函数拼串:
aggregate :: [Entry] -> Map.Map Text (Int, Int) aggregate = foldl' step Map.empty where step acc (Entry p ok) = let (total, fail) = Map.findWithDefault (0, 0) p acc in Map.insert p (if ok then (total + 1, fail) else (total + 1, fail + 1)) acc render :: Map.Map Text (Int, Int) -> [Text] render = map line . Map.toList where line (p, (total, fail)) = p <> " 总数" <> tshow total <> " 失败" <> tshow fail tshow = Text.pack . show
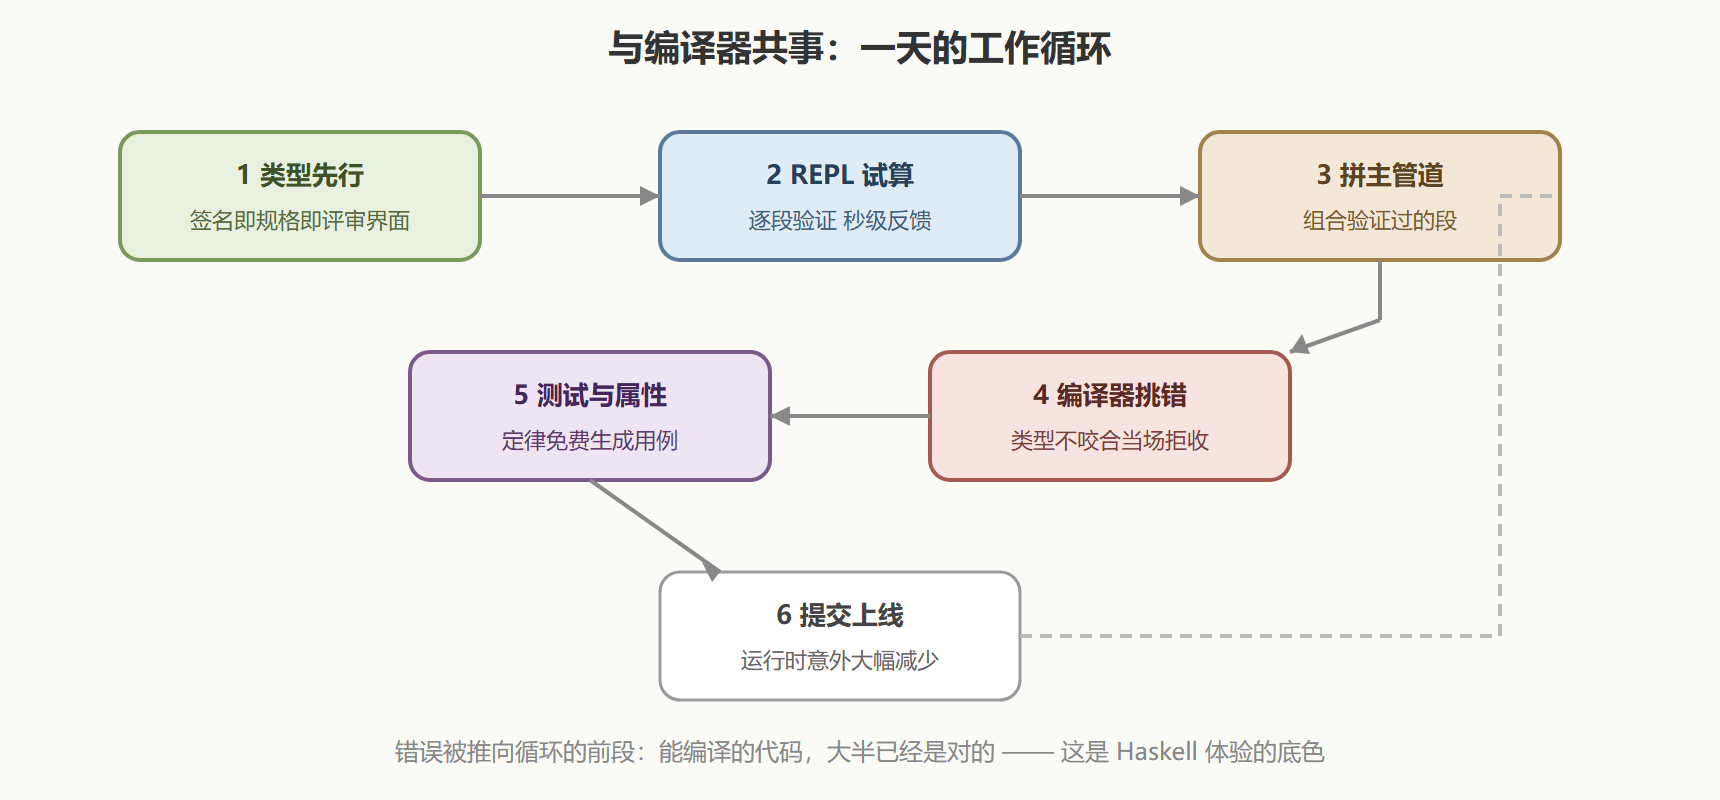
图:Haskell 工程一天的反馈循环
三、编译器:最严的同事,最快的成长
第三支柱是把编译器当同事。它拒收代码的理由常让初学者抓狂,但每一条都在替你省一次线上事故。三个高频互动场景:
-- 场景一:分支漏了。编译器直接点名缺哪个构造器 handle :: Either String Int -> String handle (Right n) = "结果:" ++ show n -- 编译错误:Pattern match(es) are non-exhaustive -- In a case alternative: Patterns of type 'Either String Int' not matched: Left _ -- 场景二:纯度越界。在纯函数里想打印?类型系统不放行 pureCalc :: Int -> Int pureCalc x = x * 2 -- pureCalc x = print x >> (x * 2) -- 编译不过:IO 不允许混入纯签名 -- 场景三:改形态自动点名。给 Entry 加字段后编译, -- 所有消费 Entry 的模式匹配位置被逐一列出,一个不漏
工程上的真实感受是两面的:新手期编译通过率低,节奏被编译器打断,这是"Haskell 难"的真实来源;熟手期的体验则是编译通过即大半正确——运行时异常类型从"日常"降为"罕见",调试重心从"哪里崩了"转移到"逻辑对不对"。这正是第 2 章副作用管制与第 4 章类型围栏叠加后的复利。
四、诚实的边界:什么时候别选它
把选型反例说透才公平。团队一人扛全栈的小项目,Haskell 的编译期投资回收慢,不如 TS/Python 快出活;重度依赖某个垂直生态(某云厂商 SDK、某国产中间件客户端)时,检查该生态有无维护中的绑定,没有就是一票否决;团队两周内要交付且无人有函数式语言经验,此时引入是给交付上难度。Haskell 的甜区:规则密集、正确性敏感、长期演化的核心域——计价引擎、编译器、协议实现。与第 1.3 节的场景矩阵对照着用,结论是收敛的。
💡 关键直觉:Haskell 的价值排序里,"编译器协作体验"高于"语法优雅"。学它最大的收获不是会写
>>=,而是养成了"先想类型、先分纯杂、再写实现"的习惯——这个习惯在下一节的三种方言、以及第 5.3 节的主流语言里,都会持续生息。
本节要点回顾
- 类型先行是工作方式而非仪式:签名即规格、即评审界面、即文档。
- REPL 把反馈压到秒级:逐段试算再拼管道,一次性写对成为常态。
- 编译器是最严的同事:穷尽性、纯度、形态变更三点名,运行时意外被前置消化。
- 难与快的真相:新手期被编译打断是"难"的来源;编译通过即大半正确是"快"的来源。
- 甜区在核心域:规则密集、正确性敏感、长期演化的模块才配得上这套投资。
普通话体验完毕。下一节拉来三种性格迥异的方言做同一道题——类型严谨度坐标上,它们各站一格,你会看清函数式的光谱远比"Haskell 或不是 Haskell"宽。