6.3 性能账本:函数式的成本与收益逐条核算
6.3 性能账本:函数式的成本与收益逐条核算
本节摘要:"函数式慢不慢"是个坏问题,"哪些条目亏、哪些条目赚、我的场景总账如何"才是好问题。本节把性能账本摊开:成本侧三项(分配与拷贝、抽象间接、惰性驻留),收益侧四项(缓存自由、并行自由、跳过未用计算、消除重复计算),每条给出机理、量级感与工程对策,最后汇总成一份四步性能预案。读完你应当能对任何一段函数式代码给出有依据的性能预判,而不是人云亦云。
成本侧第一条:分配与拷贝——不可变的直接账单
不可变纪律的直接后果:每次"修改"都是构造新对象。直觉上的恐慌("那性能不崩了")与真实情况之间隔着一层技术:持久化数据结构的结构共享。以 Clojure 的向量为例——它用树状结构存储,"修改"只复制从根到目标节点的一条路径(对百万级元素,复制量约十几个节点),其余全部共享:
(def v (vec (range 1000000))) ;; 百万元素向量 (def v2 (assoc v 999999 :end)) ;; "修改"最后一个元素 ;; 复制的只是一条路径上的十几个节点,不是一百万元素 ;; 与原向量共享的部分占绝对多数
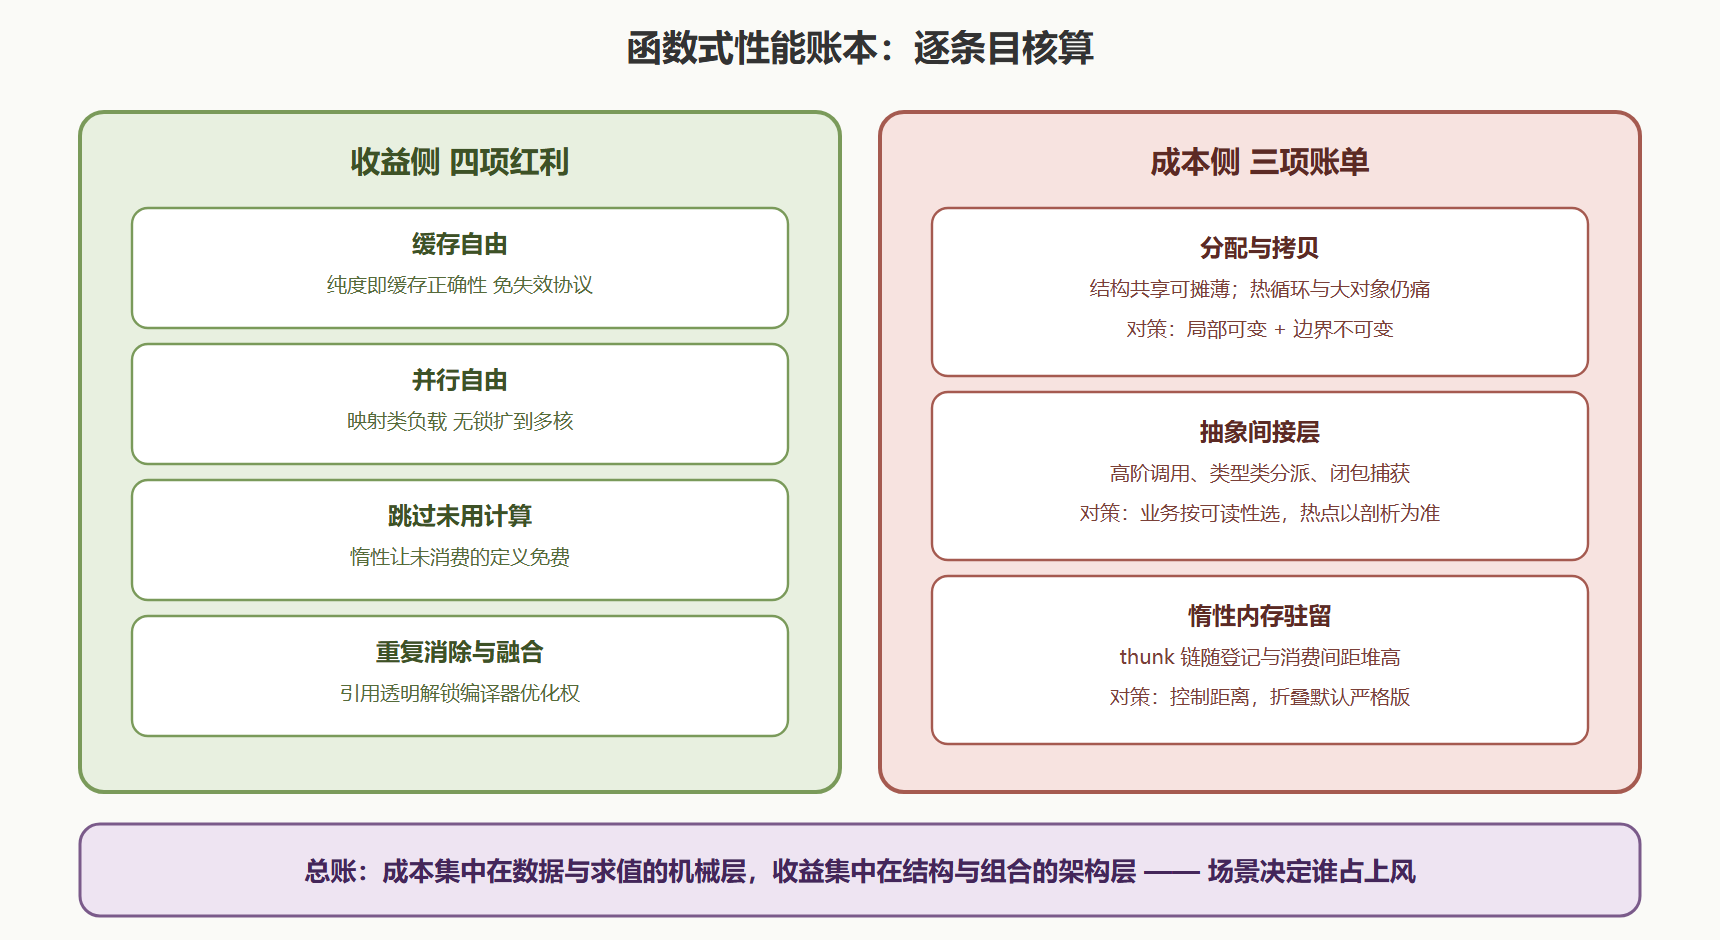
量级感:结构共享让不可变更新的成本从"正比于数据量"降到"正比于结构深度",多数场景每步更新的常数略高于原地修改(大约数倍以内),但远不是灾难。真正的账单在三类场景出现:数组式热循环(每帧游戏循环里每像素构造新对象,分配压力压垮 GC)、超长序列的逐元素拼接(列表加法逐次复制头部)、没有结构共享的语言(JavaScript 的对象展开符是真拷贝,深层大对象每改一次复制一层)。对策依次是:局部可变加边界不可变(Haskell 的 ST 单子、Clojure 的 transient)、换数据结构(vector 而非 list)、上不可变结构库。
成本侧第二条:抽象的间接层
高阶函数与多态抽象的调用比直接循环多几层间接:函数作为值传递(可能 boxing)、类型类分派(查字典)、闭包捕获(堆分配环境)。在多数业务代码里这些开销不进热点(被 IO 与网络掩盖);在紧循环里会显形。好消息是编译器一直在追平:GHC 的融合(fusion)把 map 套 map 的中间列表整个消掉、JIT 对单态化调用点的内联、Stream API 在热路径与循环生成的差距逐年缩小。诚实的建议:业务代码按可读性选,热点代码以剖析为准——第 2 章说过,时序确定性是严格求值的长项,剖析友好度同理。
成本侧第三条:惰性的内存驻留
第 2.3 节整节都在讲这条,此处只补一笔总账视角:惰性求值的内存成本不是常数,而是与"登记与消费的间距"成正比。间距短(产即消费),thunk 几乎即时化简,成本可忽略;间距长(先登记一批再统一消费),thunk 链堆高,就是空间泄漏。所以惰性的性能军规只有一条:控制登记与消费的距离——生产管道逐段消费,别攒大招。
收益侧:四项别人拿不走的红利
红利一:缓存自由。 纯函数的返回值只由输入决定,缓存不需要失效协议——输入不变,缓存永真。记忆化因此成为函数式的招牌优化,几行实现:
from functools import lru_cache @lru_cache(maxsize=None) # 一个装饰器:以参数为键的自动缓存 def fib(n): if n < 2: return n return fib(n - 1) + fib(n - 2) print(fib(200)) # 瞬时完成——无缓存版需要宇宙级时间
命令式函数不敢这么缓存:若函数体里读全局状态,缓存的正确性取决于"全局状态何时变",失效逻辑要手工维护且极易错。纯度是缓存正确性的免费证明。
红利二:并行自由。 第 6.1 节的 parMap 已演示:无共享写,分片即并行,无需锁与手工切分。对映射类负载,扩容方式从"加锁调优"变成"加核"。
红利三:跳过未用计算。 惰性让"算了但没人用"的成本趋零。一个典型场景:配置对象按需构建,只解压用到的字段;报表只算被引用的指标。严格求值语言要显式 if 守卫,惰性语言里"定义了但没用"天然免费。
红利四:编译器替你消除重复。 引用透明让公共子表达式消除、重排、内联全部合法(第 1.2 节的合同条款)。GHC 融合消除中间结构是这项红利的极致形态——map f . map g 被编译成一次遍历,中间列表根本不存在。
图:性能账本总览——四收益对三成本
四步性能预案:把账本变成动作
给一段新接手的函数式代码,预案按序执行。第一步,量与猜分离:先剖析(严格语言剖析图直读,惰性语言用堆剖析看 thunk 占比),禁止凭直觉开改——第 2.3 节的事故复盘证明,真凶常不在嫌疑最大的位置。第二步,查三类惯犯:折叠是否严格版、登记与消费的距离是否过长、热路径是否有无结构共享的拷贝——这三处覆盖惰性语言九成性能事故。第三步,收益侧找免费午餐:调用密集的纯函数加记忆化;映射类批处理换并行版;确认编译优化开启(融合、单态化)。第四步,降档或局部可变:抽象降档(Monad 换应用函子、流换循环)与"局部可变加边界不可变"是两张底牌——它们不丢架构纯度,因为突变被封在单函数边界内,签名与语义仍纯。
一个综合判例
用一个真实场景走完预案。报表服务聚合千万行日志,首版用不可变列表折叠,耗时四十秒、峰值内存两G。剖析定位:列表的 O(n) 拼接(成本一)加 thunk 链(成本三)。对策:数据结构换 Data.Map 的严格版折叠(军规二),管道改分块流式(控制距离),核心聚合加并行分片(红利二)。终版:三秒、峰值三百兆。判例的启示不在数字,在路径——三项对策全部来自本节账本的既有条目,没有一个靠灵感。性能工作在函数式世界里是一门"对账"手艺,不是玄学。
💡 关键直觉:函数式的性能叙事常被讲成"以空间换时间"或"以时间换优雅",都是错的。真实叙事是把优化从手工移交给机制:缓存交给纯度、并行交给引用透明、消除交给编译器。机制覆盖到的场景赚,覆盖不到的(热循环分配、惰性驻留)按条目对症下药——账本在手,就不用赌。
性能工作里的三个反直觉
账本之外,三个反直觉的经验值得单独记录,它们在性能排查中反复被验证。反直觉一:抽象层数与慢没有必然关系。大量"函数式很慢"的案例,剖析后真凶是数据结构选错(该用映射的查找写成了列表扫描)或算法复杂度问题——换成等价的命令式实现一样慢。先查算法与数据结构,再怀疑范式,这个顺序不能反。反直觉二:更少的代码不等于更少的分配。一行链式调用可能构造七八个中间对象,一段朴素的命令式循环反而零分配;分配次数要看剖析器,不能看代码行数。反直觉三:并行的开销先于收益出现。任务粒度小于调度成本时,并行版本比串行更慢——纯函数给了并行许可,没给"任何粒度都该并行"的许可,粒度决策仍需实测。
这三条合起来指向同一个工作方法:性能结论必须来自剖析与基准,不来自范式立场。函数式与命令式队伍都存在"为信仰做性能判断"的倾向,账本思维的作用正是把判断拉回证据这一侧。
本节要点回顾
- 结构共享摊薄拷贝:持久化数据结构让"修改"成本正比于深度而非数据量,恐慌多来自不知此项技术。
- 间接层开销看场景:业务代码被 IO 掩盖,热循环才显形;剖析是唯一裁判。
- 惰性成本正比于登记与消费的距离:军规只有一条,控制距离。
- 四项红利都是机制化的优化:纯度买缓存与并行,惰性买跳过,引用透明买编译器消除。
- 四步预案可复用:量猜分离、查三类惯犯、收免费午餐、降档与局部可变两张底牌。
账本合上,性能疑虑清零。下一章把散落全书的工程手段收拢成体系:测试怎么吃纯度红利、排错怎么用引用透明、迁移与团队约定如何落地——函数式的最后一块拼图是工程实践。