7.1 测试红利:表驱动用例与属性测试
7.1 测试红利:表驱动用例与属性测试
本节摘要:纯函数把"搭建测试环境"这个测试工程最大的成本项直接清零——没有数据库要起、没有时钟要 mock、没有顺序要维护。本节在此基础上介绍两种被纯度放大的测试技法:表驱动用例(输入输出一览无余)与属性测试(机器自动生成你没想到的用例),并给出函数式变体的测试金字塔。读完你应当能按"表驱动打底、属性补盲区、IO 层薄端到端"的配比重构测试策略。
从一笔测试成本账说起
传统单元测试的真实成本大头不在写断言,在搭环境:起容器、建内存库、mock 时钟、清理上一条用例的残留。第 2.1 节把副作用剥进外壳后,这套成本瞬间蒸发——纯函数的测试就是"调用加断言",任何测试框架都行,没有框架也行。但很多团队拿到这份红利后止步于此,用写命令式测试的旧习惯测纯函数:一个用例一个函数,每个函数三行断言,两百个用例写成两百个样板。本节要做的就是把测试姿势也换掉。
一、表驱动用例:把用例压成数据
表驱动的思想:用例的本质是"输入到期望输出"的映射,那就直接写成映射,循环执行断言:
import pytest def parse_duration(text): """'90m' -> 90, '1h30m' -> 90, '2h' -> 120,非法返回 None""" ... @pytest.mark.parametrize("text,expected", [ ("90m", 90), ("1h30m", 90), ("2h", 120), ("0m", 0), ("1h", 60), ("", None), ("abc", None), ("5x", None), ("-3m", None), # 边界:负数 ("1h200m", 200), # 边界:进位 ]) def test_parse_duration(text, expected): assert parse_duration(text) == expected
十组用例一屏读完,覆盖了等价类(合法格式三种)、边界(零、负、进位)与非法输入。表驱动对评审的改变尤其大:新同事 review 时一眼看穿"测了什么、漏了什么"——表格里缺哪格一目了然,这比逐个跳转测试函数高效得多。约定一条团队规则:纯函数的用例一律表驱动,例外(需要特殊构造的用例)单列并注明原因。
二、属性测试:让机器生成你想不到的用例
表驱动仍有一个天花板:用例的质量取决于工程师想到多少。属性测试(property-based testing)换了个思路——不写具体用例,写"对任意输入都必须成立的性质",让框架随机生成成百上千的输入去尝试推翻它。Python 的 hypothesis 是这一范式的代表:
from hypothesis import given, strategies as st # 待测函数:把时长归一化为分钟 def normalize(minutes: int) -> int: return minutes % (24 * 60) # 性质一:归一化两次等于归一化一次(幂等) @given(st.integers()) def test_idempotent(m): assert normalize(normalize(m)) == normalize(m) # 性质二:结果总落在合法区间 @given(st.integers()) def test_range(m): assert 0 <= normalize(m) < 24 * 60 # 性质三:与时移可交换(不变量) @given(st.integers(), st.integers()) def test_shift(m, delta): assert normalize(m + delta) == normalize(normalize(m) + delta)
三条性质没有任何具体输入,hypothesis 会自动生成负数、超大数、边界值——第一轮跑通常常直接抓出 normalize 在负数上的漏洞(Python 的 % 对负数返回非负值没问题,但换成手写的 while m >= 1440: m -= 1440 就死循环)。属性测试的价值不在替代表驱动,在覆盖表驱动的盲区:你没想到的等价类、没想到的边界组合,随机生成替你想。最实用的三类起步性质:往返性质(编码再解码等于原文)、幂等性质(做两遍等于做一遍)、不变量性质(输出永远满足某约束)。第 4 章埋的伏笔在此兑现:代数数据类型与 Monad 定律是属性测试的免费用例生成器——函子的两条定律直接就是两条属性。
属性测试的成本也要如实说:生成的输入需要收敛(策略写不好会生成无意义值浪费时间)、反例需要缩小(框架会自动最小化失败输入,但理解反例仍要人)、对有状态逻辑建模复杂。经验法则是:核心规则函数全力上属性,边角工具函数表驱动即可。
三、测试金字塔的函数式变体
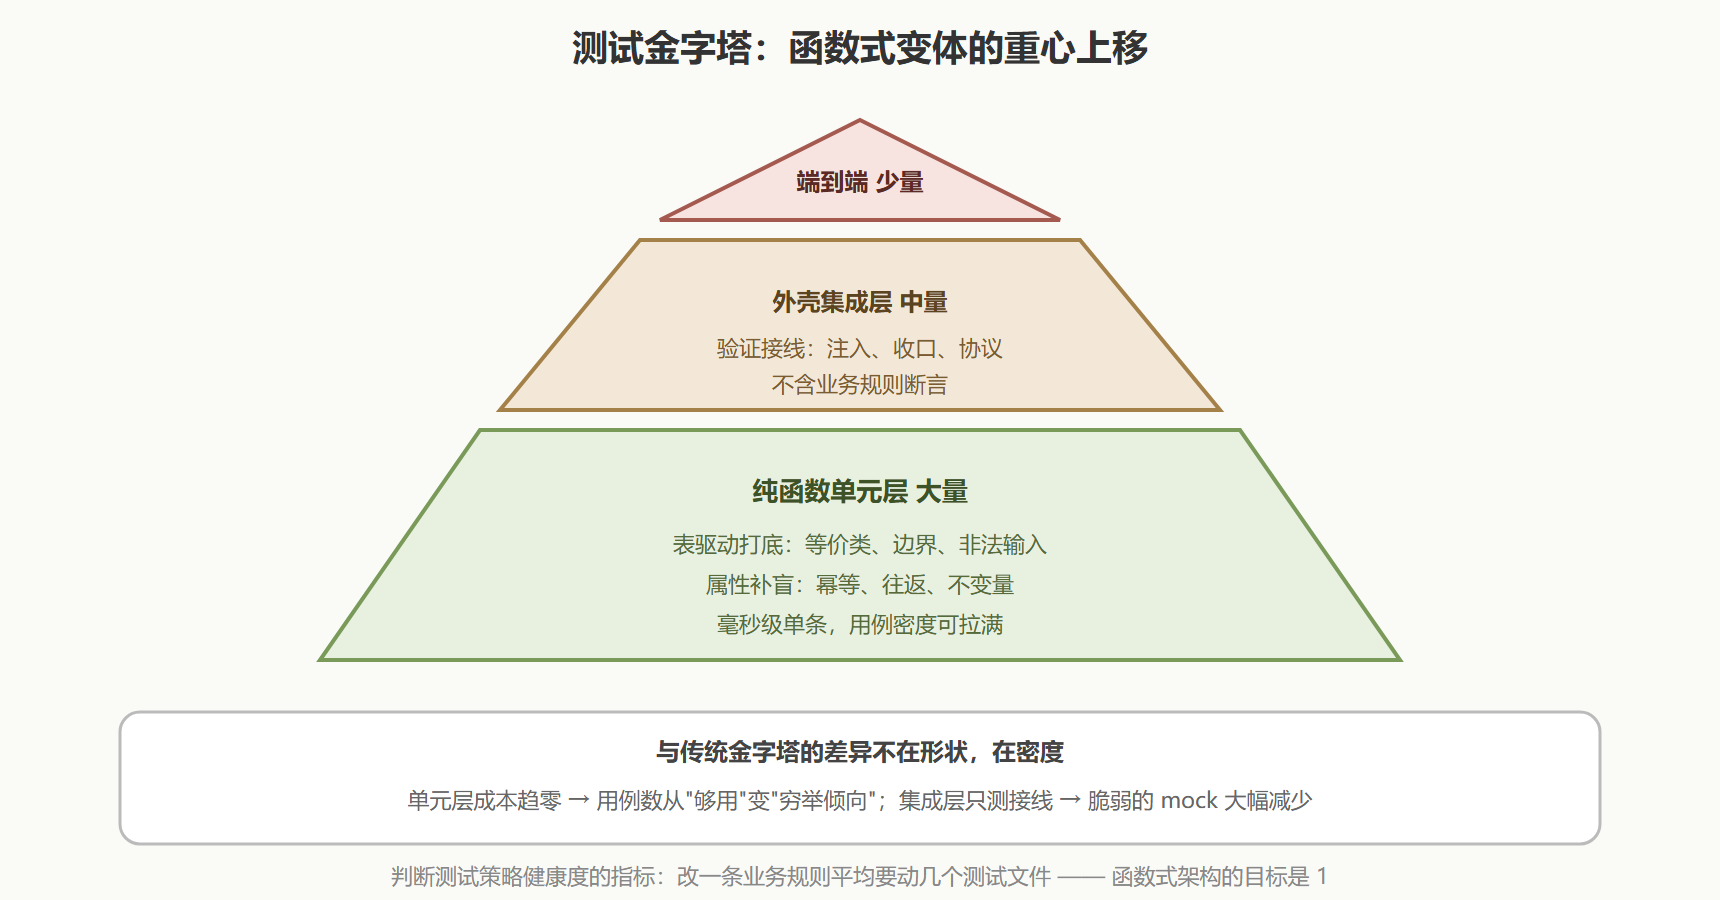
经典测试金字塔(大量单元测试、适量集成测试、少量端到端)在函数式架构下形状不变、重心上移:因为"单元"(纯函数)便宜到近乎免费,单元层的用例密度可以拉到传统架构不敢想的水平;而集成层只剩外壳薄层,需要验证的是"接线正确"(参数注入对不对、IO 收口对不对)而非业务规则。给一个我们验证过的配比参考:
图:函数式架构的测试重心分布
四、落地清单与一个真实的对比数据
给准备动手的团队一份落地顺序。第一周:新纯函数强制表驱动,评审检查表格完整性;第二、三周:挑一个规则最密的模块(计价、校验、配额之类)上属性测试,起步只用三类通用性质;第四周起:外壳集成层改"接线测试"(验证注入与收口,不断言业务值),删除依赖环境的业务断言。一个真实对比数据供预期管理:某规则引擎模块迁移后,测试代码行数从两千四百降到九百,用例数从一百一十涨到四百六十(属性测试一顶十),全量测试耗时从四分钟降到九秒——三个指标同时改善,这不是权衡,是纯度红利的一次性兑现。
💡 关键直觉:测试成本的大头从来不是断言,是环境。把副作用关进外壳后,测试工程里最贵的三件事——搭环境、清状态、修脆弱测试——自动消失大半。剩下的预算花在属性与边界上,那是从前不敢想的奢侈。
测试代码本身的评审要点
测试也是代码,也要评审,且函数式测试的评审关注点与传统测试不同。三个关注点。其一,看断言强度而不是用例数量:属性测试一条顶十,但前提是性质选对了——"生成输入断言不抛异常"这类伪性质(幂等与往返才是真性质)数量再多也没有拦截力,评审要能识别伪性质。其二,看边界格的完整性:表驱动用例评审时逐列扫一遍——空值、单元素、极大值、非法格式、临界值五类格子,缺哪类就追问哪类。其三,看测试与实现的耦合方式:好的函数式测试只依赖签名不依赖实现细节(内部用了列表还是树,测试不该感知);出现"为实现细节调整断言"的合并请求,通常是抽象出了问题,比测试本身的问题更值得追。
一个附加的团队实践:把属性测试的策略定义(生成器与约束)当作公共资产维护——特征字段、金额区间、日期边界这些业务约束写一份共享的策略库,各模块引用。策略库集中了"什么是合法输入"的业务知识,它同时服务测试与文档两个目的。
本节要点回顾
- 纯度清零环境成本:无 mock、无清理、无顺序依赖,测试退化为"调用加断言"。
- 表驱动是纯函数测试的默认形态:用例即数据,评审一眼见覆盖,团队规则值得固化。
- 属性测试补表驱动的盲区:幂等、往返、不变量三类通用性质起步,代数定律是免费用例。
- 金字塔形状不变重心上移:单元层密度拉满、集成层只测接线,mock 面积大幅缩减。
- 三个指标同时改善才是到位:代码量降、用例数涨、耗时降,缺一说明迁移没做完。
测试保障了"改动不破坏正确性",但 bug 终会出现。下一节处理另一半:出了问题,引用透明如何把排错从翻日志的玄学变成可推理的演算。