8.2 函数式的新战场:AI、分布式与数据工程
8.2 函数式的新战场:AI、分布式与数据工程
本节摘要:"函数式是未来"这类断言大多不值钱,值钱的是逐战场的适配度评估。本节检验三个新战场:AI 与机器学习(数据变换管道、确定性训练、可解释计算图)、分布式系统(一致性与不可变事件)、数据工程(声明式流水线)。每个战场区分"刚需部件"与"可选部件",并给出工程视角的加码建议。读完你应当能判断自己的技术栈里,函数式能力该往哪个方向追加。
评估方法:按部件对需求,不按口号站队
每个战场的评估用同一张表:列出该领域的核心工程痛点,再逐个问"函数式的哪个部件恰好是解药"。部件清单沿用全书积累——纯函数、不可变数据、代数类型、Monad 与效果隔离、惰性求值、高阶组合。痛点与部件的咬合度,就是适配度。这种评估法防两 种偏差:技术布道者的"处处适用",与保守派的"营销炒作"。
一、AI 与机器学习:确定性是稀缺品
AI 工程的核心痛点清单:训练结果不可复现、数据预处理管道脆弱、推理服务的输入输出关系不透明、实验版本混乱。逐项对照函数式部件——
数据预处理管道:适配度最高。 特征工程本质是"样本到特征的映射",与 ETL 同构。主流框架已经用函数式形状收编了它:PyTorch 的 Dataset 与 transform 组合、TensorFlow 的 tf.data 管道,都是高阶函数链。函数式纪律(每个变换纯、可单独测试、可组合复用)直接兑换成实验的可管理性——变换链固化即特征契约,回滚实验就是换一条管道。
确定性训练:适配度高但依赖纪律。 训练不可复现的元凶清单:随机种子不受控、数据顺序依赖、非确定算子、隐藏的全局状态(模型缓存、权重文件被中途修改)。函数式的对策是把"随机性"与"状态变更"全部显式化——种子作为参数注入(第 2.1 节的输入型副作用治理),状态变更收拢到受控边界。要做到"同代码同数据同结果",命令式训练脚本需要人工审计每一处全局写,而函数式结构的训练管道里,能改状态的入口在类型与架构上就是可见的。
推理服务与可解释性:适配度中高。 推理函数理想形态是纯函数——输入张量到输出张量的确定映射。现实中它被缓存、批处理、量化边界搅浑。函数式架构的价值在把"纯计算核"(模型前向)与"服务外壳"(批处理、缓存、降级)分离,让可解释性问题("为什么这个输入得到这个输出")退化为可复放问题——存下输入张量,任何结论可以离线重演。代数类型则在输出侧发力:分类结果、置信区间、拒答原因建模为和类型,调用方被强迫处理"模型拒答"分支,而不是收到一个静默的低分结果。
可选部件: 高级范畴论抽象(函子组合子设计神经网络层)在学术界有趣、在工程界收益尚未证明——第 8.3 节的鸿沟话题会再谈。务实建议:AI 工程师加码优先级为"纯函数管道 > 不可变实验状态 > 结果类型 > 更深抽象"。
二、分布式系统:不可变事件是最大公约数
分布式系统的痛点:部分失败(永远不知道对方是没收到还是没回话)、状态一致(多副本谁对)、演进兼容(服务独立升级)。函数式部件的咬合情况——
不可变事件溯源:刚需。 "把状态建模为不可变事件的折叠"(第 3.3 节的 fold 视角)在分布式语境下价值倍增:事件日志天然可复制、可重放、可审计——某个节点的状态 = 从创世事件折叠到当前。故障恢复就是重新折叠;争议仲裁就是对比事件序列。Kafka 的日志结构、事件溯源架构、CQRS 的读模型重建,全是"状态等于事件折叠"这一函数式命题的工程化身。
消息不可变:刚需。 第 6.1 节的 Actor 模型已经论证过:消息一旦可变,并发正确性论证立刻崩塌。分布式消息(跨网络传输的不可变记录)把这条纪律从进程内推广到集群尺度——消息即事实记录,发送方无法事后篡改,接收方无需防御性拷贝。
一致性协议的代数建模:适配度高但小众。 Raft、CRDT 这类协议的形式化与验证大量借用代数方法(CRDT 的核心是"合并操作满足交换律、结合律、幂等律"——半格的代数性质)。对多数工程师这是"了解即可"的层次,但理解"为什么 CRDT 能无冲突合并"这一层代数直觉,会在选型时救命——不是所有数据结构都能成为 CRDT,代数性质是准入门槛。
声明式部署与编排:适配度中。 Kubernetes 的声明式模型(描述期望状态而非操作步骤)、基础设施即代码,都是"表达式思维"在运维域的延伸——你要的是"是什么",不是"怎么做"。
三、数据工程:函数式的主场
如果说三个战场里哪个已经是函数式的既成事实,是数据工程。Spark(Scala 起家)的 RDD 变换链、Flink 的流式算子、Kafka Streams 的 KTable,全部是高阶函数管道的分布式放大——"map 与 reduce"这两个词本身就是函数式输出给大数据时代的名片。这个战场的函数式适配几乎不需要论证,值得展开的是两个新趋势。
趋势一:声明式 SQL 的复兴。 现代数据栈里,分析逻辑在向 SQL 回流(dbt 等工具把 SQL 变成可版本管理、可测试的资产)。SQL 本身是声明式函数式语言——描述"要什么",引擎决定"怎么算"。函数式工程师在 SQL 工程化浪潮里有天然优势:把查询视为纯函数(同样输入出同样结果)、用代数直觉理解连接与聚合、用不可变快照管理数据版本。
趋势二:流批一体的函数式统一。 第 6.2 节的事件流与本节的数据管道在此汇合:流处理与批处理的本质差异在"数据的边界性"(有界集合对无界流),而变换逻辑可以完全共享——map、filter、reduce 对两者通用。这种"一套变换逻辑、两种执行边界"的设计,正是惰性求值(第 2.2 节:惰性让"定义与执行的分离"成为可能)在工业尺度的应用:算子先定义成图,执行引擎再决定何时何处怎么算。
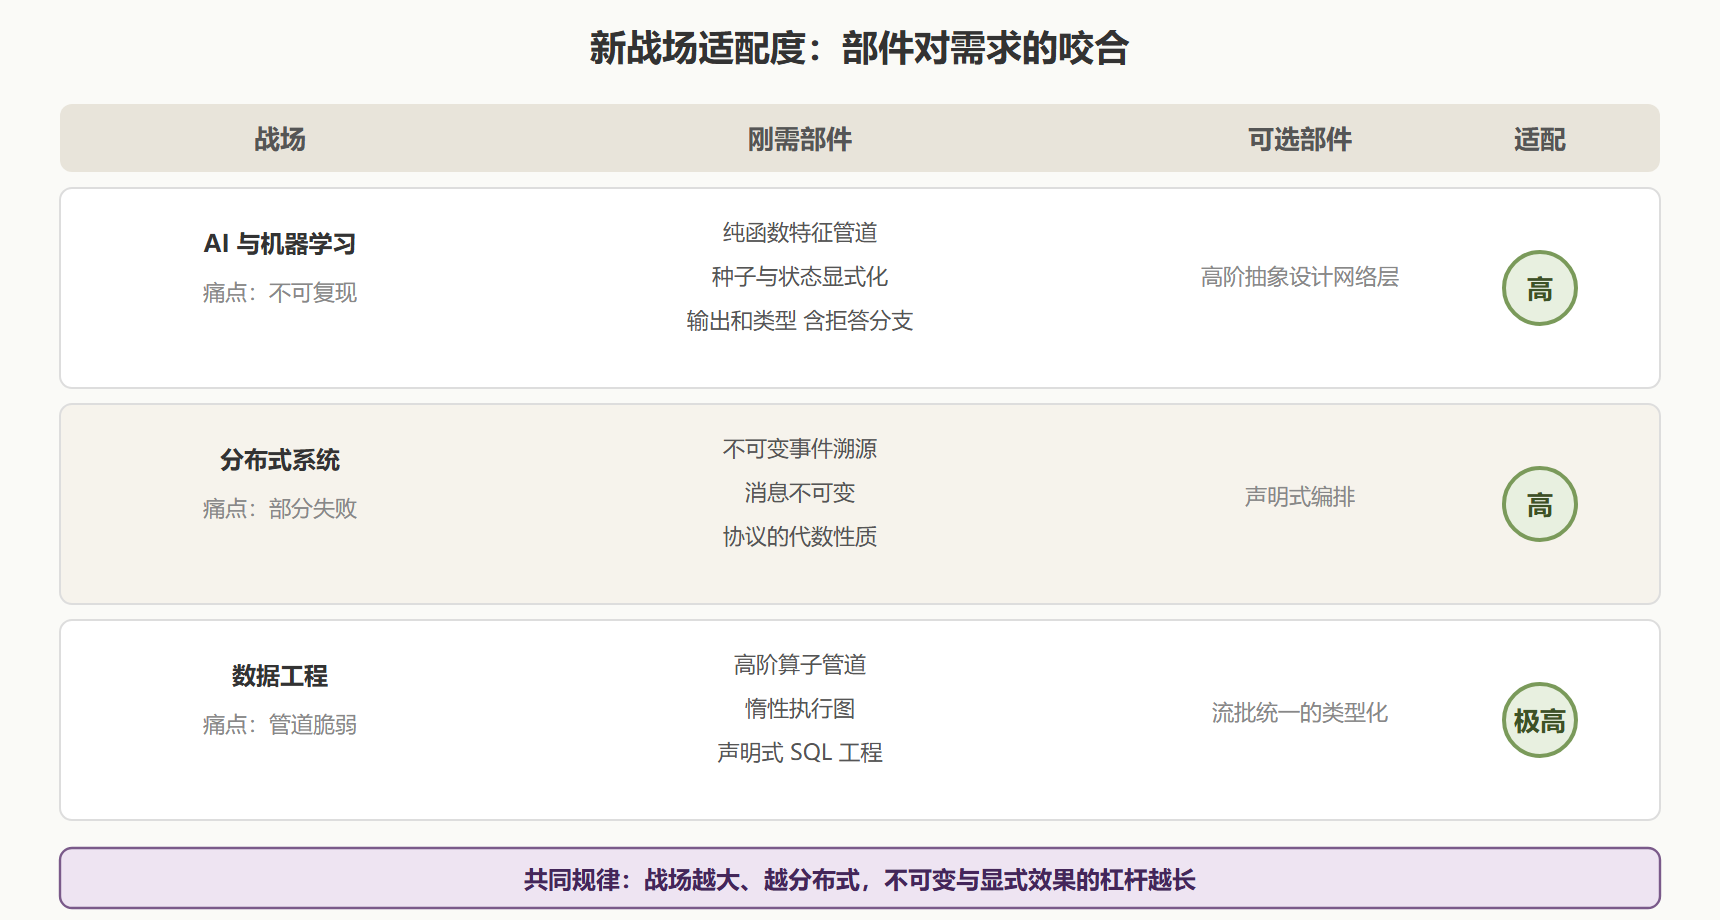
图:三战场的部件适配度矩阵
四、加码建议与一次冷思考
给三类读者的加码路线。后端工程师:不可变事件建模是分布式方向的必修课,建议下一个设计从"状态为事件之折叠"重新推演一遍;AI 工程师:把特征管道与训练入口按第 2.1 节标准治理一次,可复现性的收益即刻可见;数据工程师:你已经在函数式的地里了,补的是理论词汇——把日常的管道操作对应回函子、折叠、惰性,理解会从"会用"升到"能改造"。
冷思考收尾,防评估滑向另一面的吹捧:函数式不是这三个战场的全部答案。AI 工程的性能热路径(算子内核、GPU 调度)是命令式与硬件的天下;分布式的一致性证明需要的数学超出常规函数式训练;数据工程的存储引擎优化与函数式无关。适配度矩阵的"高"字,说的是部件与痛点的咬合,不是范式对领域的吞并。带着这个限制条件读上面的矩阵,它才是诚实的。
💡 关键直觉:判断一个新战场是否需要函数式,别问"它新不新",问它的痛点清单里有多少条与"状态、时序、副作用"相关——有,函数式的杠杆就长;没有(纯性能、纯硬件域),就不必硬凑。
本节要点回顾
- 按部件对需求评估:痛点与部件的咬合度即适配度,防"处处适用"与"营销炒作"两种偏差。
- AI 的刚需在管道与确定性:特征管道函数式化、种子状态显式化,兑换实验可管理性。
- 分布式的最大公约数是不可变事件:状态即事件折叠,消息即事实记录,协议靠代数性质。
- 数据工程是既成事实的主场:map 与 reduce 的工业化身,流批统一靠惰性求值支撑。
- 适配度不等于吞并:性能内核、存储引擎等领域仍属命令式,诚实标注限制才可信。
三个战场看完,还剩最后一问:从 λ 演算到生产代码之间的那道理论鸿沟,如今填到了哪里——这是全书的收束。