2.3 背压机制 Backpressure
2.3 背压机制 Backpressure
本节摘要:背压是 Reactive Streams 的宪法性条款——下游通过
request(n)申领配额,上游不得超发。Reactor 在此之上提供 buffer/drop/latest/error 等溢出策略,本质是业务对「完整性 vs 时效性」的裁决。
本节地图
- 解释
request(n)与 Little's Law 下队列发散的关系 - 为监控指标流与交易流水各选一种溢出策略
- 说明 Netflix Reactor 迁移事故与背压缺失的关联
一、为何背压是生死契约
阻塞 I/O 里,read() 挂起线程直到有数据——速率失配被线程物理拖慢。响应式解耦 Publisher/Subscriber 后,若上游脉冲式爆发(传感器、行情、日志)而下游风控/聚合有刚性算力,队列长度 (L = \lambda_{\text{in}} \cdot \overline{\Delta t}) 会在 (\lambda_{\text{in}} > \mu_{\text{out}}) 时发散,导致 OOM 与 GC 风暴。
SOURCE 案例:Netflix 早期未启用背压的 Flux.create() 在突发流量下把事件灌进无界队列;Kafka max.poll.records 与消费者内存不匹配同理——不是代码 bug,是契约缺失。
背压的本质是回答一个残酷问题:当生产速度永远大于消费速度时,多出来的数据去哪? 选项只有四个——留在内存里(buffer,可能 OOM)、扔掉(drop/latest,损失数据)、报错(error,打断流程)、让上游慢下来(request(n),唯一可持续的方案)。阻塞模型里这个问题被线程隐式回答了(消费者慢,生产者被阻塞),但代价是线程资源被占用;响应式把选择权交还给业务方,代价是你要显式决策。很多「响应式系统内存暴涨」的故障,根因不是响应式本身,而是选择了默认 buffer 却没有设置上限——契约缺失,而非机制失效。
二、协议层:信用制拉取
Reactive Streams 规定:
onSubscribe后 Subscriber 才能request(n),n必须为正- Publisher 已发出但未
request的元素数不得超过累计配额 onError/onComplete互斥且终止流cancel()后不得再发onNext
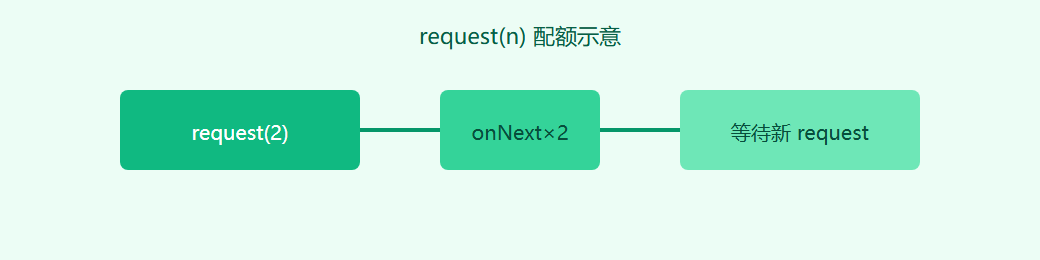
把 request(n) 理解为信用额度是理解背压的关键:Subscriber 一开始「充值」2 个信用,Publisher 发出 2 个元素后信用归零,即使数据源还有数据也必须停下;Subscriber 处理完再 request(1) 续费,Publisher 才能继续发。整个协议建立在「双方都遵守信用规则」的信任上——任何一方违约(超发或拒收)都会破坏链路。这就是为什么规范第 3 章会逐条写清违约后果,也是为什么「背压」被称为响应式的宪法条款。
三、Reactor 溢出策略
| 策略 | API | 适用 |
|---|---|---|
| 缓冲 | onBackpressureBuffer(1000) |
可容忍短暂积压 |
| 丢弃 | onBackpressureDrop() |
老样本可丢 |
| 最新 | onBackpressureLatest() |
配置推送、监控仪表盘 |
| 报错 | onBackpressureError() |
强一致,宁停勿错 |
Flux.interval(Duration.ofMillis(1)) .onBackpressureLatest() .subscribe(v -> slowConsumer(v));
选择策略的决策树可以归纳为三步:
- 这个数据能丢吗? 交易流水、订单状态不能丢 → buffer 或 error;传感器采样、监控指标可以丢 → drop/latest。
- 丢的话丢哪个? 丢最旧的用
drop(保留最新,适合「看当前状态」);丢最新的用onBackpressureBuffer(1, BufferOverflowStrategy.DROP_OLDEST)之类的变体。 - 能接受停下来吗? 强一致场景宁可 error 让系统进入降级,也不静默丢数据。
// 交易流水:强一致,缓冲有界,溢出即报错 Flux.from(transactionStream) .onBackpressureBuffer(10_000, BufferOverflowStrategy.ERROR) .flatMap(tx -> settlementService.settle(tx), 64); // 监控指标:时效优先,只保留最新 Flux.from(sensorStream) .onBackpressureLatest() .map(this::aggregateWindow) .subscribe(metricsSink::emit);
这两段代码展示同一套 API 服务于两种完全不同的业务承诺:结算流水追求完整性——宁可溢出报错触发告警,也不能悄悄丢一笔账;监控指标追求时效性——仪表盘只看最新值,堆积的历史样本毫无意义。背压策略的选择 = 业务价值的排序,这正是本节摘要说的「完整性 vs 时效性的裁决」。
⚠️ 常见坑:在 EventLoop 线程做重计算且不
publishOn,背压信号来不及回传,缓冲区仍可能涨满。
背压与性能的常见误解
| 误解 | 澄清 |
|---|---|
| 「响应式=无界异步」 | 无界只是默认,真正价值在 request(n) 控流 |
| 「有背压就永不 OOM」 | 背压是协商机制,buffer 策略仍可能溢出 |
| 「drop 一定丢业务数据」 | 对幂等/可重放数据,drop+重放是合理设计 |
| 「背压只在 JVM 内有效」 | 需跨协议传递(RSocket、Kafka)才有全链路效果 |
四、跨框架的背压对照
背压语义在不同响应式实现中形态各异,理解这些差异是选型与桥接的基础:
| 实现 | 背压机制 | request 语义 | 备注 |
|---|---|---|---|
| Reactor | Flux/Mono 原生 |
RS 规范 request | 最完整 |
| RxJava 2+ | Flowable 才支持 |
RS 规范 | Observable 无背压 |
| RxJS | 无原生 request | 无 | 用操作符近似 |
| Akka Streams | Actor 间信号 | 内置 | 图 DSL 层透明 |
| Kafka | 批次拉取 | max.poll.records |
非 RS,近似背压 |
// Reactor 中手动 request 的完整示例 Flux.range(1, 100) .limitRate(10) // 每次自动请求 10 个 .map(i -> i * i) .subscribe();
关键提醒:不是所有「响应式」库都支持背压。 RxJava 的 Observable 与 Flowable 是两个不同类型——前者无背压(适合 UI 低频事件),后者遵循 RS(适合数据流)。RxJS 至今没有原生 request,前端开发者用 debounceTime、throttleTime、mergeMap(..., n) 等操作符在消费端近似实现控流。跨框架桥接时,要明确两端各用什么机制控流,否则一端认为「有背压」、另一端认为「无限 push」,又回到第 1.3 节所说的歧义事故。
温故知新
- 背压是反向控制信道,不是可选优化
- 策略选择 = 业务价值排序(完整性 / 时效 / 确定性)
- 跨语言实现须对齐
request语义,否则像 Netflix 与 Akka HTTP 的「缓冲区满」歧义会级联故障
一句话总结:背压让「生产快于消费」从崩溃级故障,降级为可决策的业务问题。 你只要在四个选项里做出选择并设好上限,剩下的交给协议保证。
第 3 章把上述契约写成 Reactive Streams 四接口的规范文本。