4.3 数据库与中间件支持
4.3 数据库与中间件支持
本节摘要:响应式价值在端到端非阻塞。R2DBC、Reactive Mongo、Kafka Reactive Consumer、Lettuce(Redis)等组件把背压延伸到存储与消息层;混用阻塞驱动则前功尽弃。
你能学到什么
- 配置 Kafka Reactive Consumer 的
max.poll.records与背压 - 说明 MongoDB Reactive Streams Driver 的
Publisher<Document> - 识别「Mono 包 JDBC」反模式
一、数据库驱动
| 组件 | 协议/实现 | 备注 |
|---|---|---|
| R2DBC PostgreSQL | RS Publisher | SOURCE 称较成熟 |
| R2DBC MySQL | RS | Beta 阶段需谨慎 |
| Mongo Reactive | RS | Flux<Document> 查询 |
| Hibernate/JPA | 阻塞 | 与 WebFlux 不兼容 |
ReactiveMongoTemplate template; template.find(query, User.class) .take(100) // 限制拉取,配合下游处理速度 .flatMap(this::enrich, 8); // 并发度 8
MongoDB Reactive Streams Driver 返回的 Publisher<Document> 是 RS 原生的:查询结果按需拉取,take(100) 限制只取前 100 条并触发上游停止,flatMap(enrich, 8) 限制同时进行 8 路富化。对比 JPA 的 findAll() 一次性加载,响应式驱动让结果集规模成为显式决策,而不是内存里的隐忧。
数据库驱动的成熟度分级
| 数据库 | R2DBC | Reactive 驱动 | 建议 |
|---|---|---|---|
| PostgreSQL | 较成熟 | — | 可生产 |
| MySQL | Beta | — | 试点评估 |
| MongoDB | — | 成熟 | 可生产 |
| Redis(Lettuce) | — | 成熟 | 可生产 |
| Oracle | 空白 | — | 暂不支持 |
二、Kafka 与 Redis
Kafka Reactive(Reactor Kafka):KafkaReceiver 返回 Flux<ReceiverRecord>,receiveAutoAck vs 手动 ack 影响至少一次语义与背压。SOURCE 提醒 max.poll.records 过大时消费者堆内存仍可能 OOM。
// Reactor Kafka:手动 ack 控制背压与投递语义 KafkaReceiver.create(receiverOptions) .receive() // Flux<ReceiverRecord<K, V>> .concatMap(record -> // 顺序处理保证有序 process(record).thenReturn(record)) .doOnNext(ReceiverRecord::ack) // 处理成功才 ack .subscribe();
Kafka 本身没有「request(n)」,它的背压手段是批次控制:max.poll.records 限制单次拉取数量,poll 间隔决定拉取节奏,commit/ack 决定重投语义。Reactor Kafka 把它包装成流:concatMap 保证处理有序,ack 时机决定「至少一次」还是「至多一次」。配置 max.poll.records 时如果太大,消费者内存依然会涨——背压的职责被移交给消费者端的批次参数,而不是协议自动完成。
Lettuce(Redis):异步命令返回 RedisReactiveCommands,适合会话缓存、限流计数与 WebFlux 同线程模型协作。
// Lettuce:响应式 Redis 计数 RedisReactiveCommands<String, String> cmd = client.connect().reactive(); cmd.incr("rate:user:" + userId) // 限流计数 .flatMap(n -> n > 10 ? Mono.error(new RateLimitExceeded()) : Mono.just("ok")) .onErrorResume(RateLimitExceeded.class, e -> Mono.just("too-many"));
Redis 的响应式支持主要靠 Lettuce(基于 Netty 的异步客户端):所有命令返回 Publisher,天然适配 WebFlux 的线程模型。限流计数、会话缓存这类高频短操作是它的主场——与阻塞客户端(Jedis)相比,同一连接可以并发发出多个命令,无需线程池排队。
三、中间件组合示例
实时推荐管线(SOURCE 第二章拓扑):用户行为 Kafka → Reactor flatMap 特征提取 → R2DBC 读画像 → WebFlux SSE 推送。每一跳若改用阻塞 HTTP,EventLoop 会被占满。
// 全链路响应式推荐管线(概念示意) kafkaReceiver.receive() // Kafka 事件流 .map(record -> parse(record)) // 反序列化 .flatMap(userEvent -> // 特征提取 + 画像读取并发 Mono.zip(featureService.extract(userEvent), profileRepo.findById(userEvent.userId)), /*concurrency*/ 32) .flatMap(t -> recommendService.score(t)) // 推荐打分 .concatMap(r -> sseSink.emit(r)); // SSE 推送
这段管线每一跳都是非阻塞的:Kafka 接收 → 特征提取/画像读取(并发 32)→ 打分 → SSE 推送。任何一个环节替换成阻塞调用(比如 profileRepo 换成 JPA + block()),整条链的性能就从 EventLoop 拖回线程池模型。 这就是 4.3 标题「数据库与中间件支持」的意义——响应式的最后一公里在数据层。
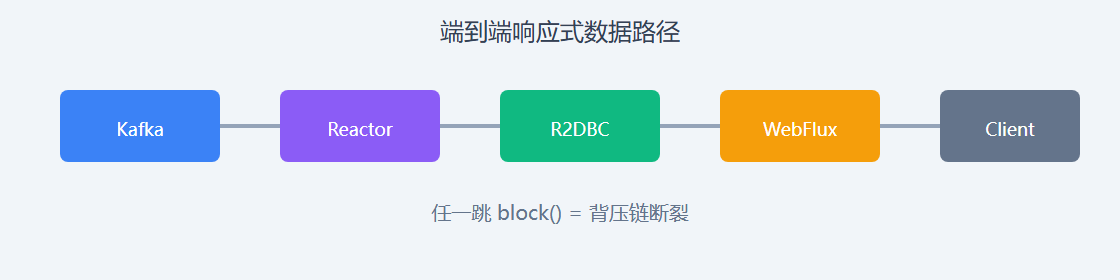
全链路阻塞审计清单
| 环节 | 检查项 |
|---|---|
| 数据库 | 是否 R2DBC/Reactive 驱动,还是 JDBC 包 Mono |
| 消息 | 是否 Reactive Consumer,ack/批次是否受控 |
| 缓存 | Lettuce 还是阻塞 Jedis |
| HTTP 客户端 | WebClient 还是 RestTemplate |
| 文件/网络 | 是否非阻塞 API |
要点串联
- 驱动成熟度不均,PostgreSQL R2DBC 优先于 Oracle 路线
- 消息中间件要调批次与 ack 配合处理速率
- 全链路审计:列出一处阻塞调用即标红
一句话总结:响应式系统的能力边界由数据层决定——R2DBC、Reactive Mongo、Lettuce 补上了「最后一段非阻塞」,但每块驱动的成熟度都要单独验证,任何一处阻塞调用都会让整条链退化为阻塞模型。
数据层选型决策表
| 数据库 | 非阻塞方案 | 生产就绪度 | 替代方案 |
|---|---|---|---|
| PostgreSQL | R2DBC | 较高 | — |
| MySQL | R2DBC(Beta) | 中 | 阻塞驱动 + boundedElastic |
| MongoDB | Reactive Streams Driver | 高 | — |
| Redis | Lettuce | 高 | Jedis(阻塞) |
| Kafka | Reactor Kafka | 高 | 原生 Consumer + 手动线程池 |
| Oracle | 无 R2DBC | 低 | 阻塞驱动 + 隔离 |
这张表是 4.3 的浓缩结论:没有「全数据库统一响应式」这回事,每块数据源都要单独评估驱动成熟度。 当某块存储没有成熟的非阻塞驱动时,正确的做法是明确隔离(boundedElastic + 明确标注),而不是硬塞进响应式链假装非阻塞。
全链路审计操作步骤
// 审计:逐环节标注 I/O 类型 // 环节1: HTTP 入站 → WebFlux/Netty → 非阻塞 ✓ // 环节2: 服务间调用 → WebClient → 非阻塞 ✓ // 环节3: 数据库 → R2DBC PostgreSQL → 非阻塞 ✓ // 环节4: Redis → Lettuce → 非阻塞 ✓ // 环节5: Kafka → Reactor Kafka → 非阻塞 ✓ // 全部 ✓ → 链路为真响应式 // 任一处 ✗ → 该环节必须 boundedElastic 隔离并标注
审计的价值不在于追求「全部非阻塞」的完美主义,而在于让每一处阻塞显式化——被标注和隔离的阻塞调用至少是可预期的,最危险的是「你以为非阻塞、实际阻塞」的隐性断点。