5.2 数据转换与组合
5.2 数据转换与组合
本节摘要:
map同步变换;flatMap一对多异步展开;switchMap取消旧 inner;merge并发合并;zip/combineLatest多源对齐。选算子 = 选并发与取消语义。
核心问题
- 为「搜索框防抖」选
switchMap而非flatMap - 说明
flatMap(fn, concurrency)如何限流 - 对比
zip与combineLatest的触发条件
一、核心算子
| 算子 | 语义 | 典型场景 |
|---|---|---|
map |
1→1 同步 | 格式化字段 |
flatMap |
1→N 异步,inner 可并发 | 批量 RPC |
switchMap |
新 inner 取消旧 inner | 搜索、路由切换 |
concatMap |
inner 顺序串行 | 必须保序写库 |
merge |
多流交织 | 多传感器汇总 |
// 搜索:只保留最新请求结果 Flux.fromIterable(queries) .concatMap(q -> webClient.get().uri("/s?q=" + q).retrieve().bodyToMono(Result.class)); // 若并发搜索应 switchMap,concatMap 会排队旧 query
map 是最简单的变换:同步的 1→1 映射,不引入并发,不改变流的结构。它等价于 stream().map(),唯一区别是这里的「元素」从「一次遍历的元素」变成「流上的信号」。
flatMap 是并发展开:每个上游元素展开成一个内部流,所有内部流并发执行,结果交织进下游。它的关键参数是 concurrency(并发上限)——不设上限时,上游一次来 1 万个元素就可能同时发起 1 万个请求,这往往是内存与连接池爆炸的元凶。
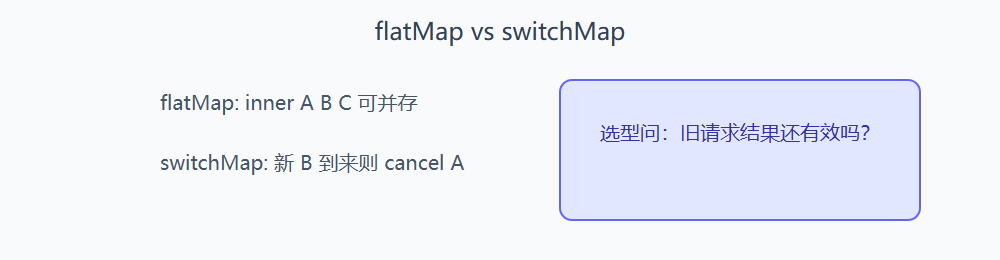
switchMap 是「只留最新」:新元素到达时,取消尚未完成的旧内部流,只保留最新一个的执行结果。它是搜索框、路由切换这类「输入变化即取消旧任务」场景的唯一正确选择。
concatMap 是「严格保序」:内部流一个一个串行执行,前一个完成才启动下一个。它不引入并发,但保证输出顺序与输入顺序一致——写库、转账这类顺序敏感的操作用它。
flatMap vs switchMap vs concatMap 行为对照
| 特性 | flatMap | switchMap | concatMap |
|---|---|---|---|
| 并发 | 高(默认无界) | 仅最新一个在跑 | 串行 |
| 取消旧任务 | 否 | 是 | 否 |
| 输出顺序 | 按完成时间 | 按最新 | 严格按输入序 |
| 典型用例 | 批量 RPC | 搜索/导航 | 保序写库 |
// 选择决策树 boolean 输入可能快速变化且旧结果无用? → switchMap boolean 必须严格保序? → concatMap 其余(并发提升吞吐) → flatMap(fn, concurrency)
二、多源组合
zip:各源都 emit 一次才输出 tuple——适合严格对齐批次combineLatest:任源更新即重算——适合 UI 多字段联动(SOURCE 1.1x$ = y$.combineLatest(z$))
Mono.zip(accountService.get(id), riskService.score(id), Tuple2::of);
zip 与 combineLatest 的区别在于触发条件:zip 等待所有源各自发出一个元素后打包输出,任何一源掉队就整体等待——适合「三批数据必须对齐」的场景(多仓对账);combineLatest 只要任一源更新就立即用「各源当前最新值」重算——适合「任一输入变化都要联动刷新」的场景(搜索条件 + 分页 + 排序联动的列表页)。判断口诀:要「齐步走」用 zip,要「实时联动」用 combineLatest。
// RxJS 中同样的语义 import { zip, combineLatest, of } from 'rxjs'; import { map } from 'rxjs/operators'; const a$ = of(1, 2, 3); const b$ = of('x', 'y'); zip(a$, b$).subscribe(console.log); // [1,'x'] [2,'y'] 齐步走 combineLatest([a$, b$]).subscribe(console.log); // 任一变化即重算
三、并发与背压
flatMap 默认 unbounded 并发可能压垮下游;Reactor 提供 flatMap(fn, concurrency)。高吞吐 ETL 用 publishOn + 有限 concurrency 优于无限 merge。
// 受控并发:同时最多 16 个内部流 source .flatMap(item -> asyncProcess(item), 16) .subscribe(); // 更进一步:配合 publishOn 把处理切到独立线程池 source .publishOn(Schedulers.parallel()) .flatMap(item -> asyncProcess(item), 16);
为什么「有限 concurrency」是响应式工程的分水岭?因为无界并发会把「慢下游」问题从队列转移成连接风暴:上游 10 万条数据,flatMap 全部展开时同时发起 10 万请求,数据库连接池、外部 RPC 连接池瞬间打满,反而比排队更慢。设置 concurrency=16 本质是在组合层手动实现背压——让同时进行的任务数恒定为 16,配合队列自然消化积压。
组合算子选型总表
| 需求 | 算子 | 关键点 |
|---|---|---|
| 同步变换 | map |
无并发 |
| 并行独立任务 | flatMap(fn, n) |
限并发 n |
| 只留最新 | switchMap |
自动取消旧 |
| 严格保序 | concatMap |
串行 |
| 多流合并 | merge / mergeWith |
无序交织 |
| 多源对齐 | zip / combineLatest |
触发条件不同 |
| 去重防抖 | distinctUntilChanged / debounce |
时间相关 |
一节小结
- 算子语义即并发契约
- 搜索/导航用
switchMap;订单写入用concatMap combineLatest表达因果依赖,不是简单 merge
一句话总结:组合算子的本质是「并发 + 取消 + 顺序」三个维度的声明——选对算子,系统行为就在名字里写明白了。
组合算子的执行时序图
以「上游三个元素、每个展开两个内部元素」为例,对比三种展开算子:
上游: ──1──2──3──→ flatMap: ──1a 1b 2a 2b 3a 3b──→ // 并发交织,乱序 concatMap: ──1a 1b 2a 2b 3a 3b──→ // 严格保序 switchMap: ──1a 2a 3a 3b──→ // 新元素取消旧 inner
flatMap 的每个内部流启动后立即并行跑,完成一个输出一个,所以输出顺序取决于内部流完成时间(通常乱序);concatMap 必须等前一个内部流完全结束才开始下一个,输出严格有序,代价是串行;switchMap 在 2 到来时取消 1 的内部流、3 到来时取消 2 的内部流,最后只有 3 的完整结果输出——它牺牲了「完整性」换取「最新性」。
// 用并发度参数控制 flatMap 的资源占用 Flux.fromIterable(ids) .flatMap(id -> rpcService.call(id), 8) // 同时最多 8 个请求 .subscribe();
多源组合的时序对照
| 算子 | 触发条件 | 输出 | 场景 |
|---|---|---|---|
zip |
所有源各就位一次 | 打包元组 | 批次对齐 |
combineLatest |
任一源更新 | 最新值组合 | UI 联动 |
merge |
任一源发射 | 原样交织 | 汇总多路 |
concat |
前源完成 | 顺序拼接 | 分批加载 |
switchMap |
任一源更新 | 只留最新 | 搜索/导航 |
merge 与 concat 看似相似实则相反:merge 让多个源并发交织(谁先到谁先出),concat 让多个源串行拼接(前一个结束下一个才开始)。四者的选择取决于:是否并发(merge vs concat)、是否对齐(zip vs combineLatest)、是否只留最新(switchMap)。