2.3 数据模型与寻址
2.3 数据模型与寻址
本节摘要:点表上的"40001"不是报文里的地址字节,四类寄存器各有编号惯例,五位数写法与零基偏移之间差一;本节把这套历史惯例彻底讲清,并处理 32 位量跨寄存器与字节序两个进阶问题。
拆一句行话:"读一下 40001"
现场老工程师一句"帮我把 40001 加进轮询",新人对着报文抓包半天对不上号——抓到的请求里根本没有 40001 这个数。这句行话里藏着三层信息:开头那个 4 说的是"保持寄存器区";后四位 0001 说的是"该区的第 1 个";而真正进报文的地址字节是 0x0000,因为报文地址从零起算,点表从 1 起算。**点表写法是给人看的"一基"编号,报文地址是给协议用的"零基"偏移,中间永远差一。**这一节就是把所有类似的历史包袱一次理清。
学习目标
阅读完本节,你应当能够:
- 说出四类数据对象的编号区间、读写权限与典型用途;
- 在"五位数点表地址"与"报文零基偏移"之间熟练换算;
- 解释 32 位数据跨两个寄存器时的字序与字节序问题;
- 拿到任意厂商的点表时,判断它的地址写法属于哪种惯例。
一、四类数据对象:协议的全部世界观
Modbus 的数据模型只有四张"表":线圈(可读写位)、离散输入(只读位)、保持寄存器(可读写字)、输入寄存器(只读字)。位对应开关量,字对应数值量;"保持"与"输入"的分界是控制权——保持寄存器是主站可以下命令改变的区域(设定值、控制字),输入寄存器是设备自报家门的区域(测量值、状态字)。这个四分法简单到近乎简陋,但它撑起了四十年的设备生态。
| 数据对象 | 访问权限 | 数据宽度 | 典型内容 | 点表惯例前缀 |
|---|---|---|---|---|
| 线圈 | 读写 | 1 位 | 继电器输出、启停命令 | 0 |
| 离散输入 | 只读 | 1 位 | 告警位、限位开关状态 | 1 |
| 输入寄存器 | 只读 | 16 位 | 温度、压力等测量值 | 3 |
| 保持寄存器 | 读写 | 16 位 | 设定值、参数、控制字 | 4 |
惯例前缀就是 40001 这类五位数的来源:万位的 0、1、3、4 标出所属区域,剩下的四位是该区内的编号。个别厂商还有以 6 开头的扩展写法或六位数写法,遇到时先问一件事:**这个写法是"区前缀加区内一基编号",还是"完整地址直接给出"?**两种理解的报文地址差 1,症状是"读得到但值看着像邻居的数据"。
二、换算规则与一张地址地图
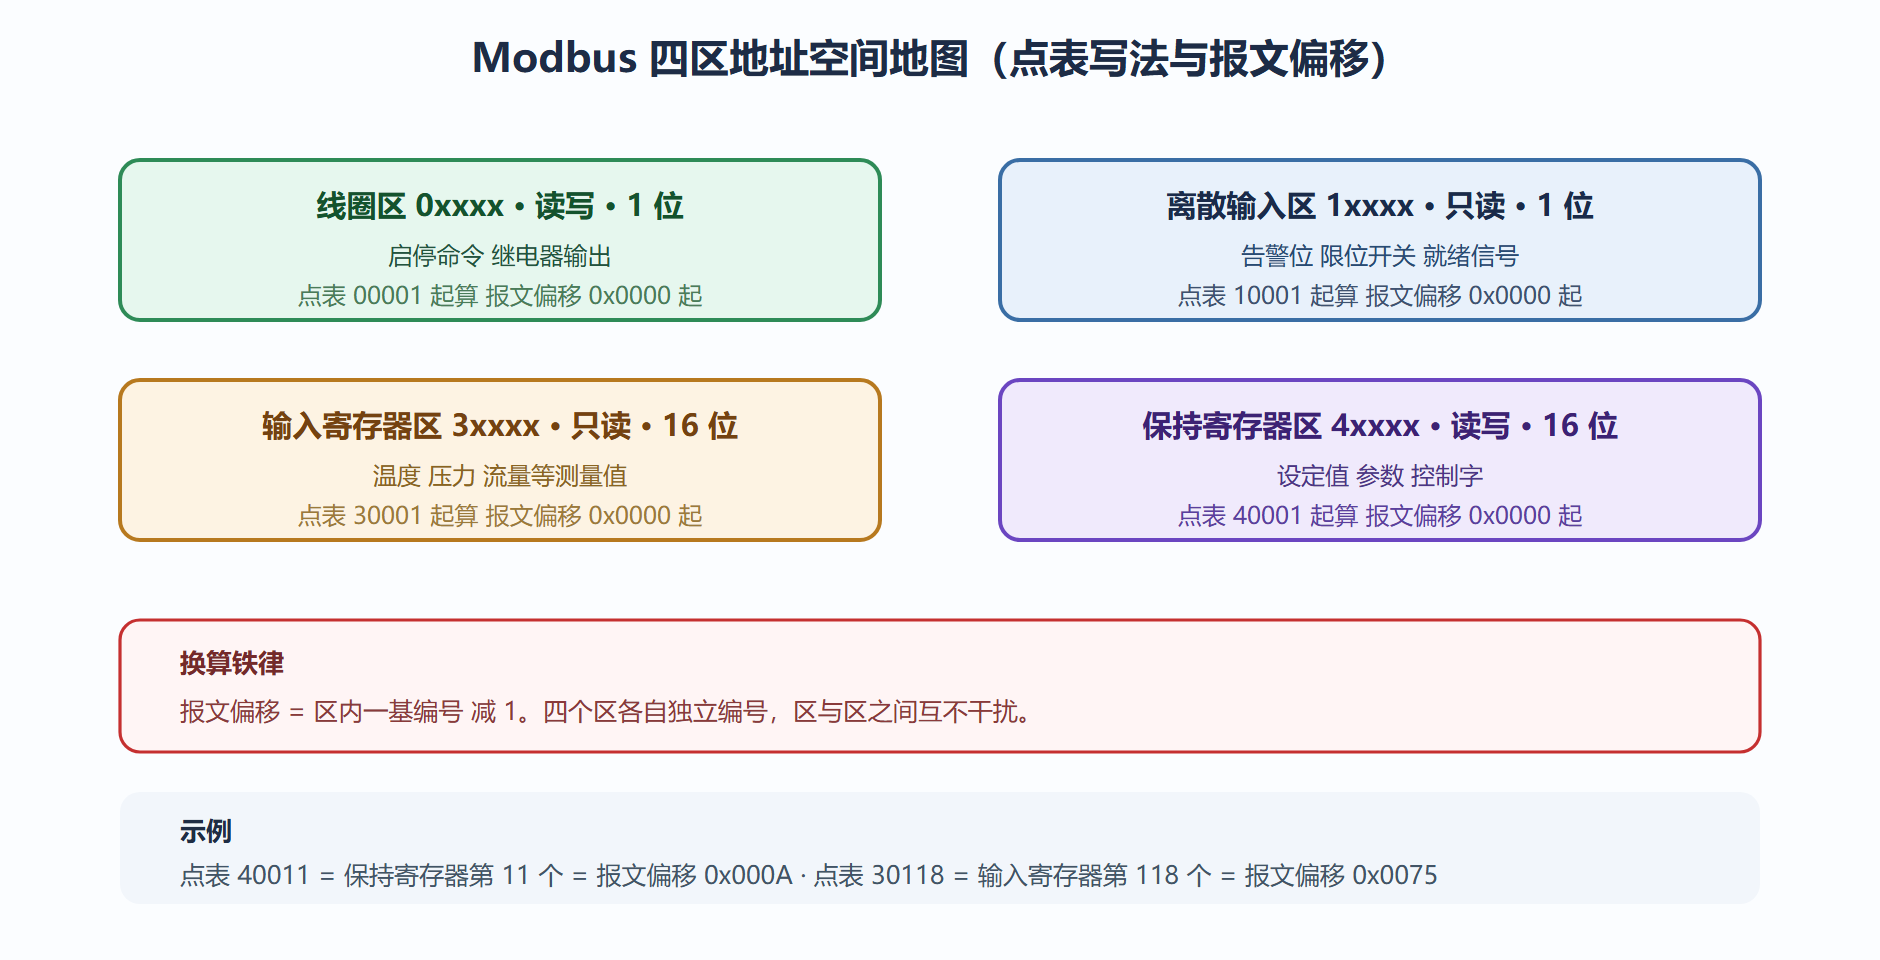
把三个世界的换算钉死:点表地址(一基、带区前缀)→ 区内编号减一 → 报文偏移(零基)。举例:点表 40011 表示保持寄存器区第 11 个,报文偏移为 10,即 0x000A;点表 30118 表示输入寄存器区第 118 个,报文偏移 117,即 0x0075。换算错误是"读回来全是怪数"类故障的第二大来源(第一大是字节序,见后文),养成口算习惯很值。
三个世界的地址对照速查 点表写法 含义 报文偏移(十六进制) 00001 线圈区第 1 个 0x0000 00157 线圈区第 157 个 0x009C 10033 离散输入区第 33 个 0x0020 30011 输入寄存器区第 11 个 0x000A 40001 保持寄存器区第 1 个 0x0000 40109 保持寄存器区第 109 个 0x006C 功能码与区域的搭配(常用组合) 01 读线圈 -> 点表 0xxxx 02 读离散输入 -> 点表 1xxxx 03 读保持寄存器 -> 点表 4xxxx 04 读输入寄存器 -> 点表 3xxxx
还有一个不能靠背的辨析点:**功能码决定区域,不决定写法。**有厂商点表把保持寄存器写成"HR1",有厂商直接写"地址 0 通道 1",也有厂商从 40001 起编但报文偏移不减一(这种属于非标实现,文档里一定注明)。拿到陌生设备,最可靠的校准办法是用 2.4 的抓包实验读一个已知值的寄存器——比如读到 2500 的那个——反推写法是否匹配。
图7 寄存器地址空间地图
三、进阶:32 位量与字节序的坑
16 位寄存器装不下浮点数与 32 位整数,协议的约定朴素:**用相邻两个寄存器拼。**主站请求"从 40051 读 2 个寄存器",拿到四字节原始数据,按设备声明的方式拼成 32 位量。问题来了——拼接方式没有统一标准,常见有四种:大端(高字在前、字内高位在前)、小端(低字在前、字内低位在前)、以及两种"字交换"变体(字序与字节序不一致地混排)。同一份数据按不同方式拼接,会得到完全不同的数值,比如真实温度 25.0 摄氏度可能被读成一千万开尔文量级的怪数。
处理原则有三条。第一,查设备手册的数据格式说明,厂商一般会写明"32 位浮点,高字在前"之类表述。第二,手册含糊时用已知值反推:让设备输出一个你已经知道的量(比如在输入端加个标准信号),抓包拿原始四字节,穷举四种拼接看哪个对得上。第三,把确认结果写进点表备注,格式问题的坑不该每个接手的人都重踩一遍。第 2.5 节有一个完整的字节序排错实录,那里会用实例走完这三步。
⚠️ 常见坑:把"读回来的值差一个数量级"当成传感器坏了。先查量程换算(有的设备传整数、需除以十),再查字节序,最后才怀疑硬件——软件原因的概率远大于硬件漂移。
四、点表工程:让地址不再靠口口相传
寻址知识的最终归宿是点表管理。点表是 Modbus 世界里事实上的"语义数据库",它的管理成熟度直接决定项目后期的运维成本。三条实践标准值得固化进团队流程。
**其一,点表必须有版本与设备映射。**一张合格的点表头三行永远是:设备型号与固件版本、点表版本号与修订日期、依据手册的版本页码。没有这三行的点表,在设备固件升级那天起就自动变成"历史文献"——还能参考,不能全信。**其二,原始地址与换算地址并列。**每条点位同时记录设备手册地址、点表地址、报文偏移三个数字,录入时的换算当场留痕,后来的接手者不必再做差一推理。**其三,点表随点校验栏。**每个点位后面留一列"实测校验":录入完成后用已知值对照(2.5 的方法)核过一次,就打上核对人与日期。这张表看起来繁琐,实际录入时每点只多花十几秒,却把"差一与字节序"两类最高频故障拦截在交付之前。
把点表当成工程资产来管理,还有一个进阶收益:它是第 4 章映射表的直接上游。点表越干净,语义注入越省力——好点表是集成项目的地基,坏点表是所有后续工序的债务。
五、一次跨品牌合并点表的教训
两个品牌的从站并进同一点表时,最容易踩的坑不是地址冲突,而是同址异义:两家设备的保持寄存器 100 号,一家放的是放大十倍的温度整数,另一家放的是百分比原值。合并后画面"看起来都对",直到某个显示值在运行中突变才暴露。防这类错只需一条纪律:点表除地址外必须带物理含义、单位、换算三列,录入时逐行核对设备手册,缺任何一列的点位不许进组态——这与 4.2 的映射五要素是同一件事在单协议内的缩影。合并完成后做一遍全点表的已知值对照(2.5 的方法),一小时对表,省掉日后数周扯皮。
要点自查
- 四区模型:线圈与离散输入是位,保持与输入寄存器是字;"保持"可写、"输入"只读,控制权划界;
- 差一铁律:点表一基、报文零基,任何地址换算先做减一;
- 功能码定区域:01、02、03、04 分别对应四区,写命令时选错区域会被异常码 02 拒绝;
- 字节序四选一:32 位量的拼接方式无统一标准,手册加实测反推是唯一可靠路径。
下一节把前两节的规则放进实验:亲手抓一帧报文,逐字节验证你刚学的每个字段。