3.2 信息建模核心
3.2 信息建模核心
本节摘要:地址空间是 OPC UA 的心脏——数据不再是寄存器里的孤立字节,而是一棵自描述的节点树:对象收纳变量、类型约束语义、引用表达关系。本节带你像浏览文件目录一样读懂任何一台 UA 服务器的数据世界。
打开一个真实服务器的地址空间
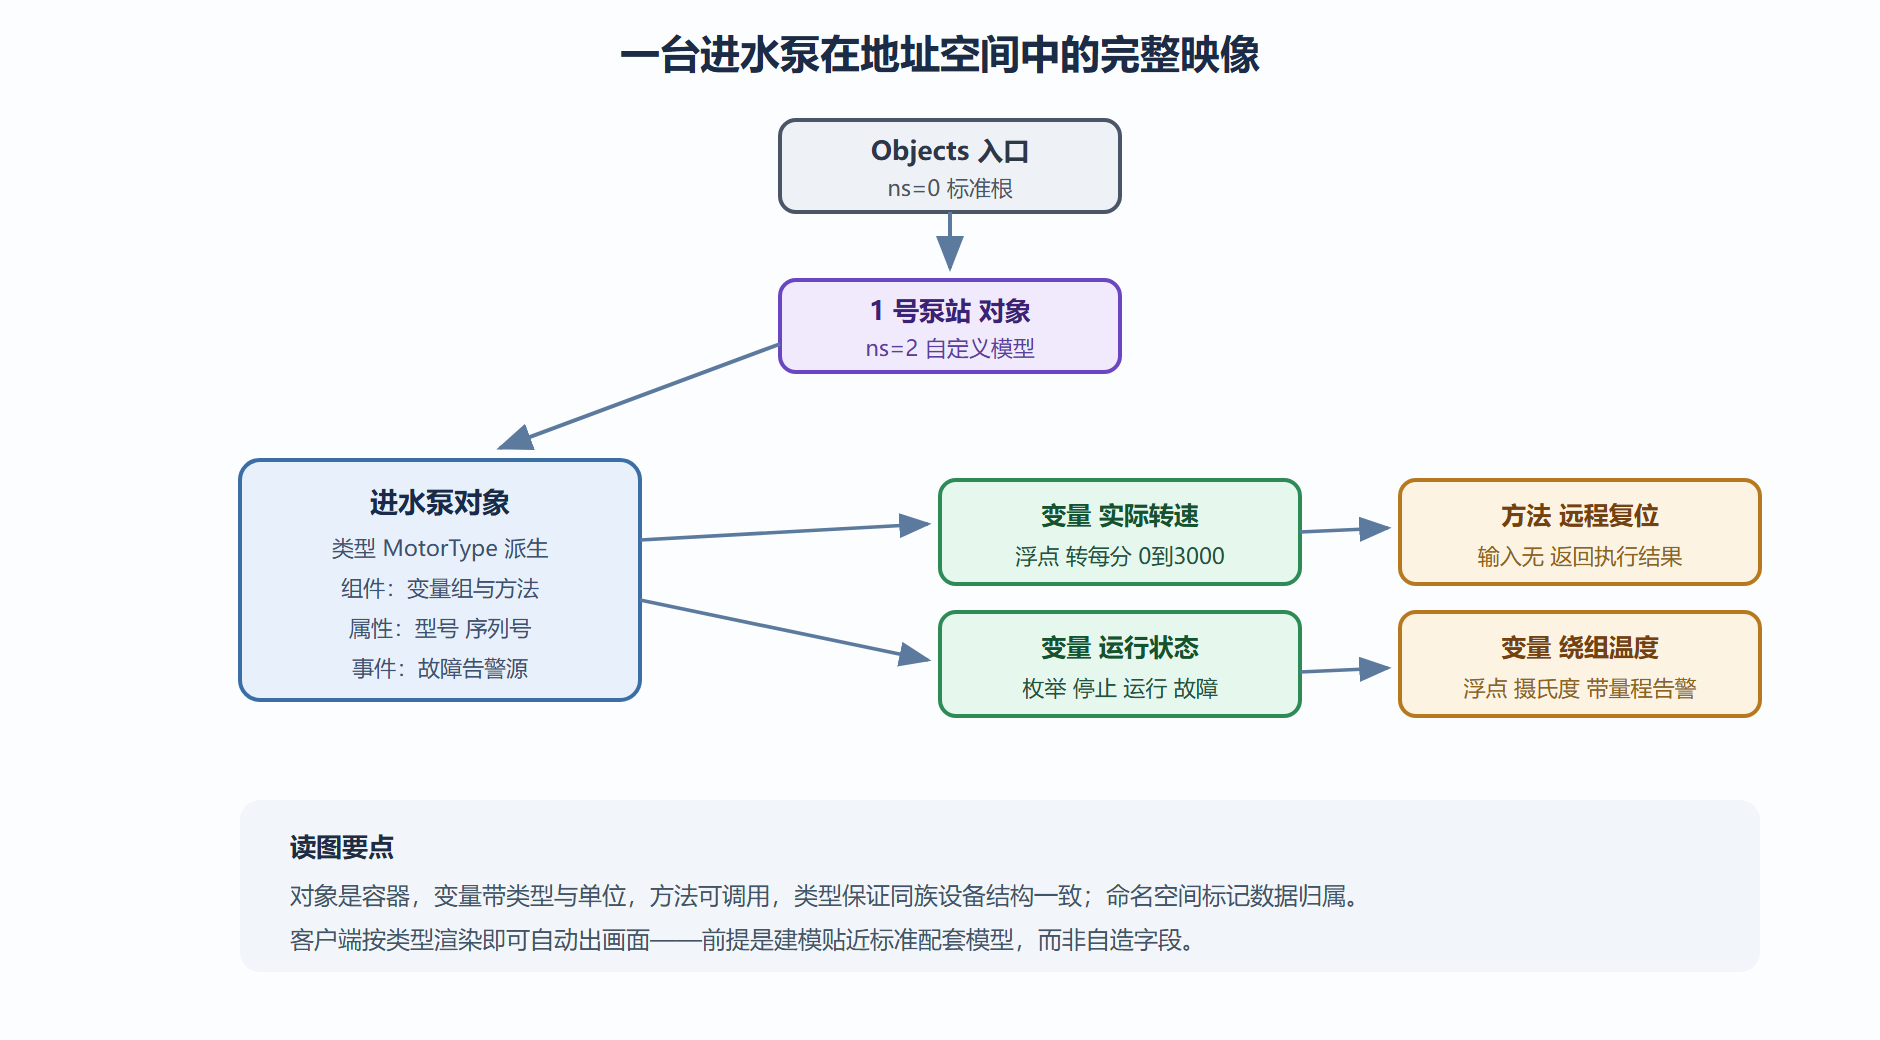
场景:你用客户端工具连上一台新到的 UA 网关,展开地址空间,看到一个树——根下有 Objects、Types、Views 几个固定入口,Objects 下面躺着"1 号泵站",点开是"进水泵"对象,对象下面挂着转速、温度、运行状态三个变量,还有一个"远程复位"的方法节点,再往下翻,设备型号、序列号、维护记录以属性形式挂在各节点上。没有任何文档,你已经看懂了这台设备的全部数据资产——这就是"自描述"的含义,也是它与 Modbus 点表最本质的区别:点表是人写给人的说明书,地址空间是数据自己携带的说明书。
本节的任务是把这棵树的构造规则讲透:节点有哪些种类、类型怎么约束语义、引用怎么表达关系。掌握这三样,任何陌生服务器的地址空间对你都不再有秘密。
学习目标
阅读完本节,你应当能够:
- 说出八类节点各自的职责与典型用法;
- 解释命名空间的编号规则与 NodeId 的构成;
- 用类型定义理解"这个变量为什么必须带单位";
- 通过引用关系在地址空间里找到数据的上下文。
一、八类节点:最小的积木套装
地址空间由节点构成,节点有八个种类,常用的其实只有五类。对象是容器,把相关的变量、方法组织成一个设备或功能单元;变量承载数据值,带数据类型、单位、时间戳、访问级别;方法是可被客户端调用的动作,比如"远程复位",可以有输入参数与返回值;对象类型与变量类型是模板,规定"泵应该有哪些变量""温度变量应该是什么类型、什么单位";引用是节点间的连线,表达"属于""产生于"" 与谁同类"这类关系。剩下的事件、视图、数据类型、参考类型四类节点服务于更专业的场景,初学阶段知道即可。
五类常用节点的分工可以用一个比喻串起来:对象是文件夹,变量是文件,方法是可执行程序,类型是文件夹与文件的命名规范模板,引用是超链接。你在一个精心建模的服务器里浏览,体验确实接近在一个组织良好的文件系统里找资料——而在一个偷懒建模的服务器里,体验就是一堆散落的文件。
NodeId 与命名空间是节点的身份证。每个节点有一个全局唯一的 NodeId,形如"命名空间号加标识"——ns=2 表示第 2 号命名空间,s=Pump.Station1.Motor.Speed 是字符串标识。命名空间解决的是重名问题:服务器自带的节点在 0 号命名空间(标准定义),厂商模型占 1 号,你自己的模型从 2 号往后排。跨服务器访问时,命名空间让"我这台设备里的转速"与"你那台设备里的转速"各自有主,不会混淆。浏览到陌生节点时先看它的命名空间,就能猜到它来自标准、厂商还是自定义模型。
二、类型:让语义可被机器校验
类型系统是"自描述"的真正来源。定义一个"电机类型",规定它必须包含额定电流、实际转速、运行状态三个变量,其中转速变量的数据类型是浮点、单位是转每分、量程是零到三千——此后这个类型派生的每台实例电机,都自动继承这套结构与约束。客户端拿到转速变量,读到的不只是数值,还有 DataType(类型声明)、EngineeringUnit(工程单位)、EURange(工程量程)三件套,单位错乱、量程越界这类故障在数据入口就被机器拦住,不再依赖人工在组态软件里逐点核对。
这套机制还有面向机器的另一半:符合规范的客户端可以读取类型定义,自动生成画面元素或数据管道。集成商常说"对接新设备不用改代码"——前提正是设备遵循了某个标准配套模型(比如机加工行业的配套规范),客户端按类型模板渲染,新设备插上即认。反之,如果厂商自己发明了一套字段名,客户端只能退回人工配置——模型的价值取决于它贴近标准模型的程度。
图11 地址空间一棵真实设备子树的构造
三、引用与浏览:关系的价值
引用是地址空间里最容易被忽视、却最能体现建模水平的设计。两个对象之间用"组成"引用表达整体与部件(泵站包含进水泵),用"产生于"引用把事件与来源对象绑定(故障事件产生于进水泵),用自定义引用表达业务关系(这台泵"服务于"三号水池)。客户端顺着引用浏览,得到的是有上下文的数据——找到故障事件,顺"产生于"一步就到问题设备,再顺"组成"反向知道它属于哪个泵站。Modbus 世界里这些关系只存在于工程师的脑子里与 Excel 里,OPC UA 把它们搬进了协议。
浏览服务的实际操作也基于引用:客户端从 Objects 入口出发,请求"列出该节点的所有引用",服务器返回相邻节点清单,客户端再逐层展开。你在客户端工具里看到的一层层树,就是浏览服务逐层拉取的结果。理解了这一点,你就明白为什么有的服务器"展开很慢"——地址空间深、引用多、服务器性能弱,三者叠加的结果,而不是网络问题。
💡 关键直觉:评估一台设备的信息建模质量,就看三处——变量有没有单位与量程、设备有没有类型定义、关系有没有用引用表达。三处俱全的模型可以机器理解;三缺二的模型只是"树形点表",集成时照样要人工补语义。
四、读模型的三步法与建模反模式
面对陌生服务器的地址空间,给一个可复制的三步法。第一步看命名空间:展开 Objects 入口,先分清哪些节点来自标准与厂商(低编号命名空间)、哪些来自项目自定义(高编号),心里画出数据的"户籍图"。第二步找类型:任意点开一个设备对象,查看它的类型定义——有类型且类型有内涵(组件、约束齐全)的模型才值得深入;没有类型的散装变量,说明这是一个"树形点表",心理预期要相应调低。第三步追引用:挑一个核心变量,看它有哪些引用指向兄弟节点与上下文——引用丰富的模型能用浏览代替查文档,引用贫瘠的模型每个数据都要问人。
三步之外,两个建模反模式提前认识,3.4 实战时不要再犯。反模式一叫**"垃圾桶对象":把所有塞不进现有结构的变量统统挂到一个"杂项"对象下,短期省事,长期这棵树就成了第二个点表——结构有了,语义没了。反模式二叫"过度嵌套"**:为每个技术细节都建一层对象,客户端浏览一个泵要点七八层,画面取一个值要遍历一串路径。建模的深度要跟着消费方的粒度走,而不是跟着设备的机械结构走。
再补一个建模之外的反模式:把地址空间当数据库表用。有团队把成千上万个变量平铺在一个对象之下,命名靠编号区分——浏览树退化成一张大表,类型信息荡然无存,机器校验无从谈起。解法仍是回到类型纪律:先分设备、再分功能块,变量挂在类型实例上,让层级反映物理与工艺结构,而不是录入顺序。判断一个地址空间建得好不好,有个一分钟检验:随便指一个变量,看它的完整路径能否读出"哪台设备、哪个部件、什么含义"——读不出来,就该重整了。
本节要点回顾
- 五类常用节点:对象是容器、变量承载数据、方法是动作、类型是模板、引用是关系连线;
- NodeId 与命名空间:全局唯一身份加归属标记,看命名空间即知节点出自标准、厂商还是自定义;
- 类型是语义的守门人:单位、量程、类型约束在数据入口由机器校验,不依赖人工核对;
- 引用给数据以上下文:组成、产生、业务关系进协议后,"顺着关系找数据"取代了"翻文档查点表"。
下一节看这些节点上的数据如何流动:会话、读写、订阅三件套的完整推演。