5.3 营销技术栈 MarTech
5.3 营销技术栈 MarTech
本节摘要:MarTech 的实质不是采购清单,而是一套认知建模能力——先回答「在同一个人身上发生了什么」,再回答「值不值得算」与「接下来做什么」。
从「买几套系统」到「认知操作系统」
用户今天在小红书被种草,明天在抖音刷到相关视频,转头到微信私域问客服,最后在电商下单、去微博发开箱帖。这一连串动作发生在五六个平台,企业要回答三个朴素的问题:这些行为是不是同一个人?哪次曝光真正推动了成交?下一次该在什么时机、用什么渠道再碰他?单靠任何一个平台的后台都答不上来——能把答案拼出来的,只有营销技术栈(MarTech)。
可现实是:2024 年 Gartner 的 MarTech 版图收录的活跃工具已超过 11000 款,年复合增长 18.7%,而企业 MarTech 投入产出的中位数却常年停在 2.3:1,跨系统数据真正打通的公司只有 29%。工具越买越多,认知没有变多——显微镜是顶配的,对焦的手艺没学会。
核心组件对照:各司其职,须集成
| 组件 | 主数据 | 核心能力 | 与谁易混淆 |
|---|---|---|---|
| CRM | 客户 / 商机 | 销售与服务流程管理 | MA |
| MA | 线索 / 行为 | 自动化旅程编排 | CRM |
| CDP | 第一方统一画像 | 身份解析、全渠道激活 | DMP |
| DMP | 匿名 / 第三方 Cookie | 广告投放人群包 | CDP |
这四样东西常被拆开讲,实际架构里早已彼此咬合。拿人体打比方:CDP 是心脏,负责把干净、统一的客户数据泵向全身;CRM 是大脑皮层,处理关系层面的判断与决策;MA 是自主神经,把决策送到各个执行末梢。任何一环堵住,整套系统都会罢工。
其中最容易踩混的是 CDP 与 DMP:DMP 做的是第三方数据的生意,聚合匿名 Cookie 卖人群包,服务于广告投放;CDP 管的是第一方数据的主权,把身份统一后供全链路个性化使用。隐私监管收紧之后,DMP 的价值一路走低,CDP 顶上了架构中心的位置——它不只是融合数据,还要负责给数据定规矩、定义其在业务里意味着什么。
三层耦合架构:数据基座、智能引擎、执行网络
| 层 | 回答什么 | 关键机制 | 例子 |
|---|---|---|---|
| 数据基座 | 数据在哪里 | 多源身份图谱、客户黄金记录 | CDP、埋点、MDM |
| 智能引擎 | 数据说明什么 | 行为分析、预测建模、实时决策 | ML 推荐、生存分析 |
| 执行网络 | 下一步做什么 | 旅程编排、程序化投放、服务协同 | MA、广告 API、CX |
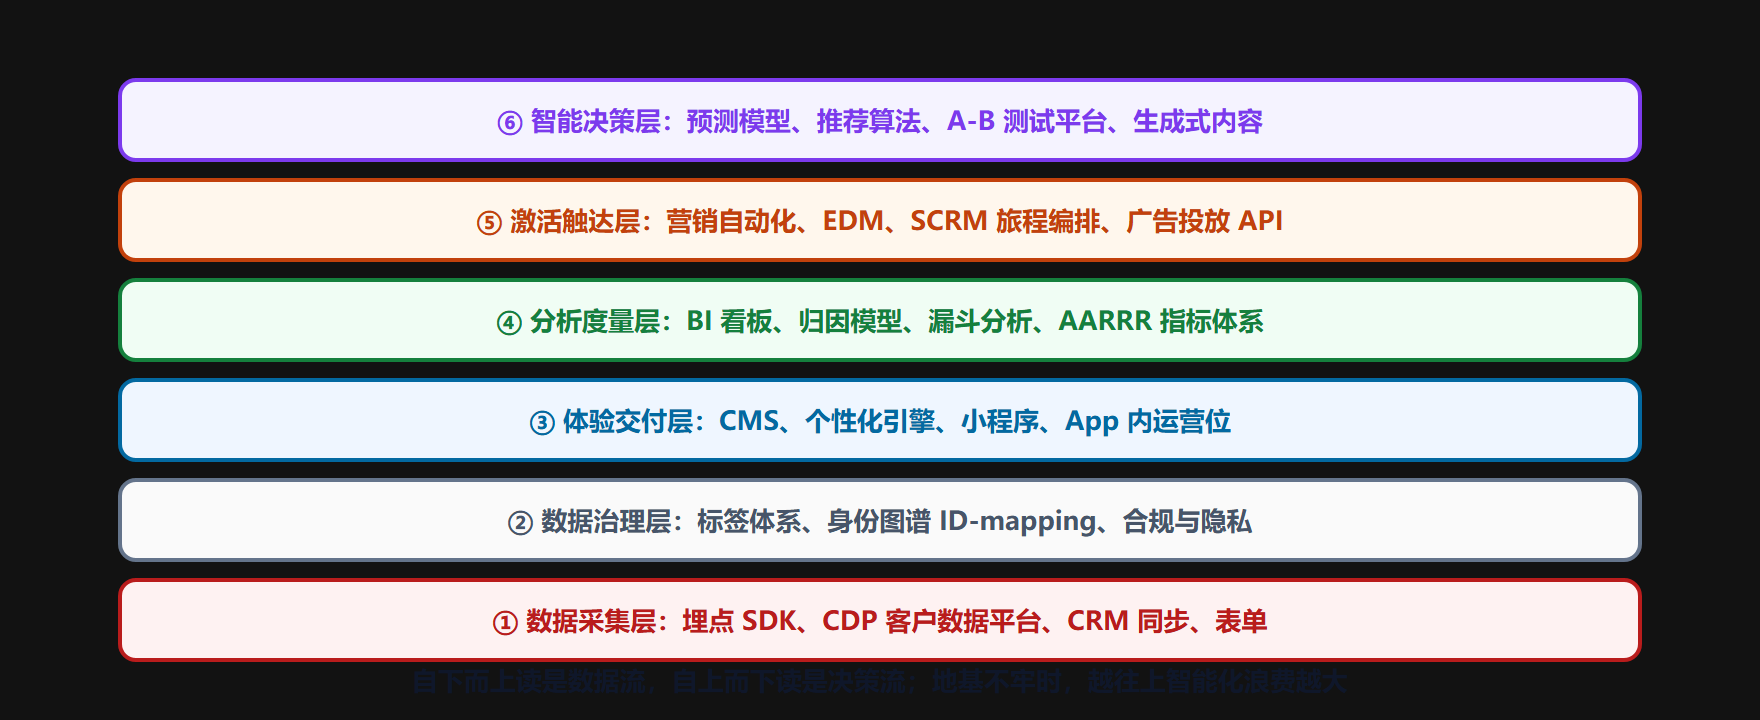
数据基座层的难点从来不在采集,而在两件事:把身份认对,把口径统一。Cookie 退场、iOS 隐私新政收紧之后,靠设备号追踪的老办法基本失效。现在的基座靠多源身份图谱立起来——设备指纹、手机号哈希、邮箱归一化等多路信号做概率匹配、按置信度加权,拼出一个跨渠道、跨设备、跨时间的「同一个人」。Gartner 的数据:CDP 部署成熟的企业,客户识别准确率上升 47%,跨渠道归因误差下降 63%。
智能引擎层三台机器并跑:行为分析引擎用图神经网络看行为序列的形状,区分「反复比价不下单的犹豫型」和「直播下单两小时后又加购的冲动型」;预测引擎用生存分析估 LTV,用 Cox 比例风险模型算每个服务触点对流失风险的边际贡献;实时决策引擎在毫秒级里把规则引擎的确定逻辑与强化学习的探索策略捏在一起,输出针对个体的干预动作。
执行网络层的价值不在「执行」二字,而在策略传下去不走样、跨域不打架。MA 在这里不是群发邮件的工具,而是旅程的实时调度台:预测引擎判断某用户正处在价格敏感的临界点,MA 便同时拉起三条线——私域推送限时券、公域信息流定向放性价比解析短视频、线下门店让店员备好试用装。同一策略意图,在每个渠道换成最合适的形态落地。
三层之间数据与指令双向流动,每次执行产生的反馈都作为新样本回流,模型随之滚动更新——这是 MarTech 与传统静态系统最大的区别:它会自己变好。
四重跃迁:从流程自动化到认知增强
| 层级 | 特征 | 示例 | 价值性质 |
|---|---|---|---|
| 操作自动化 | 消灭重复劳动 | 自动欢迎邮件、弃购提醒 | 效率(约省 35% 人力) |
| 旅程编排 | 读得懂上下文 | 浏览 3 分钟后触发三段式旅程 | 场景化 |
| 预测式互动 | 引入时间与概率 | 换机概率 0.82,提前 14 天启动体验计划 | 前瞻性 |
| 认知增强 | 说得出「为什么」 | XAI 展示决策依据、主动发起认知挑战 | 组织智能 |
顶端那一层值得展开:系统不止给动作,还给理由——用可解释 AI 把依据摊开,「这类用户同时带着价格敏感与技术参数偏好两个标签时,此优惠组合的接受率高 41%」。再往上一层,系统会主动挑事:发现某区域门店转化率连续 5 周垫底,它不直接开药方,而是把对比报告和最佳实践案例库推给你。到这个阶段,MarTech 已经不是工具,而是组织集体学习的基础设施。
选型原则:先问 use case,再选 logo
MarTech 圈最大的浪费,是把顺序做反——先买系统,再找用途。正确顺序是倒着来:
# MarTech 选型:从 use case 倒推组件,不从 logo 正推 def martech_selection(business_question): # 每个业务问题映射到最小必需组件集 mapping = { "跨渠道识别同一客户": ["CDP", "身份图谱"], "线索孵化与旅程自动化": ["MA", "CRM"], "销售线索评分与分配": ["CRM", "预测引擎"], "广告人群包投放": ["DMP", "程序化平台"], } print(f"业务问题:{business_question}") print("最小必需组件:", " → ".join(mapping.get(business_question, ["先定义问题!"]))) questions = ["跨渠道识别同一客户", "销售线索评分与分配", "想上一个最火的中台"] for q in questions: martech_selection(q)
第三行输入会原样暴露问题:问题本身没定义清楚时,任何组件都无从谈起。先写出真正要解决的三个业务问题,再倒推缺哪几块拼图;照着厂商地图整柜采购,大概率只能复现那个 2.3:1 的平庸 ROI。
图 5-3 营销技术栈分层架构:从数据地基到智能决策的六层栈
⚠️ 常见坑:只买不连——互不打通的数据孤岛比没有工具更糟,一堆不集成的系统只是昂贵的摆设。
💡 关键直觉:MarTech 的终极命题是在算法时代守住人的位置——机器负责「可知」的计算,人负责「可感」的创造。
归因模型的选择本身就是一次决策,两种口径对同一批数据的读数差异可以大到推翻预算结论:
# 同一批触点数据,两种归因口径的对比 def compare_attribution(touches): # touches: [(渠道, 是否末次触点)] n = len(touches) last_touch = {} linear = {} for c, is_last in touches: if is_last: last_touch[c] = last_touch.get(c, 0) + 1 linear[c] = linear.get(c, 0) + 1 / n channels = sorted(set(c for c, _ in touches)) print(f"{'渠道':<10}{'末次归因':>8}{'线性归因':>8}") for c in channels: print(f"{c:<10}{last_touch.get(c, 0):>8.0f}{linear.get(c, 0):>8.2f}") compare_attribution([ ("KOC种草", False), ("搜索广告", False), ("品牌官网", False), ("直播", True), ])
实操清单:搭建你的 MarTech 最小闭环
- 写下业务里最疼的三个数据问题,按识别 / 预测 / 触达分类。
- 用「use case → 组件」映射倒推最小必需集,砍掉一切炫技采购。
- 体检数据基座:跨渠道身份图谱建了没有?黄金记录谁来维护?
- 给最疼的问题配一个预测式互动动作,比如流失预警触发挽回旅程。
- 起草第一方数据契约:采集目的、使用边界、保留期限、删除通道各写一条。
一节小结
- CRM/MA/CDP/DMP 分工不同且必须集成,CDP 与 DMP 是两代物种
- 三层架构:基座管身份,引擎管含义,网络管落地,反馈让系统自进化
- 隐私时代第一方数据是主资产,身份图谱接替 Cookie
- 应用沿「自动化 → 编排 → 预测 → 认知增强」四阶爬升,人始终是最终决策者
- 选栈先问 use case 再看 logo,最小闭环优于大而全
第 5 章到此完成「渠道 + 内容 + 技术栈」三层拆解。回到教程开篇那句话:4P 是界面,价值共构才是本体——数字生态第一次让这套界面获得了实时、可测、可进化的操作系统。