2.3 神经编码与解码原理:信息怎么写进去,怎么读出来
2.3 神经编码与解码原理:信息怎么写进去,怎么读出来
本节摘要:神经编码研究"意图如何变成放电模式"——放电率、放电时序与群体活动是三种主要载体;解码则是它的逆问题:从观测到的活动反推最可能的意图。本节讲清三种编码方式与对应解码策略的配对关系,用一段可运行的群体向量代码演示最直观的解码,并解释闭环使用如何让编码本身随时间改变。
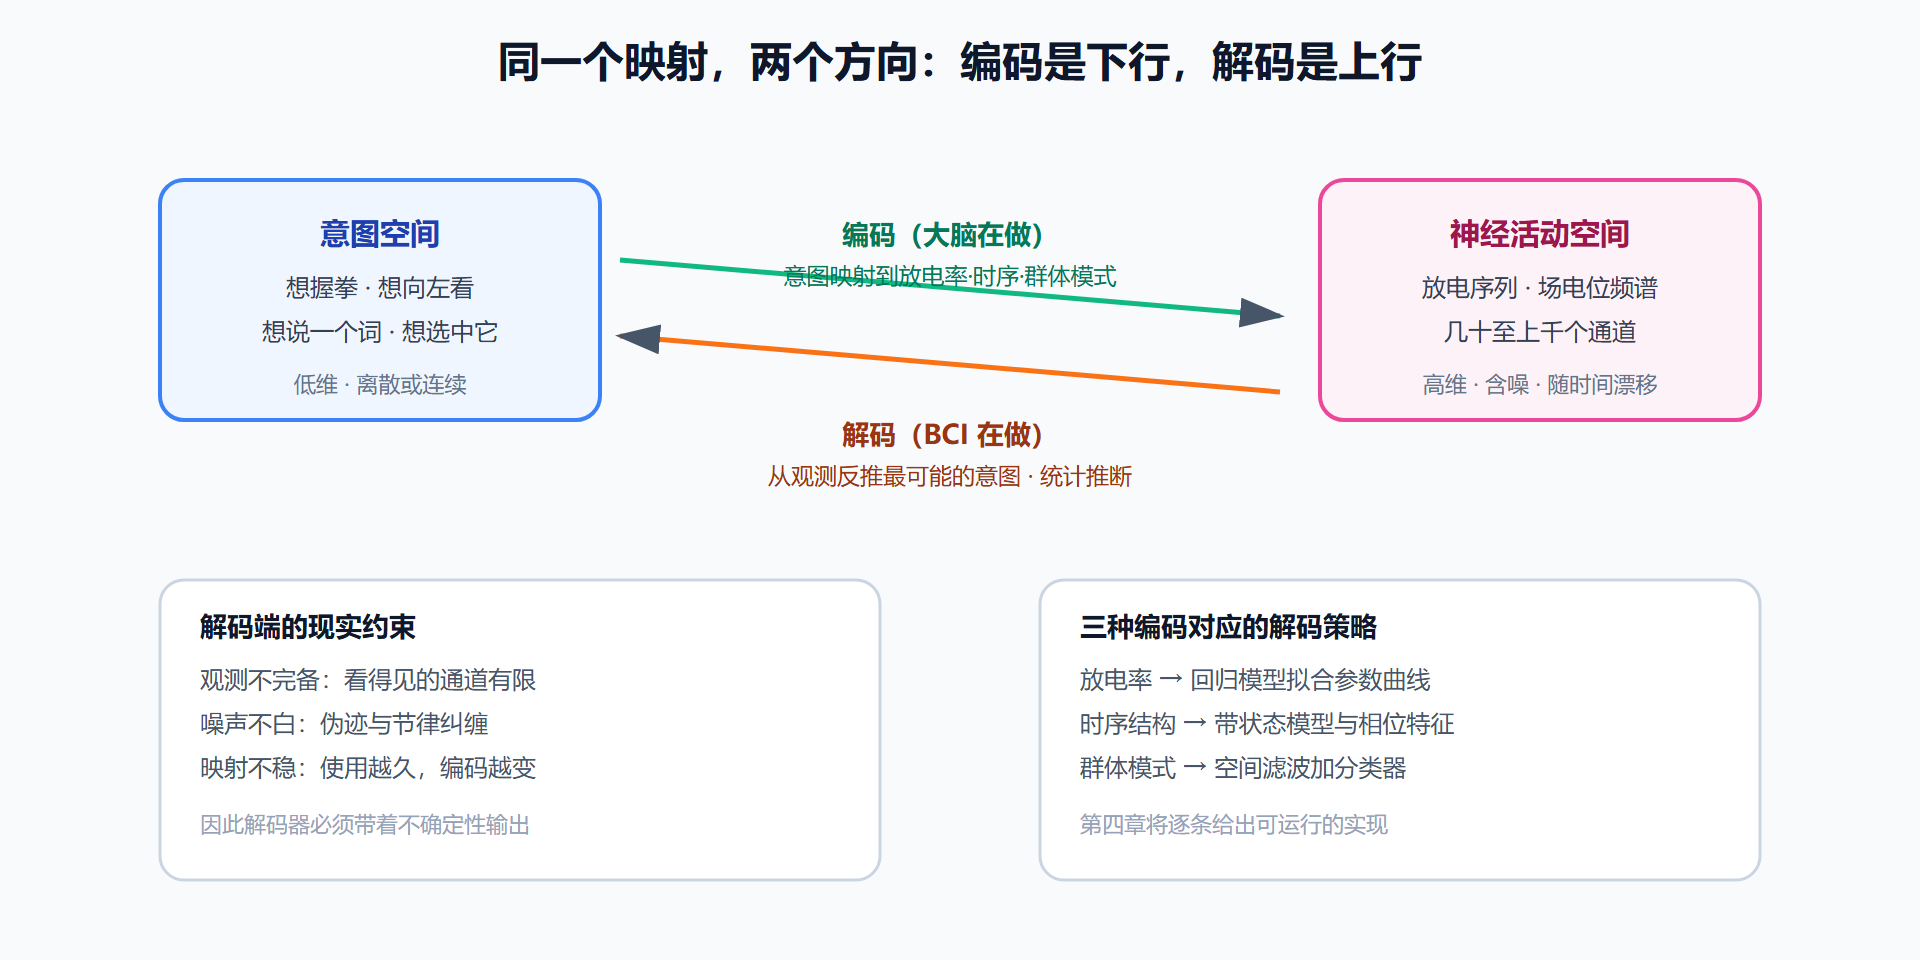
"编码"在日常语境里常被当成"大脑写给世界的密码本",仿佛存在一张固定的对照表。工程视角下更准确的理解是:编码是一种统计规律——某个意图出现时,神经活动在概率上呈现某种模式;解码不是查表,而是在噪声里做统计推断。这一字之差,决定了第四章所有算法的设计逻辑。
三种编码载体
放电率编码是最早被确认、也是使用最广泛的载体:单个神经元的放电频率携带信息。运动皮层里,偏好多方向的神经元会随手臂移动方向与自身偏好方向的夹角调整放电率——方向越合拍,放电越密。它简单、稳健,对皮层内记录尤其友好;缺点是时间代价高,要累积几百毫秒的放电才能估准一个频率。
时间编码关注放电的精确时刻:脉冲落在节律周期的哪个相位、几个神经元放电的先后次序,都可能携带放电率之外的增量信息。海马体的相位进阶是经典证据;皮层工作里,高频段的相位耦合对运动参数的解码贡献已被多项研究确认。它信息密度高,但对采样精度和时间对齐的要求苛刻——这正是皮层内电极与头皮脑电在解码上限上拉开差距的另一个原因。
群体编码是现代脑机接口真正的主力:单神经元的信息不可靠,但一群"各有所好"的神经元合起来,信息就又多又稳。方向解码的经典机制是群体向量:每个神经元投票给自己偏好的方向,票数由其当前放电率加权,所有票合成一个向量,就是群体"认为"的方向。单个神经元像 noisy 的选民,几百个选民的加权投票能精确到几度。头皮脑电没有单神经元可选,但几十个导联的空间模式(哪块头皮电位强、相位如何)构成它的"群体"——共空间模式等算法找的正是这种群体区分模式。
图 2-3:编码与解码的镜像关系
亲手解一次码:群体向量
空谈不如手算。下面这段代码模拟二十个"偏好方向不同"的运动皮层神经元,从它们的放电率读出手臂运动方向——把解码问题还原到最纯粹的形态。
import numpy as np rng = np.random.default_rng(42) n_neurons = 20 pref_dirs = rng.uniform(0, 2 * np.pi, n_neurons) # 每个神经元的偏好方向 base_rate, gain = 10.0, 30.0 # 基线放电率与调制深度 def encode(true_dir): """编码模型:放电率随方向与偏好方向的夹角余弦调制""" rates = base_rate + gain * np.cos(pref_dirs - true_dir) return rng.poisson(rates) # 放电计数是泊松过程 def decode(counts, t=0.5): """解码模型:群体向量——以放电率为权重的偏好方向合成""" est_rates = counts / t weights = np.clip(est_rates - base_rate, 0, None) vec = np.sum(weights[:, None] * np.stack( [np.cos(pref_dirs), np.sin(pref_dirs)], axis=1), axis=0) return np.degrees(np.arctan2(vec[1], vec[0])) % 360 truth = np.radians(70) # 真实方向:70 度 counts = encode(truth) print("各神经元放电计数:", counts) print("解码方向: %.1f 度, 真实方向: 70.0 度" % decode(counts)) # 典型输出:解码方向约 66 至 74 度——单次观测就有几度内的精度
三件事值得注意。其一,编码模型先于解码模型存在:只有假设了"放电率随偏好方向余弦调制",群体向量这个解码器才成立——解码假设错,精度立刻崩。其二,噪声模型也是假设的一部分:泊松计数描述放电的随机性,更精细的解码会把这个不确定性算进推断里(贝叶斯滤波,见第四章)。其三,把神经元数从二十加到二百,精度会继续爬升——这正是侵入式阵列不断堆通道数的统计学理由。
编码不是刻在石头上的
本节开头说编码是统计规律而非密码本,还要补上更重要的一半:这个规律本身会漂移。用户学会使用脑机接口的过程,就是大脑主动调整编码规律让解码更容易的过程——几周练习后,控制相关的神经活动模式变得更"可分",部分研究者把这称为解码器与大脑的"共驯化"。工程后果在本册会反复出现:校准不是一次性事件(4.4 节),用户训练是系统的正式组成部分(6.4 节),而"长期稳定性"因此成为第七章监管审查的硬指标。
把不确定性写进输出
要点回顾之前,把"输出应附带不确定性"这条展开成一节,因为它是初学者最常忽略的设计纪律。从群体放电反推意图,本质是用有限的高维含噪观测猜一个低维隐变量——猜,就有错的可能。成熟的解码器因此不输出"用户想右移",而输出"右移的概率零点八七",置信度连同方向一起交给下游;闭环系统再用置信度决定动作的激进程度:把握大就执行,把握小就降速、求确认或维持现状。这个设计把错误从"灾难"降级为"可管理的风险",第五章的闭环架构与第七章的责任认定都建立在它之上。反面教材是只输出硬判断的管线:它等于把每一次解码错误都直接转嫁给系统里最没有防御能力的环节——用户,而且事后无法追溯"当时系统到底有多确定"。4.3 节会讲置信度如何校准得可信,这里的任务是先立住观念:概率输出不是学术洁癖,是安全设计的起点。
本节要点回顾
- 三种载体:放电率(稳健、慢)、放电时序(高密度、苛刻)、群体模式(主力、可扩展);
- 解码即推断:从高维含噪观测反推低维意图,输出应附带不确定性;
- 编码解码成对设计:解码器的假设里内嵌着编码模型,假设错则全错;
- 编码会漂移:闭环使用重塑编码规律,自适应与训练由此成为必备组件。
载体与规律都清楚了,还差最后一块拼图:这些信号有哪些可量化的"体检指标"?下一节盘点频带、电位成分与信噪比的敌人名单。