5.1 开环与闭环系统:考试与对话
5.1 开环与闭环系统:考试与对话
本节摘要:开环是系统单向读脑的"考试"——用户按提示做、系统打分,输出不影响输入,校准与筛查都依赖它;闭环是双向影响、共同学习的"对话"——用户看着结果调整脑活动,系统观察着用户更新模型。两种模式不是先进程度的排序,而是各司其职:校准必须在开环下做,长期使用必须进闭环。本节讲清两者的机制、各自的陷阱,以及闭环特有的一个反直觉风险——用户可能学会迁就系统的错误。
一个反例能最快说清两种模式的差别。设想一个运动想象训练系统,为了"避免用户分心",训练全程不给任何反馈:用户想象左手或右手,系统默默记录,一个月后做总评。结果多半令人沮丧——用户一直在按自己发明的办法"想象",而其中很大一部分策略根本不产生可解码的信号差异。没有反馈,用户不知道哪些念头有用、哪些是白费劲;学习无从发生。这个反例里的问题不是算法,是结构:它把一场需要对话的训练,办成了一场哑剧考试。
开环:一切校准的地基
开环(无反馈、提示驱动)的定义很朴素:系统记录并解读脑信号,但解读结果不回传给用户、不影响后续输入。它存在的理由是"标签的纯净性"——屏幕提示"想象右手"时,这一试次的真实标签就是确定的,不管用户做得好不好,数据都带着已知答案。第四章所有模型的初始校准都建立在这种数据上。
开环还有第二个用途常被低估:筛查。在正式校准前跑一轮开环测试,检查用户的节律调制能力(想象握拳时缪节律凹得深不深)、各通道信号质量、伪迹水平,几分钟内就能判断"这个人适不适合这个范式、哪个通道该重贴"。把它流程化,能省掉大量无效校准时间——5.6 节排错实录的第一步永远是它。
闭环:学习发生的地方
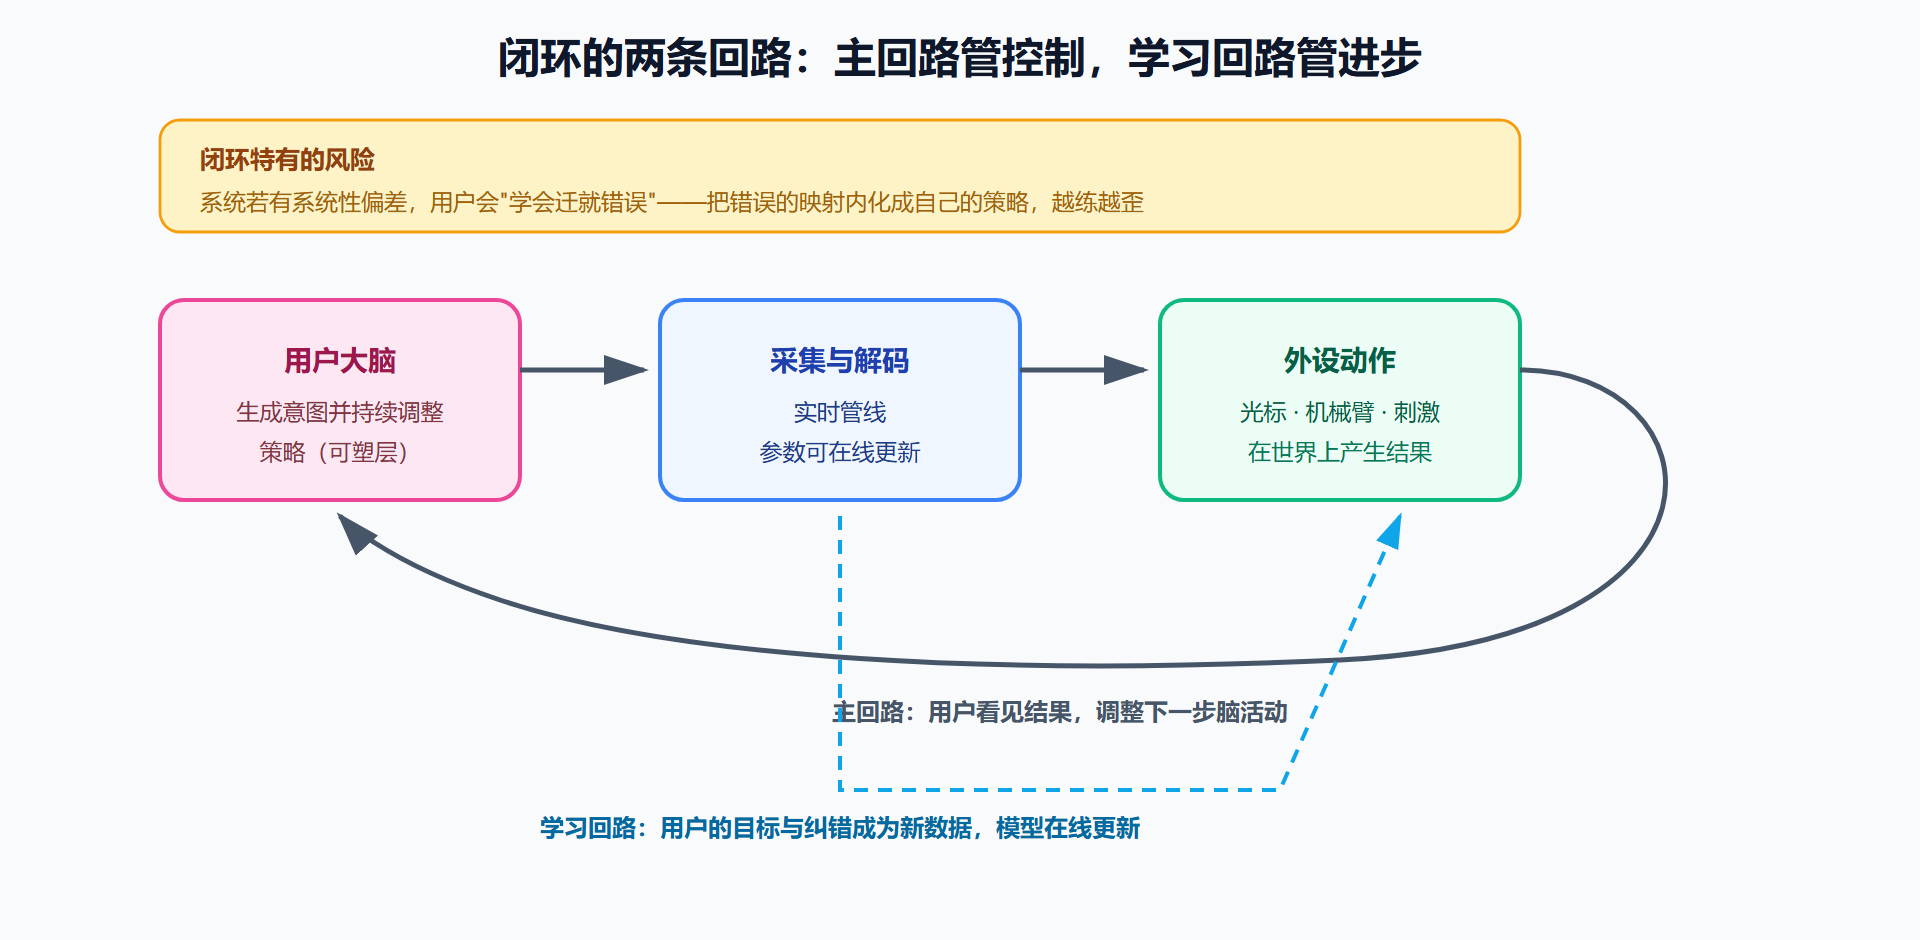
闭环(有反馈、双向影响)里,系统的输出实时回到用户眼前,用户的脑活动随之调整,形成回路。这个回路里藏着脑机接口最重要的学习机制。其一,操作性塑造:1.2 节里那只学会用单个神经元拨指针的猴子,就是在闭环反馈下把原本无意义的放电模式"炼"成了控制信号——人类用户同理,几周训练后控制相关的神经活动模式变得比校准初期更可分。其二,用户的纠错行为:光标偏了,用户下意识地"再推一把"——每一次纠错都是一份高质量数据,系统若能利用(4.4 节的目标即标签机制),等效于持续的免费校准。其三,动机与信任:可见的进步是用户坚持训练的最大燃料,这一点在康复场景里价值连城。
图 5-1:闭环系统的部件与两条回路
闭环的反直觉风险:学会迁就错误
图上那条黄色警示值得单独展开。闭环的好处来自双向学习,但双向也意味着坏映射也能被学会。假设解码器把"想象右手"系统地误读为光标右移加下移,用户很快会发现"想要右移就想象右手、想要下移也想象右手"——他不再纠正系统,而是改写自己,把系统的错误内化成个人策略。训练分数在涨,实际的控制能力在歪。这种现象在有噪声、有延迟、有系统性偏差的系统里都会发生,且几乎不可逆:迁就策略一旦固化,换一套更准的系统反而要重新适应。
工程对策由此明确:闭环训练前,先在开环下把系统性偏差清零。校准要充分、混淆矩阵要检查(若某两类长期互混,先修特征再进闭环)、延迟要压到可感阈值之下(5.3 节)。闭环是对话,但对话开始前,双方要先就"语言"达成一致。
两种模式的分工表
| 维度 | 开环 | 闭环 |
|---|---|---|
| 标签来源 | 屏幕提示,完全纯净 | 用户目标与纠错,需甄别 |
| 适用阶段 | 筛查、初始校准、范式验证 | 训练提升、日常使用、自适应 |
| 用户状态 | 被动配合,易疲劳 | 主动参与,动机强 |
| 数据风险 | 标签纯净但分布单一 | 数据量大但混有系统错误 |
| 典型时长 | 每会话几分钟 | 持续使用全程 |
表的最后一行提示了实际系统的形态:开环与闭环不是二选一,而是每次会话的固定节奏——开场几分钟开环微校准(追上今天的状态,4.4 节),随后转入闭环使用,全程在线自适应。
顺着分工表再补一条实践中最常被问到的边界:半闭环算什么。真实系统里常见一种中间态——反馈存在,但被刻意降级:光标只显示方向不显示偏差、结果延迟几秒才告知、或只显示成功不显示失败。这不是偷懒,而是把反馈当作可调参的训练变量:反馈的信息量随用户水平逐级开放,和运动教学里"先带做、再陪练、后放手"的次序同构。6.4 节手记里"变连续反馈为间歇反馈"的破平台手段,就是半闭环的一次实战应用。判别一个反馈设计是否合理,有一条现成的试金石:反馈越少,标签越纯,学习越慢;反馈越多,学习越快,被污染的风险越高——每个系统都要在这条斜线上找自己的当前位置,而且这个位置应随用户成长动态移动。
一次会话的标准结构
把开环与闭环的分工落成一个可复用的会话模板,是本节最实用的交付。一个结构良好的训练或使用会话通常分四段。开场体检(约两分钟):记录一小段静息数据,对比当日与历史基线的功率谱形态——任何异常(某个通道噪声陡增、节律整体偏移)都在这一段被拦截,省掉后面的无效训练,这套检查正是 5.6 节排错表的"日常版"。微校准(约三到五分钟):一段开环提示任务,攒出今天的带标签小样本,把模型参数追到用户当前状态。主体训练或使用(二十分钟上下):闭环运行,期间穿插简短的开环"锚点试次"(每十分钟左右嵌入几个已知答案的试次),用它们持续监测真实准确率——这是自适应不跑偏的保险丝。收尾归档(两分钟):记录当日会话的参数版本、性能摘要与异常事件。四段结构的精髓在于开环与闭环交替出现:开环提供真相基准,闭环提供学习动力,缺了前者系统会漂而不自知,缺了后者用户学而不精进。第一次设计会话流程的团队,照这个模板起步几乎不会错。模板里的时长都是可调的,唯独"开场体检不可省"这条建议保持刚性——训练效果可以慢慢来,带着坏数据训练一小时,坏的不只是那一小时。
本节要点回顾
- 开环保标签纯净:校准与筛查必须开环做,输出不回传是特性不是缺陷;
- 闭环是学习引擎:操作性塑造、纠错即数据、动机燃料,三重机制都在回路里;
- 迁就错误是闭环的头号陷阱:进闭环前先清零系统性偏差,混淆矩阵与延迟是两道闸;
- 会话节奏:开环微校准开场,闭环使用为主体,自适应贯穿全程。
对话的通道打通了。下一节修回程的路:把机器的动作变成大脑能感知的信号——反馈技术。