5.3 慢性病膳食干预的证据金字塔
5.3 慢性病膳食干预的证据金字塔
本节摘要:慢性病膳食干预的证据呈金字塔结构——顶端是随机对照试验与系统综述,中层是大型队列,底层是机制推断。营养流行病学的三大陷阱(健康使用者效应、替代行为混淆、单营养素还原)反复制造"反转新闻"。本节把前两节的分级实践上升为一张可复用的金字塔地图。
本节带着旧编号 56122 的家底(原"营养相关慢性疾病"一节)加入本章,任务是收束:把 5.1 与 5.2 用过的分级动作固化成一张金字塔地图,并回答那个流传最广的抱怨——"营养学怎么老是自打脸"。
金字塔的六层结构
| 层级 | 证据形态 | 能支持什么 | 不能支持什么 |
|---|---|---|---|
| 塔尖 | 系统综述与荟萃分析 | 汇总后的总体效应方向 | 修复原始研究的系统性缺陷 |
| 第二层 | 大型随机对照试验 | 因果推断(如 PREDIMED 与 DASH) | 罕见终点与超长期随访 |
| 第三层 | 大型前瞻性队列 | 长期关联与剂量趋势 | 因果(混杂无法根除) |
| 第四层 | 病例对照与横断面 | 假设生成 | 任何因果表述 |
| 第五层 | 动物与细胞实验 | 机制通路 | 人体剂量与结局 |
| 塔基 | 理论推演与个案 | 研究方向 | 一切公共建议 |
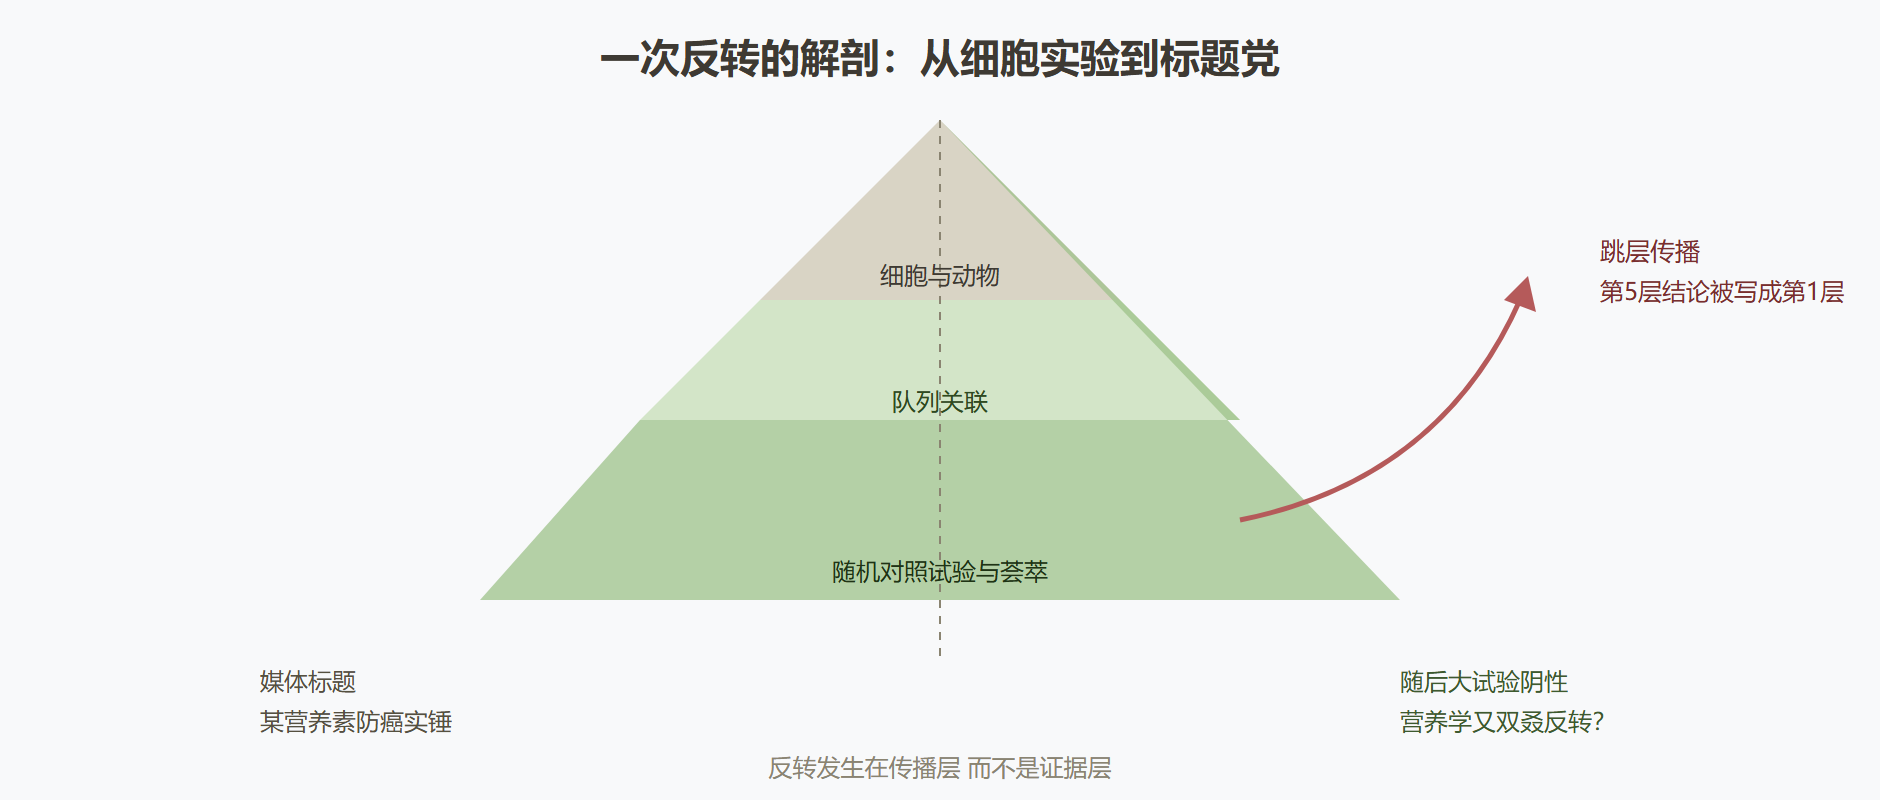
审计的使用方法:拿到任何"研究显示",先问它住在第几层,再问它的样本量与随访时长,最后问结论措辞是否越层。越层是营养学传播的头号事故源——塔基的细胞实验被写成塔尖的"科学证实"。
三个反复制造"反转"的陷阱
陷阱一:健康使用者效应。 喝咖啡的人与喝含糖饮料的人、吃坚果的人与吃薯片的人,本就在吸烟率、运动量、体检频率上系统不同。队列研究校正已知混杂后仍会残留——"每天两杯咖啡降低死亡率"类标题的相当一部分差距,来自喝咖啡的人同时做着别的对的事。
陷阱二:替代行为混淆。 "少吃红肉的人心脏病少"可能因为她们把红肉换成了豆类鱼禽——也可能只是换成了同样糟糕的精制淀粉。营养暴露永远嵌在"换成什么"的语境里,第 2 章饱和脂肪一节的"替换逻辑"正是这个陷阱的解药:读任何膳食风险结论,必须问对照物是什么。
陷阱三:单营养素还原。 β-胡萝卜素的食物证据耀眼,吸烟者大剂量补充试验却出现肺癌上升;维生素E的食物关联正面,单体试验屡屡落空。食物矩阵里数以百计的成分以低剂量共存,被提取成单一高剂量后走的是完全不同的药理场景。三次范式跃迁(第 1 章)给出的方向一致:研究的未来在整体膳食与食物矩阵,不是继续拆单体。
💡 关键直觉:营养学没有"自打脸",打脸的是把第几层证据说成第几层结论的传播链条。同一批研究,在学术论文里的措辞(关联、提示、待验证)与在标题里的措辞(证实、防、致癌)之间,隔着一整座金字塔。
慢病干预的主流结论格局
用金字塔校准后,慢病膳食干预的稳定结论可以列得很短——但每一条都站得住:
- 限钠降血压:随机试验加荟萃,塔上层,剂量反应清晰(DASH 加限钠为叠加项);
- 整体膳食模式改善心血管风险:地中海与 DASH 型模式的随机试验证据(5.1 节);
- 含糖饮料与体重及代谢风险:队列一致加机制清晰加干预试验支持,跨层印证;
- 全谷物与膳食纤维:队列证据量大且一致,机制(血糖负荷、菌群底物)并行;
- 反式脂肪:机制加代谢加队列三层吻合,政策已落地(第 2 章);
- 单一维生素与矿物质补充预防慢病:除特定缺乏人群外,大型试验反复阴性——这正是"食物矩阵优于单体"的反面证据。
这份清单的另一面同样重要:烟酰胺、维生素D、硒等曾因队列数据亮眼而进入大型干预试验的营养素,多数没能复制队列看到的获益。每一个这样的案例都是"第四层证据不能直接跳到公共建议"的教学样本。
图:一次"营养学反转"的解剖
把金字塔装进口袋:三问审计法
第一问 这条结论住在第几层? 关键词嗅探:证实/预防 → 应有随机试验;关联/相关 → 队列;可能/有望 → 机制层 第二问 对照物是谁? 减少X的获益,取决于增加的是什么(替换逻辑) 第三问 对象是谁、剂量多少、多久? 人群均值结论不自动覆盖老人孕婦患儿与极端执行者
常见问题快答
看到一条新研究,怎么三十秒内定位它的层级? 看三个词:受试者被"随机分配"到组(第二层及以上)、"随访了多少人多少年"(队列的底气所在)、有没有"荟萃"或"系统综述"字样(塔尖)。标题里只有"研究发现"而三词全无的,默认按第五层处理。
营养流行病学这么容易混淆,还能信吗? 能,但要按它的规矩用:队列给出的是"优先级线索"(哪里值得做试验),不是"行动指令"。当多个独立队列方向一致、剂量趋势清晰、且机制通路并行时(如含糖饮料、反式脂肪),可信度显著上调——这正是"三角互证"的用法。
为什么医生说的和网上说的差这么多? 医生按指南说话,指南只采纳塔上层;传播链为了传播效率常直接引用塔基。两者不是对立,而是同一个证据体系的不同层被不同人引用。用三问法问医生来源,多数分歧当场消失。
"对人有效"和"对我有效"怎么桥接? 中间隔着两层:人群结论覆盖你的程度(你在研究人群的分布里吗),与你自身基线(第 1 章评估)。所以个体化的正确姿势是"在证据方向上小步执行、用自己的指标复查"——第 7 章的闭环就是为桥接而设计的。
同一研究被两边引用怎么办? 常见:同一篇队列论文,正方引"显著相关",反方引"关联微弱"。两个引文都没撒谎,差别在效应量的呈现方式(相对风险与绝对风险的落差)。此时回到原文的数字:每万人年的事件差是多少,再决定它值不值得改变行为——相对风险的百分比最容易放大微小效应。
要点回顾
- 证据金字塔六层,越层传播是"营养学反转"的真正发生地;
- 三大陷阱:健康使用者效应、替代行为混淆、单营养素还原,读队列结论时逐一排查;
- 慢病干预的稳定结论清单不长,但每条跨层印证:限钠、整体模式、控含糖饮料、全谷物纤维、反式脂肪;
- 单体补充预防慢病屡屡阴性,是"食物矩阵优于单体"最有力的反面教材;
- 三问审计法(第几层、对照物是谁、对象剂量时长)可以装进口袋随身携带。
至此饮食法审计完成。第 6 章换轴:同一份证据落在不同人生阶段与生活场景,结论如何改写。