9.1 精准营养与组学技术
9.1 精准营养与组学技术
本节摘要:组学技术把个体差异变成可测量的数据:营养基因组学已沉淀少数稳健位点(咖啡代谢、乳糖酶持续性、叶酸代谢),微生物组解释了餐后应答差异的重要份额,连续监测提供了高频反馈。但"可用于临床决策"与"可用于研究"之间仍隔着验证距离——消费级报告的信息含量需要逐层审计。
终章第一节。第 1 章第三次范式跃迁许下的愿,在这里对账。
基因组层:五个稳健位点与它们的边界
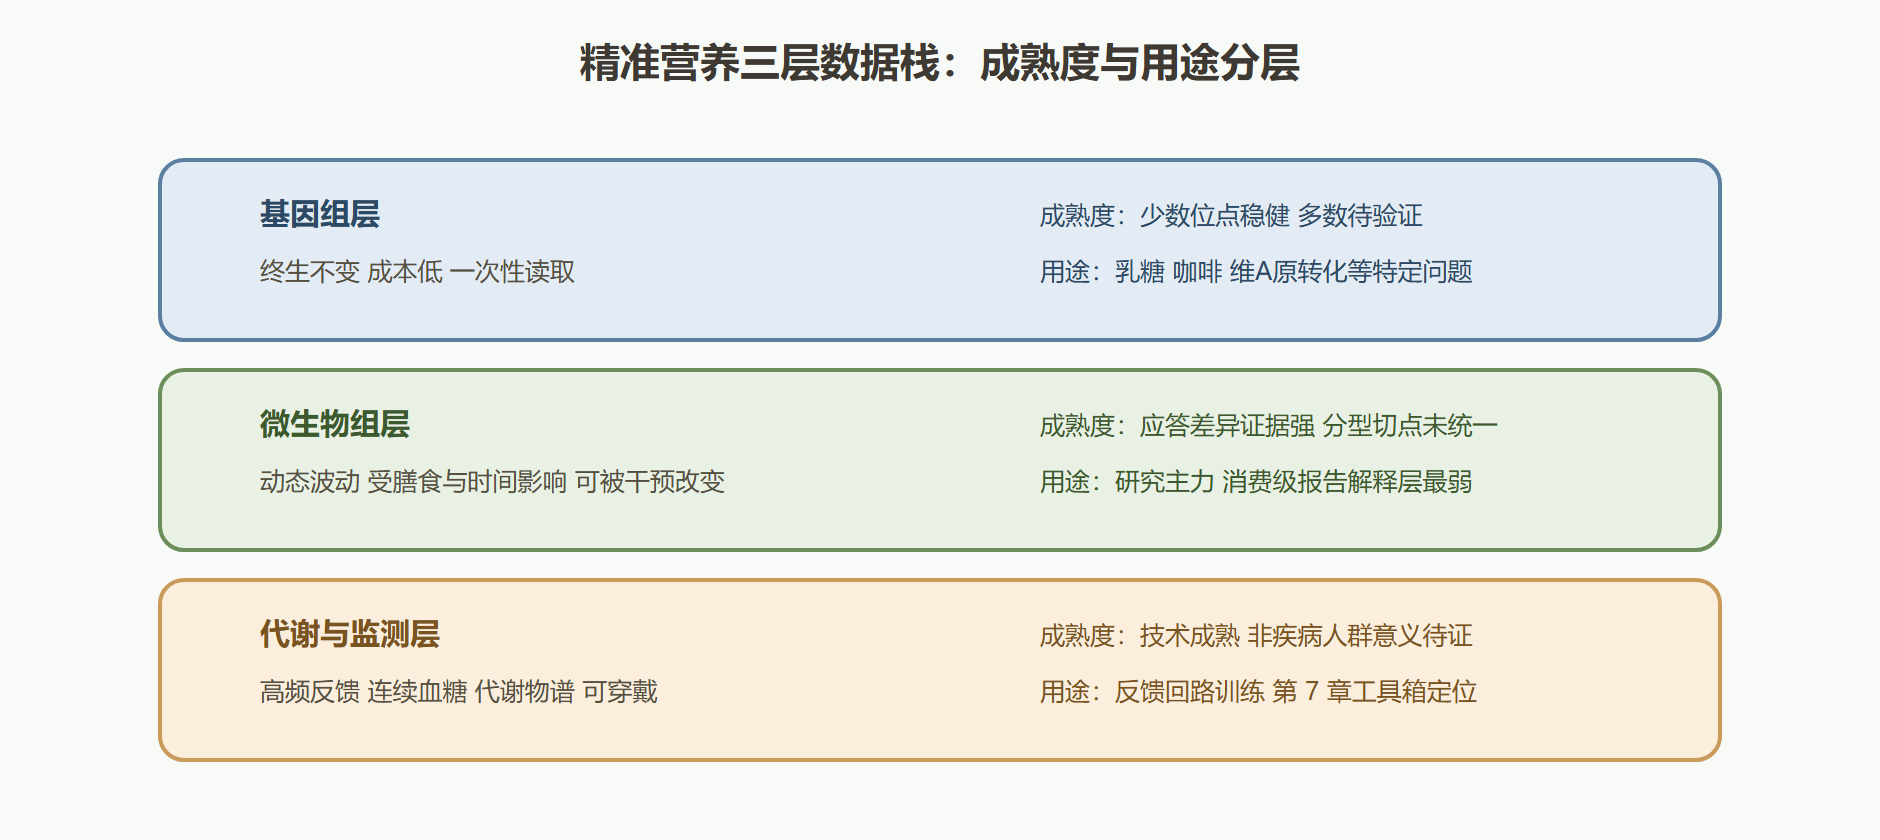
营养基因组学跑了几十年,经受住重复验证的位点其实不多——这本身是重要的审计信息。稳健清单的代表成员:
- 乳糖酶持续性:调控区多态性决定成年后乳糖酶是否持续表达,基因型与不耐受症状的对应关系清楚——这是"基因指导食物选择"的最干净案例;
- 咖啡因代谢(CYP1A2):慢代谢型个体的咖啡摄入与心血管风险指标的关联在部分队列中更明显——但效应量与建议修改远未到临床级;
- 叶酸代谢(MTHFR 常见变异):影响叶酸状态与同型半胱氨酸水平,但"据此加量叶酸"的干预建议仍属个体化医疗范畴,且各指南口径谨慎;
- 维生素D受体与结合蛋白变异:与维生素D状态的个体差异相关,转化建议未定型;
- β-胡萝卜素转化(BCO1):部分变异携带者把植物维生素A原转化为视黄醇的效率显著偏低(第 3 章伏笔的兑现)。
共同边界要说清:这些都是"影响概率的修饰因子",不是"决定命运的开关";多位点叠加的行为指导(吃多少、避开什么)仍缺乏干预试验证明优于通用指南。审计口径:信息真实,行动指导有限。
微生物组层:差异的来源与解释的限度
微生物组研究解释了个体餐后应答差异的重要份额——同一份标准餐,不同人的血糖曲线天差地别,菌群特征进入预测模型(第 1 章已铺垫)。但解释层的限度同样醒目:菌群组成在同一人身上随时间与膳食波动;不同研究间的可复现性受方法学差异拖累;消费级检测报告给出的"菌群分型"缺乏统一的临床切点,同一样本在不同公司可以拿到不同结论(第 7 章审计档案)。研究向应用迁移的真正瓶颈不是测序,而是纵向验证——需要在时间里证明"按菌群调整膳食"优于"按通用指南调整"。
图:精准营养的三层数据栈
转化距离:对照试验泼来的冷水
个体化营养的旗舰对照研究给出的结果克制而一致:算法定制的膳食建议在餐后血糖控制等过程指标上优于通用建议,幅度中等;但对临床结局的影响、对长期依从性的影响,证据仍在积累。换句话说——个性化方案目前的优势,还没有跑赢"把通用指南认真执行"这个便宜的对照。审计结论不否定方向,只校正预期:为个性化付费的当下理由是好奇与探索,不是确定收益。
消费级报告的逐层审计
拿到一份直测基因或菌群报告,四层过筛:检测本身合规吗(实验室资质)、位点或分型有验证文献吗(查重复研究而非单篇)、建议改变了什么具体行为吗("少吃精制碳水"人人适用不算个性化)、改了行为后怎么验证有效吗(没有反馈设计的建议是开环的)。四层筛完,多数报告的净信息量会缩水到一两页——这不是坏消息,而是把钱花在刀刃上的过程。
💡 关键直觉:个体差异的正确用法是"校准",不是"推翻"。基因素养告诉你的应该是通用建议里哪个变量对你权重更高(比如慢咖啡代谢型把咖啡因摄入管理得细一点),而不是整套膳食推倒重来。
常见问题快答
基因检测能告诉我该吃什么吗? 目前的信息量比宣传小得多:稳健位点是少数几个修饰因子(乳糖、咖啡代谢、维生素 A 原转化),它们改变的是个别变量的权重,不是整套食谱。把它当"多了解自己一分"可以,当"定制饮食的依据"则花了冤枉钱还可能被误导。
菌群检测呢? 技术上测得准,解释上分歧大——分型切点未统一,同一份样本在不同平台可得出不同"体质"。真正有临床含义的菌群检测集中在特定医疗场景(艰难梭菌感染等),消费级报告按第 7 章的四层筛处理。
未来五年最值得关注的突破是什么? 两个方向概率最高:一是连续监测设备的普及把"应答数据"变成日常可得(价格与舒适度仍在改善);二是大型队列对"个性化优于通用"这个关键命题的正面检验陆续出结果。在那之前,通用证据加个体校准仍是最优策略。
为什么营养学的"未来"总是慢半拍? 因为它的验证周期被人体寿命锁定:慢性结局要随访多年,中间还要对抗依从性与混杂。这不是学科无能,是研究对象决定的物理约束——所以"新突破"新闻永远比可用结论跑得快,读者需要按金字塔给新闻降速。
多组学报告一起买更划算吗? 商业打包(基因加菌群加微量元素)的折扣感建立在"都测了更全面"的直觉上,但证据链的短板在解读与行动层,不在数据层——多买数据不解决行动依据的问题。先明确要回答的具体问题(我乳糖耐受吗、我的维生素 D 状态如何),再决定买哪一层的数据,问题导向永远比数据导向省钱。
表观遗传检测("生物年龄")值得做吗? 目前不值得按其行动:甲基化时钟的研究价值真实,但商用报告的算法不透明、个体内波动大、且没有任何干预试验以"甲基化年龄"为终点证明某种饮食方案有效。把它归入"有趣的科研指标、暂不构成行动依据"一栏,等它自己长出证据再说。
普通人现在能为精准营养时代做什么准备? 三件事低成本且确定有回报:把基线数据留好(定期体检的指标纵向序列,是未来任何个性化方案的校准基准)、保持记录能力(三天膳食记录的技能不过时)、对数据交易保持克(第 9.3 节)。技术的红利从来优先降临在有准备的人身上——而准备的成本,今天几乎为零。
营养组学数据与临床决策的距离在哪? 差一座"行动验证"的桥:从数据特征到膳食建议再到健康结局的整条链路,需要在随机对照里跑完整。第 5 章的证据金字塔同样适用于技术本身——技术再新,也要按层级排队进临床。
要点回顾
- 稳健的营养基因位点屈指可数:乳糖酶最干净,咖啡与叶酸代谢次之,多数仍在研究层;
- 微生物组解释应答差异证据强,分型与报告的解释层最弱;
- 对照试验显示个性化方案暂未跑赢"认真执行通用指南";
- 消费级报告四层筛:合规、验证、行为增量、反馈设计;
- 个体差异用于校准权重,不用于推翻通用证据。
下一节把镜头拉到行星级尺度:你的餐盘与全球食物系统在同一个方程里。